本章内容
- 理解大语言模型
- 使用 Prompt Engineering 控制 LLM
- 使用 OpenAI Agents SDK 构建 Agent
- 通过工具集成增强 Agent 能力
现在,我们正式开始动手构建 Agent。上一章介绍了 Agent 的整体概念——一种能够自主思考、并代表用户执行任务的智能系统。而在本章中,我们将深入了解构成 Agent 的几个基础组件,包括:
- 作为“大脑”的大语言模型;
- 用于引导模型推理过程的提示工程;
- 负责组织和管理整个 Agent 的 OpenAI Agents SDK。
可以把这一章看作是在搭建 Agent 的核心架构。在把这些组件连接成一个完整系统之前,我们会先分别理解它们各自的工作原理,以及它们在 Agent 中承担的职责。完成本章学习之后,你将能够亲手搭建一个 Agent 的基础框架,并掌握将一个普通的大语言模型从“能够回答问题的助手”升级为“能够完成真实任务的智能 Agent”所需的核心技术。
2.1 理解大语言模型
如今,大语言模型已经成为 AI 领域最重要、也是应用最广泛的基础技术。随着它们不断与 Agent 相结合,我们越来越能够看到这种组合所带来的巨大能力提升。本书后续的所有 Agent 示例,也都将建立在 LLM 的基础之上。
虽然很多人仍然把 LLM 看作一个“黑盒”。事实上,我们或许还无法完全解释模型内部为什么能够产生如此强大的智能,也无法彻底理解其内部推理机制。但对于开发者而言,我们已经掌握了足够多的知识,可以充分发挥它们的能力,并利用它们构建各种 Agent 和 Agent 系统。下一节中,我们将进一步了解大语言模型如何作为 Agent 的核心“大脑”,以及它们如何支撑未来各种 Agent 与多智能体系统的运行。
2.1.1 LLM:基于概率预测 Token 的机器
从最底层来看,大语言模型(LLM)的工作原理其实非常简单:读取文本,然后根据已经学习到的概率,预测接下来最可能出现的文本。由于机器学习模型本身并不能直接理解自然语言,因此在输入模型之前,文本首先需要经过分词处理。分词器会将文本拆分为一个个 Token,并根据模型词汇表中的位置,将每个 Token 转换为对应的数字(Token ID)。随后,这一串 Token ID 会作为模型输入。 模型接收这些 Token 后,并不会直接输出一句完整的话,而是计算整个词汇表中每一个 Token 成为“下一个 Token”的概率分布。也就是说,模型会为词汇表里的每个 Token 都计算一个概率分数,用来表示它成为下一个输出 Token 的可能性。
真正决定最终输出哪个 Token 的,并不是模型本身,而是后续的采样过程。采样算法会根据模型给出的概率分布,从所有候选 Token 中选择一个作为最终输出。这一点非常重要。对于同样的输入,模型计算得到的概率分布始终是相同的,而最终输出什么,则取决于采用哪种解码策略,例如:
- Greedy Decoding(贪心解码)
- Top-k Sampling
- Nucleus Sampling(Top-p Sampling)
不同的采样策略,即使面对相同的概率分布,也可能得到不同的输出结果。
图 2.1 展示了 LLM 的训练过程以及推理/生成过程。
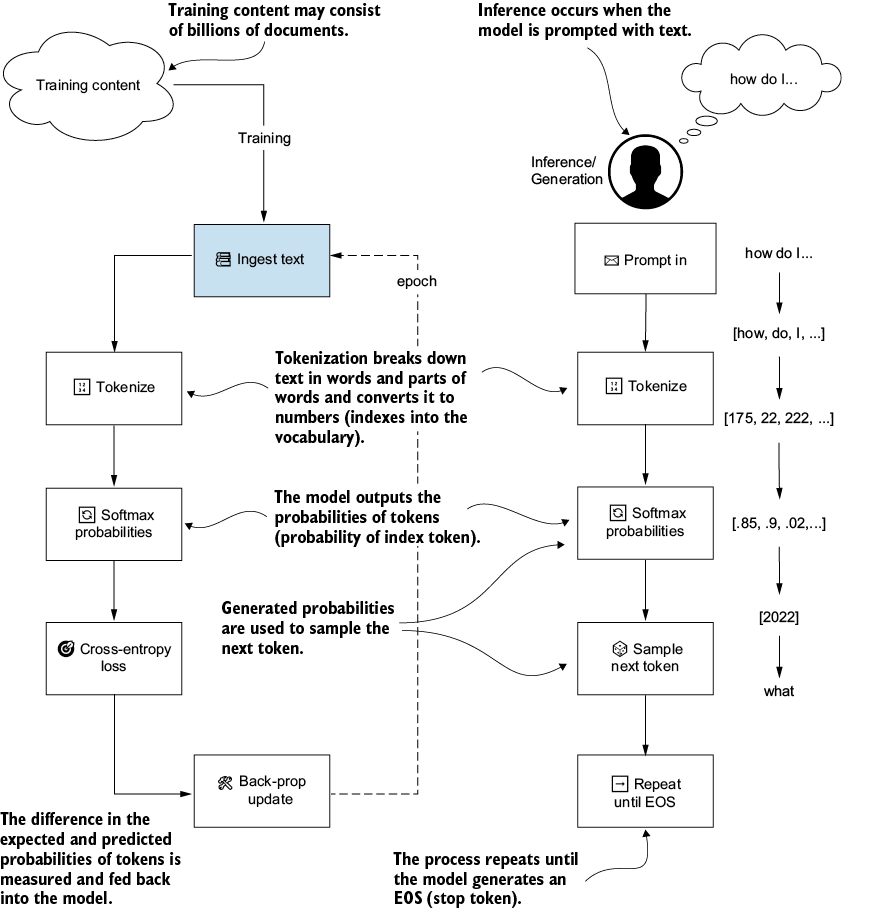
图 2.1 大语言模型的训练流程与推理流程。左侧展示模型训练阶段:系统不断读取海量文本数据,对模型进行训练;右侧展示推理阶段:用户输入 Prompt,文本首先经过 Tokenization 转换为 Token,然后输入模型,模型计算下一个 Token 的概率分布,并通过采样生成最终输出。
如图所示,在训练阶段,模型会不断读取来自各种数据源的大量文本。训练的目标始终只有一个:预测下一个最可能出现的 Token。每完成一次预测,模型都会将预测结果与真实答案进行比较,并计算两者之间的误差。这里的误差表示模型预测结果与真实 Token 之间存在多大的差距。随后,这个误差会反馈给模型,用来调整模型内部参数,使下一次预测更加准确。这一参数更新过程称为反向传播。简单来说,反向传播就是根据计算得到的 Loss,不断调整模型内部权重,从而逐渐提高预测准确率。实际上,一个大型语言模型在训练过程中会经历数十亿次甚至更多这样的迭代,并学习海量文本中的语言规律。
完成基础训练(Base Training)之后,模型通常还需要进入一个独立的对齐阶段。目前最常见的方法是基于人类反馈的强化学习(RLHF)。需要特别说明的是:RLHF 并不会让模型学到新的知识,也不会直接提升模型的推理能力。它真正负责的是:
- 学会遵循用户指令;
- 生成更符合人类偏好的回答;
- 避免输出有害或不安全内容。
真正提升模型推理能力的,则来自其他训练方法,例如:Chain-of-Thought Fine-tuning(思维链微调)、和Process Reward Model(过程奖励模型)。
经过上述训练之后,一个大语言模型便能够接收 Token 序列作为输入,并计算每个候选 Token 的概率分布。当采样算法选择出一个 Token 并输出之后,模型又会基于新的上下文重新计算下一步的概率分布。这一过程不断重复,直到模型生成 EOS(End of Sequence / End of Stream) Token,表示文本结束,整个生成过程才会停止。
由于推理阶段速度非常快,Token 会一个接一个不断输出,因此人们往往会产生一种模型“正在思考”的错觉。事实上,LLM 做的事情始终只有一件:一次预测一个 Token。之所以这些预测能够如此准确,并不是因为模型内部保存了一张庞大的“知识表”。Transformer 并不会像数据库一样存储知识。模型真正的能力来源于训练过程中学习得到的大量参数。这些参数主要分布在 Attention层和Feedforward / MLP层。它们共同构成了模型数十亿甚至数千亿个参数。每一次推理时,输入都会经过这些网络层重新计算,形成新的内部表示(Internal Representation),然后输出当前上下文下的下一个 Token 概率分布。也就是说,模型每生成一个 Token,都需要重新执行一次完整的前向计算。它并不是查找某张知识表,而是利用训练过程中学习得到的参数,在当前上下文基础上重新计算最合理的预测结果。
注: 现代大语言模型在完成基础训练之后,通常都会经过一个 Alignment(对齐)阶段,例如采用 RLHF。需要再次强调的是,RLHF 并不会提升模型的推理能力,它主要负责让模型更好地理解用户指令,并以更加自然、符合人类偏好的方式进行交流。真正提升推理能力的方法通常包括 Chain-of-Thought Fine-tuning 等训练技术。如果希望进一步深入了解微调(Fine-tuning)与 RLHF,推荐阅读 Sebastian Raschka 所著的 Build a Large Language Model (From Scratch)(Manning,2024)。
本节最重要的结论是:LLM 的本质是一台基于概率预测 Token 的机器。因此,在设计 Prompt、构建 Agent 时,我们始终需要围绕 Token 以及 Token 概率预测来思考。不过,在继续学习 Prompt Engineering 之前,我们还需要先弄清楚一个最基本的问题:什么是 Token?
2.1.2 什么是 Token?
在介绍大语言模型时,我们经常会提到**分词(Tokenization)**这一概念。所谓 Tokenization,就是将一段文本拆分成 LLM 能够处理的一个个较小单元(Token)的过程。这些 Token 可以是:
- 一个完整的单词;
- 一个单词的一部分;
- 标点符号;
- 特殊字符;
- 甚至是空格或换行符。
完成分词之后,每个 Token 都会根据模型词汇表中的位置,被转换为对应的数字索引(Token ID)。随后,这些 Token ID 会作为模型输入。模型根据这些输入计算下一个 Token 的概率分布,再经过采样,输出预测得到的下一个 Token。
图 2.2 展示了普通文本与 JSON 文本在 Tokenization 后的差异。
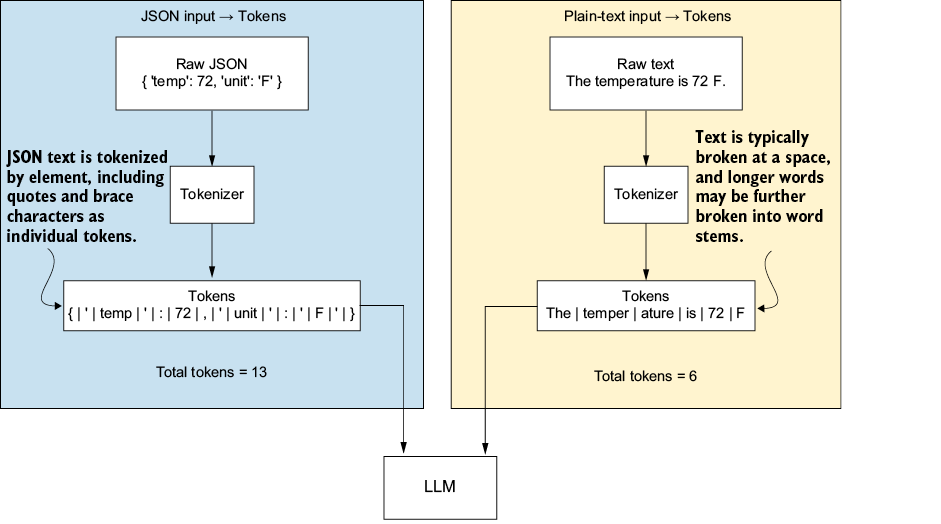
图 2.2 普通文本与 JSON 文本的 Token 化对比。
从图中可以看到:相同含义的数据,JSON 格式最终被切分成了 13 个 Token,而对应的自然语言文本仅被切分成 6 个 Token。
这说明:文本字符长度并不能直接反映 Token 数量。原因在于,JSON 中的大量结构信息,例如:
- 花括号
{ } - 引号
" - 字段名称(Field Name)
- 冒号
: - 逗号
,
都会被当作独立 Token 进行编码,因此即使表达的是相同的信息,JSON 往往会消耗更多 Token。当然,这并不意味着我们就不应该在 Prompt 中使用 JSON,也不意味着 JSON 不适合用于 LLM 之间的数据交换。它只是说明:JSON 在 Token 数量和上下文开销方面,相比自然语言更加昂贵。如今,大多数主流 LLM 已经能够很好地理解 JSON 格式。不过,在早期模型中,JSON 的处理效果并没有现在这么成熟。
本节最重要的结论是:文本长度并不等于 Token 数量。在实际使用中,各家 LLM 服务商通常都会分别按照输入 Token 和输出 Token 进行计费。而且,大多数模型中,输出 Token 的价格通常比输入 Token 更高,根据模型和服务商不同,一般会高出 2~5 倍。对于普通聊天来说,这种差异可能并不明显。但在 Agent 系统中,一个复杂任务往往会经历多轮推理、多次工具调用以及多个 Agent 协作。一次运行下来,模型处理的 Token 数量很容易达到数百万级别。因此,Token 成本会迅速累积,成为 Agent 系统设计中必须重点考虑的问题。
为了统计文本包含多少 Token,可以使用 Python 中的 tiktoken 等工具。只需要将文本输入 tiktoken,它就会根据对应模型使用的编码方式计算出 Token 数量。此外,本书后续使用的 OpenAI Agents SDK 也会自动统计每次 LLM 调用过程中的输入 Token 数量和输出 Token 数量,方便开发者分析模型成本与性能。
最后,还需要注意一点:通常情况下,输入 Token 越多,模型输出结果的不确定性也越高。这是因为随着上下文不断变长,模型需要综合考虑的信息越来越多,推理难度也随之增加。不过,这种影响并非无法控制。通过合理设计 Prompt,以及后面将介绍的各种模型参数调节方法,我们可以在一定程度上控制 LLM 的输出质量与稳定性。
2.1.3 调整 Temperature、Top-p 等模型参数
影响大语言模型输出结果的,并不仅仅是 Token。我们还可以在调用模型时传入一系列参数,用于控制模型的生成行为。不过,这些参数往往都存在一定的权衡。例如,提高 Temperature(温度) 可以让模型生成更加富有创造力的内容,但与此同时,也可能降低回答的事实准确性。需要注意的是,这里讨论的模型参数,与 API 层面的配置(例如身份认证、重试机制等)并不是一回事。API 配置控制的是如何调用模型,而模型参数控制的是模型如何生成内容。图 2.3 总结了这些常用参数及其作用。
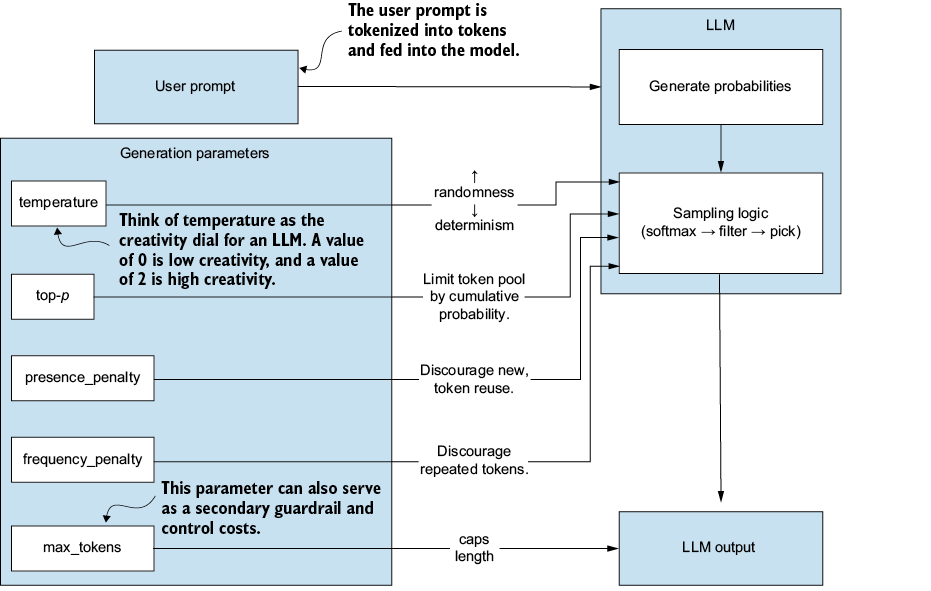
图 2.3 可用于调整 LLM 输出结果的各种参数。图右侧展示了模型预测并采样 Token 的过程;图左侧则展示了可以影响采样过程的各类参数。
图右侧实际上是图 2.2 中「预测」和「采样」过程的放大版。所谓采样,就是模型根据刚刚计算出的 Token 概率分布,最终选择其中一个 Token 作为输出的过程。诸如:
- Temperature
- Top-p(Nucleus Sampling)
- Presence Penalty
- Frequency Penalty
这些参数都会影响模型最终选择哪个 Token。而 Max Tokens 则有所不同。它并不会影响 Token 的选择,而是限制模型一次回复最多能够生成多少个 Token。
表 2.1 更详细地总结了这些参数及其作用。
表 2.1 LLM 常用参数及其作用
| 参数 | 常见范围 | 实际作用 | 什么时候调高 / 调低 |
|---|---|---|---|
| Temperature | 0~2(默认约为 1) | 在采样前调整所有 Token 的概率分布。值越高,概率分布越平坦,输出越随机、越有创造力;值越低,输出越稳定、越确定。 | 创意写作、头脑风暴时提高;代码生成、事实问答时降低。 |
| Top-p(Nucleus Sampling) | 0~1(默认约为 1) | 仅保留累计概率达到 p 的那部分候选 Token,再重新归一化并进行采样,从而避免选择概率极低的 Token。 | 小于 0.9 时更聚焦主题;接近 1 时更自由、更发散。 |
| Max Tokens | 1~8192+(取决于模型) | 限制模型本次回复最多生成多少 Token。(Prompt Token + Max Tokens 不得超过 Context Window。) | 设置略高于预期回复长度即可,可避免输出过长并降低成本。 |
| Presence Penalty | -2 ~ +2 | 当某个 Token 已经出现后,对其增加惩罚,从而鼓励模型引入新的主题。 | 一般设置为 0.6~1.0,可减少重复讨论同一内容。 |
| Frequency Penalty | -2 ~ +2 | 根据 Token 已出现的次数增加惩罚,从而减少词语或句子的重复。 | 一般设置为 0.2~0.8,可减少长文本中的重复和循环输出。 |
不同类型的 Agent,通常会采用不同的参数配置。例如,一个代码生成 Agent要求输出尽可能准确且稳定,因此通常会:
- 将 Temperature 设置为 0;
- 使用较低的 Frequency Penalty,让括号、关键字、变量名等代码元素能够自然重复。
而一个创意写作 Agent则可能会:
- 将 Temperature 提高到 2;
- 设置较高的 Presence Penalty,鼓励模型不断提出新的想法,而不是围绕已有内容反复展开。
不过,需要理解的是:这些参数只是影响模型的生成倾向,而不是施加绝对限制。例如,将 Temperature 设置为 0,并不能保证模型每次都一定输出完全相同的结果。此外,有些参数之间还会相互影响。例如,同时调整 Temperature 和 Top-p 时,两者共同作用可能会导致模型行为变得难以预测。因此,包括 OpenAI 在内的许多模型提供商都建议:通常只调整 Temperature 或 Top-p 其中一个,而不要同时修改两者。
在绝大多数实际开发场景中,你真正需要频繁调整的参数其实只有两个:Temperature(根据 Agent 的角色调整创造力)和 Max Tokens(限制输出长度)。合理设置 Max Tokens 有几个明显的好处:
- 控制回复长度;
- 降低 Token 成本;
- 防止模型生成过长、偏离主题的回答,起到一定的安全保护作用。
此外,还有一个值得了解的参数——Seed(随机种子)。如果保持以下条件完全一致:
- Prompt 相同;
- Seed 相同;
- 模型参数相同;
那么模型通常会生成完全一致的输出。这一特性对于调试、性能评估以及结果复现都非常有帮助。除此之外,大多数参数通常保持默认值即可。在实际开发中,我们更多依赖提示工程来控制模型行为,而不是频繁调整各种模型参数。接下来,我们将正式进入 Prompt Engineering 的内容,学习如何通过精心设计 Prompt,引导模型完成复杂任务。
2.2 使用提示工程控制 LLM(Agent Persona)
有些人认为,提示工程只是围绕大语言模型炒作出来的概念。事实上,情况恰恰相反。Prompt Engineering 是让 Agent 更加稳定、更加高效、降低运行成本,并减少意外行为的关键技术。
随着模型能力不断提升,提示工程的具体方法也在发生变化。现代 LLM 的能力远远超过早期模型,很多过去需要精心设计 Prompt 才能完成的任务,如今已经能够自然处理。不过,其核心原则始终没有改变:
编写清晰、结构化、可执行的 Prompt,使 Agent 能够稳定、可靠地完成任务。
正如第 1 章所介绍的那样,Persona 或 Prompt 是 Agent 最核心的功能层,而 Prompt Engineering 则是设计好这一层的具体实践。
2.2.1 应用 Prompt Engineering 的核心技巧
不同的大语言模型,在 Prompt 的措辞、关键词以及表达风格上可能存在一些差异。但是,有一些 Prompt 技巧几乎适用于所有主流模型。之所以如此,是因为这些技巧利用了大多数模型训练过程中共同形成的基本规律。遵循这些原则,我们不仅能够写出效果更好的 Prompt,还能构建具有较强通用性的 Agent,使其能够在不同 LLM 之间迁移,而无需重新设计 Prompt。
表 2.2 总结了 Prompt Engineering 中最重要的几项技巧,并说明了它们如何应用到 Agent 的 Persona(系统提示)中。
需要说明的是,这里介绍的是通用 Prompt Engineering 方法。其中有些技巧,例如定义固定输出格式,在本书后续示例中可能不会频繁使用,因为 OpenAI Agents SDK 已经能够自动完成结构化输出。
表 2.2 Prompt Engineering 的核心技巧
| 技巧 | 说明 | Prompt 示例 | 在 Agent 中的作用 |
|---|---|---|---|
| 明确指定角色 | 明确告诉模型应该扮演什么角色,从而确定专业术语、语气和回答深度。 | “你是一位资深 DevOps 工程师,请分析下面的 Docker 错误……” | 只需修改 Persona,即可快速切换为研究员、评论员、规划师等不同 Agent,而无需修改代码。 |
| 将指令放在最前,并使用分隔符 | 将任务要求放在 Prompt 开头,并使用特殊标记分隔不同内容。 | Task: 总结以下文章,不超过 100 字。 Article: …… |
这是 Agent 开发中的最佳实践,应始终采用。 |
| 尽可能具体、详细 | 明确说明目标、长度、受众、语气等要求。 | “写一篇 200 字左右的 LinkedIn 帖子,语气友好,并包含两个可执行建议。” | 可以避免 Agent 输出内容过长、风格不符或偏离目标。 |
| 明确规定输出格式 | 指定 JSON、CSV、Markdown 等固定输出结构。 | { "title": "", "key_points": [], "cta": "" } |
OpenAI Agents SDK 支持结构化输出,因此本书示例中一般无需手动实现。 |
| 提供 Few-shot 示例 | 提供几个输入输出示例,让模型学习期望行为。 | Input: "Free Bitcoin!!!" → Spam;Input: "Team lunch?" → Not Spam |
Agent 可结合向量数据库,在运行时动态检索类似案例,实现自适应 Prompt。 |
| 使用思维链处理复杂推理 | 引导模型逐步思考,再输出最终答案。 | “请一步一步分析……最后只输出最终结果。” | 可以生成可审计的推理过程,方便 Critic Agent 或 Verifier Agent 进行检查。 |
| 强调应该做什么 | 与其告诉模型不要做什么,不如明确告诉它应该怎样做。 | “请使用高中生能够理解的语言。”(优于“不要使用专业术语。”) | 正向指令能够降低违规率,提高 Agent 的稳定性。 |
| 消除歧义 | 将模糊要求改为具体数字或限制。 | “总结为 3~4 个要点,总字数不超过 50 字。” | Guardrail 可以自动检查长度、数量等要求,不符合时自动重试。 |
| 选择合适的模型与参数 | 根据任务选择模型及 Temperature、Max Tokens 等参数。 | model=gpt-4o,temperature=0.7,max_tokens=300 |
在成本、响应速度和推理能力之间取得平衡。 |
| 不断迭代优化 | 将每次模型输出作为反馈,不断优化 Prompt。 | 每次运行记录 Prompt 和输出,根据结果不断调整,直到达到预期效果。 | 可结合日志、格式修正 Agent 或 Fine-tuning,构建持续自我优化的 Agent 系统。 |
接下来的代码清单 2.1展示了一个较为完整的研究型 Agent的 Prompt 示例。按照当前 Prompt Engineering 的最佳实践,这个 Prompt 使用了 Markdown 进行格式化,并通过不同的分隔符划分各个功能区域。虽然这些 Markdown 标记和分隔符会额外消耗一些 Token,但由于 Prompt 的结构更加清晰、层次更加明确,因此通常能够换来更加稳定、一致且高质量的模型输出,整体收益远远超过增加的 Token 开销。
Prompt 缓存
在高并发的生产环境中,Prompt 的组织方式不仅会影响模型输出质量,还会直接影响运行成本和响应延迟。目前,大多数 LLM 服务提供商都支持 Prompt 缓存。它们通常会缓存 Prompt 中保持不变的部分,例如:
- System Prompt(系统提示)
- Persona(角色设定)
- Tool Definitions(工具定义)
当后续请求再次使用这些相同内容时,模型可以直接复用缓存,而无需重新处理。对于命中缓存的部分,服务商通常只收取原输入 Token 成本的一小部分费用。因此,一个重要的实践原则是:
将稳定不变的内容放在 Prompt 的前面,将每次都会变化的动态内容放在后面。
这样能够最大限度提高缓存命中率。在一些高频调用的场景下,这种方式甚至可以将输入 Token 成本降低约 90%。
代码清单 2.1 研究型 Agent Prompt 示例
You are an **expert Research AI Librarian** who excels at web-search synthesis. #1
**Task:** Find the five most relevant, recent articles. #2
**Query:** <<<Q
"<user query here>"
Q>>>
Audience: technology analysts
Recency: **last 30 days**
Max summary length: **≤150 words** #3
Input: "quantum-dot solar cells breakthroughs" #4
Desired Output (one article sample):
• **Next-Gen Quantum-Dot Cells Hit 20% Efficiency**
https://example.com/qdot20
2025-03-10
• Novel ligand swap boosts charge transport;
Scalable roll-to-roll fabrication;
Experts predict sub-$0.20/W cost by 2028 #4
**Think step-by-step silently**
(do NOT reveal reasoning) before answering. #5
**Use clear, non-jargon language.** #6
- Exactly **5** articles.
- Each summary **≤150 words**
- Only HTTPS, non-paywalled sources. #7
对应的 Prompt Engineering 技巧如下:
| 标记 | 对应技巧 |
|---|---|
| #1 | 明确指定角色 |
| #2 | 将任务放在最前,并使用分隔符 |
| #3 | 描述具体且详细 |
| #4 | Few-shot 示例 |
| #5 | 使用思维链 |
| #6 | 使用正向指令 |
| #7 | 消除歧义 |
除了表 2.2 和代码清单 2.1 中介绍的各种技巧之外,还有一个同样重要的因素,那就是Prompt 的整体结构。LLM 在训练过程中接触过大量不同格式的数据。其中,结构清晰的数据更容易被模型理解,也更容易进行评估和误差反馈。因此,结构化 Prompt 往往能够带来更加稳定、更高质量的输出。归根结底,一个好的 Prompt 应该这样去思考:
把自己当成即将阅读这个 Prompt 的 LLM。
或者正如下一节所介绍的那样——学会像一个 LLM 一样思考。
2.2.2 像 LLM 一样思考
关于如何编写高质量 Prompt,一个经常被提到的比喻是:
把 LLM 当作一位刚刚入职的新员工。
这里的新员工可以是:
- 新来的程序员;
- 新研究员;
- 新编辑;
- 新文案;
- 或任何缺乏相关背景经验的人。
当然,这并不是说你需要为模型编写一本操作手册。而是意味着:
不要默认它知道你的想法。
你需要尽可能避免模糊表达,并清晰、具体地描述任务要求。例如,与其写:
写一个时间旅行故事。
不如写成:
写一个关于时间旅行的故事,主人公回到 1921 年,全文不超过 五个段落,使用第一人称叙述,并采用幽默、轻松、富有吸引力的写作风格。
这样的 Prompt,模型更容易准确理解你的意图。除此之外,你还可以进一步告诉 Agent:执行任务时应该如何思考。例如:
在执行任务 X 时,请始终同时考虑 Y 和 Z。
一般情况下,LLM 会按照这样的要求组织自己的推理过程。如果再进一步,你甚至可以直接在 Prompt 中描述整个工作流程。不仅包括具体任务,还可以加入:
- 判断条件
- 分支逻辑
- 执行顺序
现代 Agent 往往都能够按照这些描述完成整个流程。
图 2.4 展示了一个搜索研究员的完整工作流程,以及如何将这种流程转化为 Prompt。
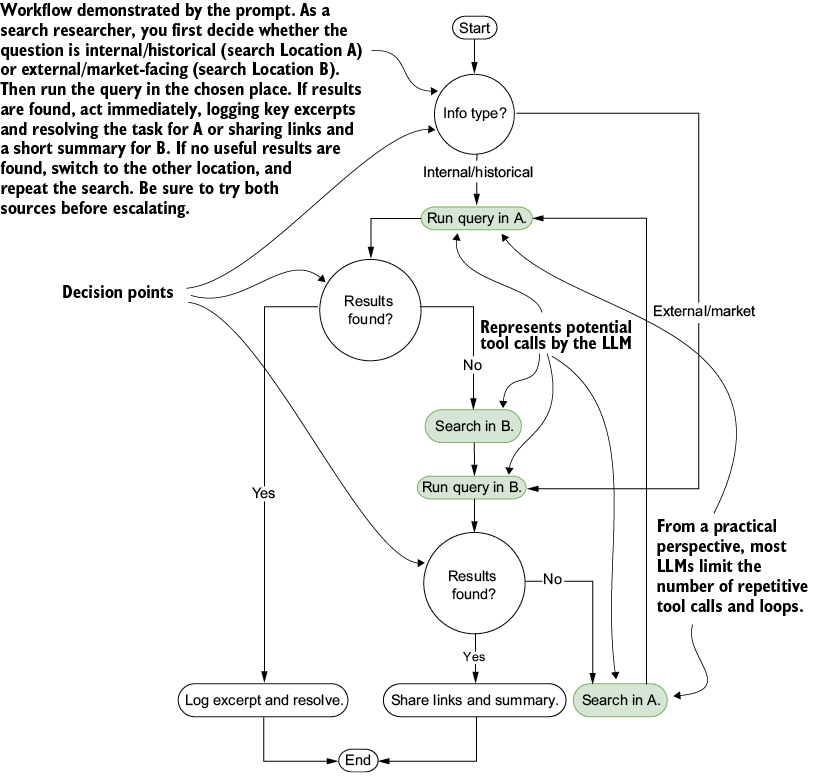
图 2.4 一个较为复杂的搜索研究工作流示例。图中展示了一系列任务、决策节点(圆形)以及任务之间的执行流程。(该示例刻意设计得较复杂,仅用于演示如何将复杂流程转换为 Prompt,并非实际生产环境中的推荐复杂度。)在这个示例中,Agent 不仅需要依次完成多个任务,还需要根据每一步的执行结果不断做出新的决策。需要说明的是,图中的具体业务流程并不是重点。作者只是希望通过一个较复杂的例子说明:只要 Prompt 设计得足够清晰,我们完全可以把复杂业务流程转换成自然语言,让 Agent 自动执行。因此,如果第一次阅读这张图感觉有些难以理解,也无需担心。它只是一个为了展示 Prompt Engineering 能力而故意设计得较复杂的教学示例。
在实际应用中,这些任务通常都会对应一次工具调用。LLM 会借助这些工具:
- 执行具体操作;
- 查询外部信息;
- 获取新的上下文。
虽然我们可以在 Prompt 中描述循环逻辑,但需要注意的是,普通 LLM 往往不会无限循环执行任务。通常尝试 3 次以内,模型就会结束循环。而真正的 Agent 则不同。Agent 会持续执行「感知 → 规划 → 行动 → 学习循环,直到它认为已经成功完成目标,或者确认目标无法完成。
接下来的代码清单 2.2将展示:如何把图 2.4 中的整个工作流程,转换成一份完整的 Agent Prompt。这份 Prompt 不仅包含:
- 决策逻辑;
- Few-shot 示例;
- 最终输出要求;
还将所有内容组织成了一份简洁、结构清晰的 Prompt。阅读这份 Prompt 时,可以尝试把自己当作图中的搜索 Agent。按照 Prompt 中的指令一步一步执行任务,你就能更加直观地理解 Prompt Engineering 是如何驱动 Agent 完成复杂工作的。
示例 2.2 搜索工作流
You are an **Internal Knowledge Search Agent** who decides #1
the best data source and delivers concise, actionable findings. #1
**Task:** Choose the correct location (A = internal KB, B = public web) #2
based on the query, run the search, and summarise the outcome. #2
**Query:** <<<Q
"<user question here>"
Q>>>
Audience: support engineers · Tone: clear and neutral · Time-box each search #3
to **3 minutes** · Max summary length: **≤ 120 words**. #3
Example 1 #4
Input: "Where is the 2023 API rate-limit doc?" #4
Chosen Location: **A** #4
Outcome: Found → Provided link and excerpt (110 words). #4
#4
Example 2 #4
Input: "Latest competitor pricing for mid-tier plan" #4
Chosen Location: **B** #4
Outcome: Found → Shared three URLs with bullet summary (118 words). #4
**Think silently step-by-step first** (do NOT reveal reasoning) to pick the #5
location and craft the summary. #5
**Use plain language**; emphasise next steps for the engineer. #6
- Exactly **one** chosen location (A or B). #7
- **If results found:** include up to **3** bullet points.
- **If no results in first source:** switch to the other location once; if still none, respond "Escalate".
说明:
- #1 角色:定义 Agent 的身份和职责。
- #2 决策路径:明确存在两条不同执行路线(内部知识库 / 公网搜索)。
- #3 精确约束:使用具体指标(时间、长度等)约束任务。
- #4 Few-shot 示例:提供输入、决策和输出示例,帮助模型学习行为模式。
- #5 思维链:允许模型先进行内部推理,再输出最终答案。
- #6 正向指令:告诉模型应该怎么做,而不是不要做什么。
- #7 输出规范:统一结果格式,减少工作流复杂度。
刚开始写这种 Prompt 可能会觉得不太自然,因此让 LLM 帮你编写 Prompt 也是一种不错的方法。实际上,让 LLM 帮你写 Prompt,本身就是练习 Prompt Engineering 的有效方式。不过,Prompt 编写也有很多容易踩坑的地方。下一节将介绍一些常见错误,以及编写 Prompt 时应该避免的做法。
2.2.3 避免常见的 Prompt 编写误区
表 2.3 总结了在为 Agent 编写 Prompt 时,由于过度设计而经常遇到的一些问题。
表 2.3 Prompt 过度设计时的常见问题
| 问题 | 描述 | 解决方案 |
|---|---|---|
| Prompt 过于复杂 | 一个过长、涉及多个主题的 Prompt 容易占满 LLM 的上下文窗口,增加 Token 成本,并导致指令之间相互冲突。 | 将 Prompt 拆分成多个针对不同角色或步骤的小 Prompt。每一步只完成一个明确目标,再将结果交给下一步处理。 |
| 指令互相矛盾 | Prompt 中存在冲突的要求,例如同时要求"简洁回答"和"详细解释",模型只能猜测到底该遵循哪条规则。 | 像模型一样完整阅读 Prompt,删除或修改冲突的指令。使用项目符号(Bullet List)明确各项要求的优先级。 |
| Prompt 过于简单 | 过于简单的 Prompt 会导致模型频繁进行多轮交互和网络调用,从而增加延迟和成本。 | 将相关的小任务合并成一个更丰富的 Prompt,或者赋予 Agent 一定的自主决策能力(例如调用工具、Function Calling),让它能够自行处理分支逻辑。 |
| 分隔符不一致 | 在同一个 Prompt 中混用 """..."""、<<<...>>>、Markdown 代码块等不同分隔方式,容易让模型和后续解析程序产生混淆。 |
每个 Prompt 统一采用一种分隔符格式(例如 <<<BLOCK ... BLOCK>>>),并作为团队规范固定下来。 |
| 约束过多 | 在一个 Prompt 中塞入几十条规则和限制,会导致 Prompt 变得冗长,反而增加模型忽略部分规则的概率。 | 只保留真正重要的约束。如果确实需要很多规则,可以拆分成多个连续 Prompt,或者增加一个 Guardrail(护栏)步骤,对输出进行检查和修正。 |
| 输出不稳定 | 即使 Temperature 设置为 0,相同输入仍然可能得到不同的输出。 | Temperature=0 只能降低随机性,并不能保证完全一致。如果需要稳定输出,应明确指令、统一分隔符,并避免出现互相矛盾的要求。 |
当然,在构建复杂 Agent 的过程中,你还会遇到许多其他需要解决的问题。利用 LLM 帮助你编写或修改 Prompt 往往非常有效,但也要注意不要让 Prompt 变得过于复杂或加入过多细节。最重要的一点是:不要害怕拆分 Prompt。 如果一个"万能 Prompt"已经变得过于庞大或难以维护,把它拆分成多个小任务,通常会得到更好的效果。
现在,我们已经了解了 LLM 的工作原理以及如何通过 Prompt 控制它们。接下来,我们将在下一节把这些知识应用到 Agent 的实际构建中。
2.3 使用 OpenAI Agents 构建 Agent
目前已经有许多用于构建 Agent 的框架,每个框架都有自己实现 Agent 的方式。幸运的是,随着 MCP(Model Context Protocol) 和 A2A(Agent-to-Agent) 等协议的出现,不同框架之间已经拥有了一套共同的基础标准,使 Agent 能够以统一的方式调用工具,并与其他 Agent 协同工作。本书将重点介绍 OpenAI Agents SDK。
OpenAI Agents SDK 是在许多早期 Agent 框架之后推出的,它吸取了前人的经验,因此设计得更加轻量、可扩展和灵活。接下来,我们将基于这一 SDK 构建本书中的所有 Agent,并在下一节开始实现我们的第一个 Agent。
2.3.1 构建一个最简单的 Agent
现在,我们已经了解了 LLM 如何生成 Token,以及 Prompt 如何影响模型输出,接下来就可以将这两部分知识应用到实际开发中。代码清单 2.3 展示了一个研究规划 Agent(Research Planning Agent)的最小示例,它也是我们后续 Deep Research Agent 工作流中的第一步。该 Agent 的职责非常简单:根据用户提供的研究主题,生成一个简洁的五步研究计划。
本书所有示例代码、运行方式以及 Python 环境配置均可在 GitHub 仓库中获取:
代码清单 2.3 01_first_agent.py
from agents import Agent, Runner #1
from dotenv import load_dotenv
load_dotenv() #2
instructions = """ #3
You are a research planning assistant.
**TASK INSTRUCTIONS**
- You will be given a research topic.
- Your task is to provide a plan on how to research this topic.
- Output 5 concise tasks (5 words or less) to your plan.
"""
agent = Agent( #4
name="Research Planner",
instructions=instructions,
)
input = "learn about AI agents" #5
result = Runner.run_sync( #6
agent,
input=input,
)
print(result.final_output) #7
代码说明:
- #1 导入所需的 Python 包。
- #2 从
.env文件加载环境变量(例如 OpenAI API Key)。 - #3 定义 Agent 的 Prompt(系统提示词)。
- #4 创建并配置 Agent。
- #5 指定用户希望研究的主题。
- #6 使用
Runner.run_sync()同步运行 Agent。 - #7 输出 Agent 返回的最终结果。
运行这段代码后,你将看到类似代码清单 2.4 的输出。可以发现,Agent 的回答很好地遵循了 Prompt 中规定的要求。虽然我们还可以进一步丰富 Prompt,使规划更加详细,但作为一个最小可运行示例,这已经是一个不错的起点。
代码清单 2.4 01_first_agent.py 示例输出
1. 阅读学术文献。
2. 学习在线课程。
3. 分析真实应用案例。
4. 研究 Agent 架构。
5. 加入 AI 社区交流。
正如前面所介绍的,不同类型的 Agent 往往需要配置不同的模型以及不同的模型参数。因此,在下一节中,我们将学习如何在创建 Agent 时指定模型以及配置模型参数,以便让不同角色的 Agent 发挥最佳效果。
2.3.2 设置 Agent 使用的模型及其他参数
代码清单 2.5 展示了如何为 Agent 指定模型以及配置模型参数。对于这个研究规划 Agent,我们希望它每次生成的规划都尽可能保持一致,因此将 temperature 设置为 0。当 Temperature 设置为 0 时,模型在生成每一个 Token 时都会选择概率最高的那个 Token,而不是进行随机采样。这样能够使生成的规划结构在多次运行中保持一致,也更方便调试和评估Agent 的行为。除此之外,其余参数均保持默认值,并明确指定了要使用的模型。如果不指定模型,OpenAI Agents SDK 会默认使用当前服务商配置的默认模型。
关于推理模型(Reasoning Models)
OpenAI、Anthropic 等厂商推出的新一代模型通常提供了一个 reasoning_effort 参数(有些平台也称为 thinking 或 reasoning_effort)。这个参数用于控制模型在回答问题之前,愿意花多少"思考时间"进行内部推理。默认情况下,该参数通常设置为 Medium(中)或 High(高)。但对于 Agent 来说,这通常并不是最佳选择。原因在于:Agent 通常会执行大量粒度很小、目标明确的步骤,而 Prompt 和工具本身已经限定了每一步应该完成什么工作。如果每一步都开启高强度推理:
- 会增加响应延迟;
- 会消耗更多 Token;
- 但最终答案通常并不会因此变得更好。
因此,推荐做法是:
- 普通 Agent 步骤:将
reasoning_effort设置为 None 或 Minimal; - 真正复杂的步骤(例如任务规划、复杂工具选择、排查死循环等):再临时提高推理等级。
这样可以保证 Agent 在绝大多数情况下既运行快速,又成本低廉;只有在真正需要深入思考的时候,才让模型投入更多计算资源。
代码清单 2.5 02_setting_agent_model_parameters.py
agent = Agent(
name="Research Planner",
instructions=instructions,
model="gpt-4.1", #1
model_settings=ModelSettings(
temperature=0.0, #2
max_tokens=150, #3
top_p=1.0, #4
frequency_penalty=0.5,
presence_penalty=0.5,
)
)
代码说明:
- #1 明确指定 Agent 使用的模型(这里为
gpt-4.1)。 - #2 将 Temperature 设置为 0.0,提高输出的一致性和可重复性。
- #3 限制模型最多生成 150 个 Token,避免回答过长。
- #4
top_p保持默认值(1.0),其他采样参数也维持默认配置。
当我们多次运行这个 Agent,并使用相同的输入时,就会得到更加稳定的输出,如代码清单 2.6 所示。可以看到,两次运行的结果几乎完全一致,只有第五项任务略有不同。这再次说明:Temperature = 0 能够降低随机性,但并不能保证输出百分之百完全一致。
代码清单 2.6 02_setting_agent_model_parameters.py 输出示例
第一次运行(RUN #1)
1. 阅读 AI Agent 基础文献
2. 了解 AI Agent 最新进展
3. 分析 Agent 架构与框架
4. 学习 Agent 的实际应用
5. 比较不同类型 Agent 的能力
第二次运行(RUN #2)
1. 阅读 AI Agent 基础文献
2. 了解 AI Agent 最新进展
3. 分析 Agent 架构与框架
4. 学习 Agent 的实际应用
5. 比较主流 Agent 开发工具
通常来说,输出越长,发生变化的可能性也越大。如果你的目标是创作内容,这种随机性可能正是你想要的;但对于 Agent 来说,随机性往往还会影响其他方面,例如输出格式、字段顺序甚至执行流程。因此,在构建 Agent 时,我们通常更倾向于获得稳定、可重复且结构化的输出。下一节将介绍如何实现这一点。
2.3.3 控制输入与类型化输出
图 2.5 展示了 Agent 的一个简单工作流,并对比了未使用输入/输出类型与使用类型化输入/输出两种工作方式。当 Agent 使用类型化输出时,它的输出可以安全地作为另一个 Agent 的输入,而不用担心由于回答格式变化导致整个工作流出错。还记得前面提到的吗?LLM 本质上是概率性的 Token 预测器,因此它始终存在输出变化的可能性。通过为输入和输出定义严格的数据类型,我们可以避免因为输出格式变化而导致 Agent 工作流被破坏或产生歧义。
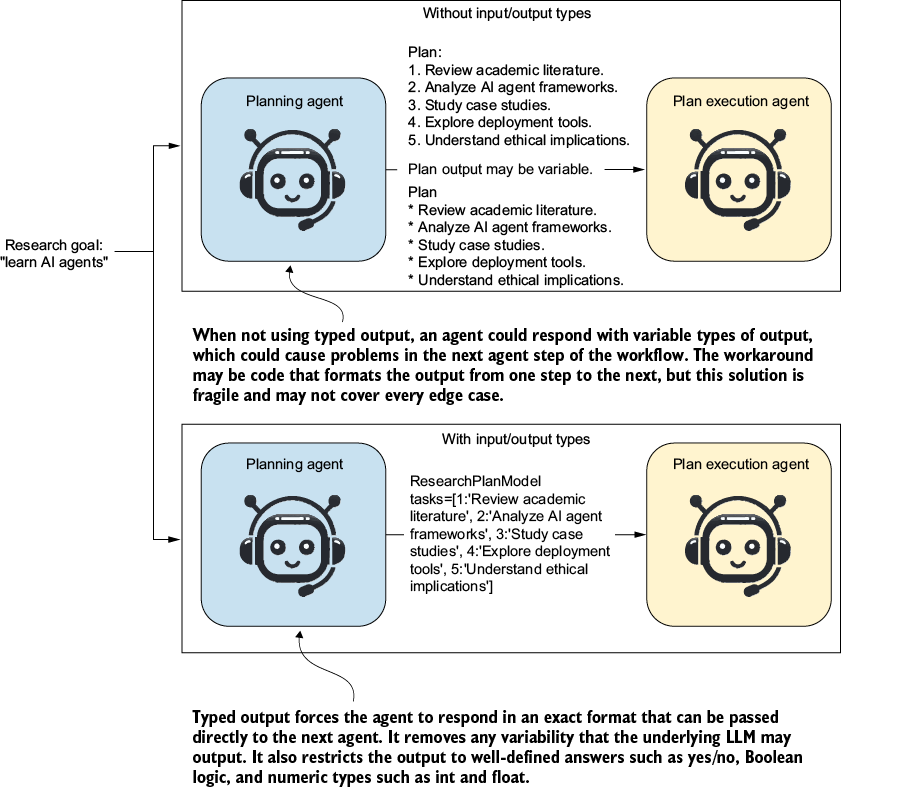
图 2.5 类型化输出与非类型化输出的比较。图中展示了两种 Agent 工作流:上半部分:未使用类型化输出,Agent 可以自由生成任何格式的回答。虽然这样更灵活,但当输出需要传递给下一个 Agent 时,就容易因为格式变化而导致解析失败或工作流中断。下半部分:使用类型化输出,Agent 必须按照预定义的数据结构输出结果。这样不仅降低了输出的随机性,也让后续 Agent 或程序能够稳定地读取和处理数据。
代码清单 2.7 展示了如何修改前面创建的研究规划 Agent,使其支持类型化输出。这里使用了 Pydantic 来定义输出的数据模型。我们希望 Agent 输出的是一个任务列表**。
代码清单 2.7 03_output_types_basic.py
from pydantic import BaseModel #1
class ResearchPlanModel(BaseModel): #2
tasks: List[str]
"""A list of tasks to perform for research."""
agent = Agent(
name="Research Planner",
instructions=instructions,
output_type=ResearchPlanModel, #3
)
示例输出:
tasks=[
'Conduct literature review',
'Identify key AI frameworks',
'Study agent-based models',
'Analyze real-world applications',
'Explore future trends'
]
代码说明:
- #1 导入 Pydantic 的
BaseModel,用于定义数据类型。 - #2 定义一个数据模型,用于保存 Agent 的输出。
- #3 将该数据模型指定为 Agent 的输出类型。
接下来,我们希望每个任务不仅仅是列表中的一项,而是包含更多信息。因此,我们尝试把 List 改成 Dictionary,如代码清单 2.8 所示。
代码清单 2.8 04_output_types.py
from pydantic import BaseModel
class ResearchPlanModel(BaseModel):
tasks: dict[int, str] #1
"""A list of tasks to perform for research."""
agent = Agent(
name="Research Planner",
instructions=instructions,
output_type=ResearchPlanModel,
)
代码说明:
- #1 将原来的任务列表改为了一个字典,键为整数,值为字符串。
运行该代码后,会出现如下错误:
Exception has occurred: UserError
Strict JSON schema is enabled,
but the output type is not valid.
Either make the output type strict,
or pass output_schema_strict=False
to your Agent()
意思是:
当前启用了严格 JSON Schema 校验,但你定义的输出类型并不符合严格 Schema 的要求。
出现这个错误的原因是:你定义的数据类型不够严格,导致底层生成的 JSON 结构可能存在多种形式,因此 OpenAI Agents SDK 无法保证输出一定符合预期。理解这些错误的含义以及如何解决它们,对于开发 Agent 来说非常重要。通常有两种解决方法:
方法一:关闭严格 JSON Schema 校验(不推荐)
可以将输出类型包装成 AgentOutputSchema,并关闭严格模式:
AgentOutputSchema(
ResearchPlanModel,
strict_json_schema=False
)
这样可以绕过严格校验,但意味着模型生成的数据结构可能不稳定,因此官方并不推荐这种做法。
方法二:修正数据模型(推荐)
更好的办法是找出数据模型中不符合严格 JSON Schema 的地方,并进行修改,使其满足 SDK 的要求。如果不知道具体问题在哪里,可以借助 ChatGPT 或 Claude 来帮助分析错误并修改数据模型。这也是官方更推荐的解决方式。
清单 2.9 展示了如何修复这个问题:将导致错误的类型替换为能够保持严格 JSON Schema 的实现。问题的根源在于,dict[int, str] 允许出现额外的属性,因此不符合严格 JSON Schema 的要求。作者的解决方法很简单——直接把代码交给 ChatGPT,让它分析错误并推荐修改方案。建议不要通过关闭严格模式(strict_json_schema=False)来规避问题,因为这样虽然可以暂时运行,但很容易埋下难以排查的 Bug。
清单 2.9 05_output_types_fixed.py
from pydantic import BaseModel, ConfigDict
from typing_extensions import TypedDict
class Task(TypedDict): #1
id: int
description: str
class ResearchPlanModel(BaseModel):
tasks: list[Task] #2
"""Numbered tasks for research."""
model_config = ConfigDict(extra='forbid') #3
OUTPUT
tasks=[
{'id': 1, 'description': 'Review academic literature'},
{'id': 2, 'description': 'Analyze recent case studies'},
{'id': 3, 'description': 'Interview industry experts'},
{'id': 4, 'description': 'Attend AI conferences'},
{'id': 5, 'description': 'Explore online courses'}
]
代码说明
- #1 将原来的
dict[int, str]替换成TypedDict定义的Task类型。 - #2
tasks不再是字典,而是由多个Task对象组成的列表。 - #3 使用
ConfigDict(extra='forbid')禁止模型接收任何未定义的额外字段,从而保证 JSON Schema 保持严格模式。
使用类型化输出还有一个重要优势:你无需再在 Prompt 中详细规定输出格式。虽然 Prompt 中仍然需要说明希望得到什么内容,但不用再写诸如:
输出必须是 JSON,包含 title、tasks、summary 等字段……
因为输出格式已经由 Pydantic 类型定义好了,SDK 会自动约束模型按照该 Schema 输出。这样做带来了几个好处:
- Prompt 更简洁、更易维护;
- Prompt 更通用,不容易因为格式描述出错;
- Agent 之间的数据交换更加稳定,不容易因为输出格式变化而导致工作流失败。
2.3.4 Agent Tracing(Agent 执行追踪)
如果你使用 OpenAI Agents SDK 并调用 OpenAI API,那么 Tracing默认就是开启的。你可以登录 OpenAI API 网站查看 Agent 的整个执行过程。图 2.6 展示了之前 Research Planning Agent的 Trace 页面。
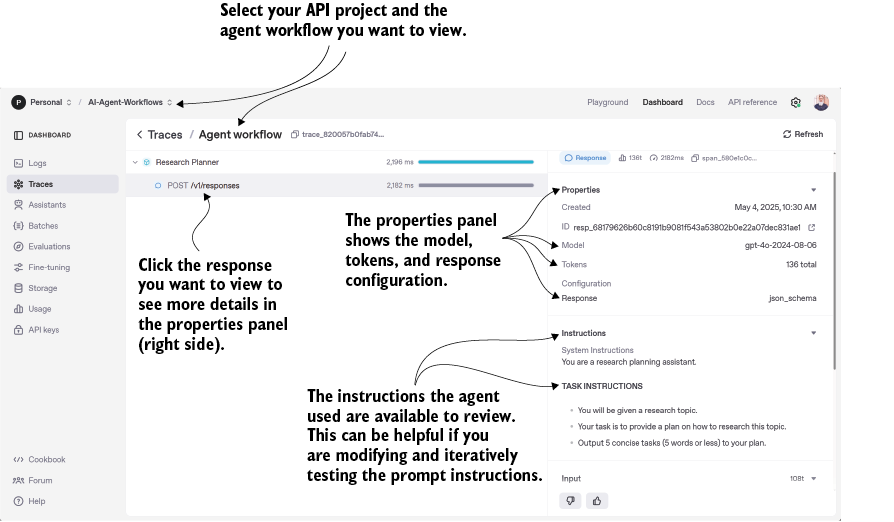
图 2.6 OpenAI Traces 界面示例。顶部展示了 Agent 的整个工作流(Trace),下方则显示了底层 LLM 调用的详细信息,包括输入、模型、Token 数量、系统提示词以及模型输出。
OpenAI 提供的 Traces Dashboard 开箱即用,非常方便,但它只是众多方案中的一种。目前比较流行的开源可观测性工具还包括:
- LangSmith
- Langfuse
- Arize Phoenix
- Weights & Biases Weave(Weave)
这些工具都是框架无关的,可以同时支持:
- OpenAI
- Anthropic
- 本地部署模型
- 自定义 Agent 系统
对于真正的生产环境(尤其是金融、医疗等监管行业,或者同时使用多个模型供应商的系统),通常都会选择独立的 Tracing 平台,而不是依赖 OpenAI 自带的 Traces。本书后续章节还会专门介绍 Agent 的可观测性。
图中的 Traces 页面来自 OpenAI API 控制台。只有当你的 Agent 使用 OpenAI API 模型时,才能在这里看到执行记录。你可以点击某一次 Workflow,查看该次 Agent 的完整执行过程。
除了默认记录 Trace,你还可以在代码中自定义 Trace 名称,使 Workflow 更容易区分。下面的代码将之前的 Research Planning Agent 添加了一个自定义 Trace。
清单 2.10 06_agent_with_tracing.py
agent = Agent(
name="Research Planner",
instructions=instructions,
output_type=ResearchPlanModel,
)
input = "learn about AI agents"
with trace("Deep Research Workflow"): #1
result = Runner.run_sync(
agent,
input=input,
)
print(result.final_output)
代码说明
- #1 使用
with trace(...)包裹整个 Agent 执行过程,并为此次 Workflow 指定一个名称。
这样,当你再次打开 OpenAI API 的 Traces 页面时,就可以看到一个名为 Deep Research Workflow 的执行记录,如图 2.7 所示。
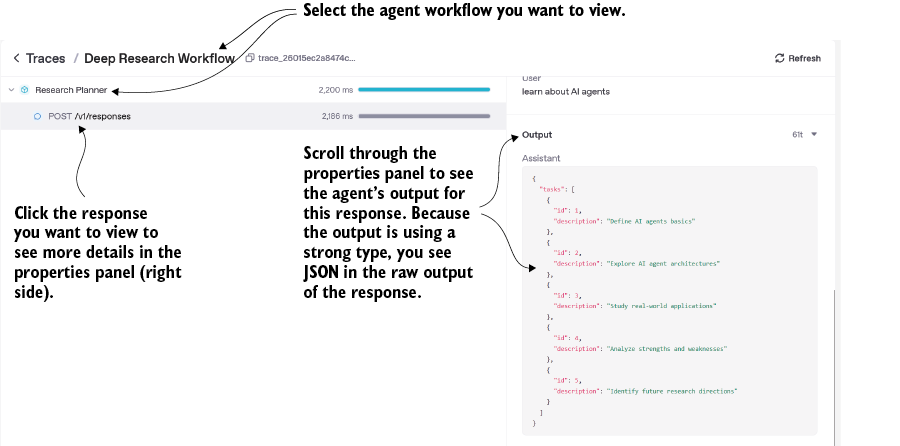
图 2.7 Deep Research Workflow 的 Trace 页面。这里展示的是 Research Planner Agent 调用 LLM,并最终返回一个 JSON 格式研究计划(任务列表)的全过程。
如图所示:选择某一次响应后,在右侧属性面板向下滚动,就可以看到 Agent 的完整输出。由于 Agent 配置了 Typed Output,因此:
- LLM 实际返回的是 JSON;
- SDK 再自动将 JSON 转换成
ResearchPlanModel对象。
整个过程对开发者来说几乎是透明的。随着 Agent 越来越复杂,查看 Trace 会变得越来越重要。复杂性可能来自很多方面,例如:
- 多个 Agent 协同工作
- 调用多个 Tool
- 多轮规划
- 工作流分支
Tracing 能帮助开发者快速定位每一步到底发生了什么。
2.4 通过工具增强 Agent 能力
Agent 真正的价值在于拥有 Agency(自主行动能力),也就是:
- 能自主做决策;
- 能自主执行决策。
如果按照这个标准来看,目前我们实现的 Research Planner 其实还算不上真正意义上的 Agent。到目前为止,我们只是写了一个 Prompt,让模型完成一个固定任务。这种由多个 Prompt 串联组成 AI 工作流的方法,通常称为:
Prompt Chaining
真正优秀的 Agent 应该具有灵活性和适应能力,而这种能力来自于自主性。赋予 Agent 自主性的最简单方式,就是为它提供工具(Tools)。这样 Agent 就可以自主判断:
- 什么时候调用工具;
- 调用哪个工具;
- 如何组合多个工具完成目标。
下一节,我们将开始为 Agent 添加工具,并让它真正具备行动能力。
2.4.1 为 Agent 提供工具
工具是 Agent 可以使用的能力,而动作则是 Agent 对这些工具所执行的操作。一个工具可以是:
- 一个 Agent 可以调用的 Python 函数;
- 通过 MCP 暴露出来的外部服务;
- 将任务交给另一个 Agent。
工具既可以由我们自己开发,也可以直接使用第三方提供的工具。第 3 章将详细介绍 Agent 如何通过 MCP 接入和使用各种工具。
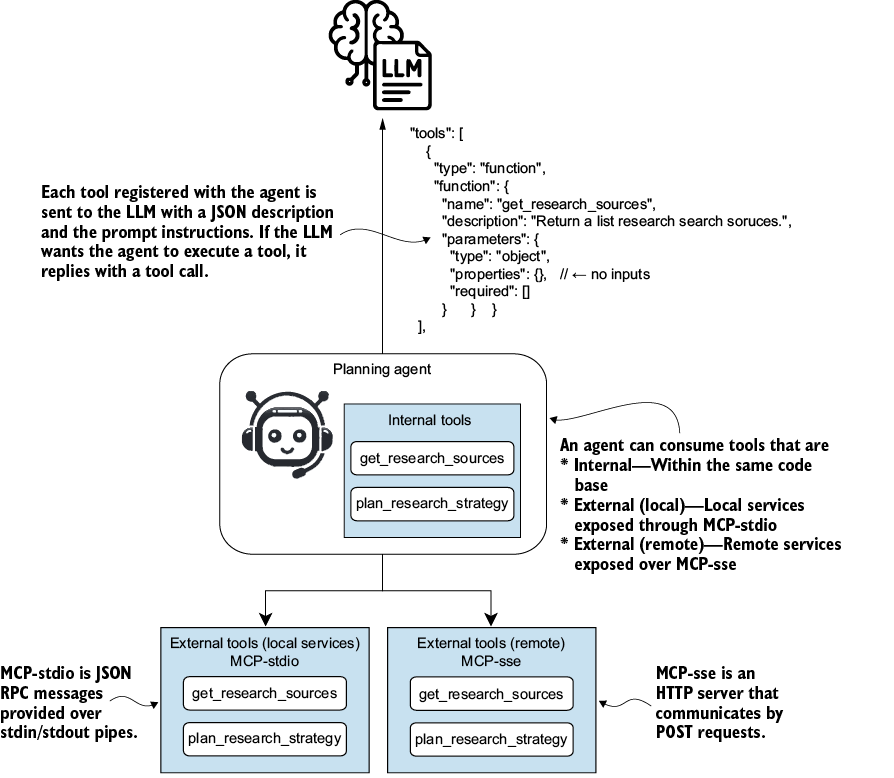
图 2.8 Agent 使用工具的几种方式。工具既可以是代码中的本地函数,也可以是通过 MCP 协议连接的本地或远程 MCP Server。
图中展示了 Agent 调用工具的整体流程,以及工具可能所在的位置。工具既可以:
- 位于当前代码库;
- 运行在独立进程中;
- 也可以通过 HTTP 调用远程 MCP Server。
这种灵活性使我们能够根据实际需求自由组合 Agent 的能力。
下面的代码展示了如何给前面的 Research Planner Agent 添加一个新的工具 get_research_sources。虽然仅仅把工具注册进去就能使用,但更好的做法是在 Prompt 中明确告诉 Agent:什么时候应该调用这个工具。更新后的 Prompt 会要求 Agent:
- 先获取可用的研究资料来源;
- 然后制定研究计划;
- 每一步都要指定对应的数据来源。
清单 2.11 07_agent_with_tool.py
instructions = """ #1
You are a research planning assistant.
**TASK INSTRUCTIONS**
- You will be given a research topic.
- Begin by using the tool get_research_sources()
to get a list of available research sources.
- Constrain your research plan
only to use the available research sources.
- Your task is to provide a plan for researching this topic.
- Output 5 concise tasks and specify which of the
available research sources will be used for each task.
"""
class Task(TypedDict):
step: int
"""Task Step."""
research_source: str #2
"""The source to search."""
description: str
"""Task description."""
class ResearchPlanModel(BaseModel):
tasks: list[Task]
"""Numbered tasks for research."""
model_config = ConfigDict(extra='forbid')
@function_tool #3
def get_research_sources() -> list[str]:
"""Provides a list of research sources."""
search_sources = [ #4
"Wikipedia",
"Google",
"YouTube",
]
return search_sources
agent = Agent(
name="Research Planner",
instructions=instructions,
output_type=ResearchPlanModel,
tools=[get_research_sources], #5
)
代码说明
- #1 更新 Prompt,明确要求 Agent 先调用
get_research_sources()。 - #2 在任务对象中新增
research_source字段,用于记录每一步使用的数据来源。 - #3 使用
@function_tool装饰器,把普通 Python 函数注册成 Agent Tool。 - #4 示例中仅返回一个固定的数据源列表。
- #5 将工具注册到 Agent。
本例中返回的是一个静态列表:
- Wikipedia
- YouTube
实际项目中,这里通常不会写死,而是:
- 查询数据库;
- 调用 API;
- 或动态获取当前可用的数据源。
随后 Agent 就可以根据返回结果,制定只依赖这些数据源的研究计划。这种设计使 Agent 从一开始就具备了良好的扩展性。以后只需要修改工具内部逻辑,就可以让 Agent 自动适配新的数据源,而无需修改 Prompt。
使用 @function_tool 装饰器,可以非常方便地将任意 Python 函数暴露给 Agent。这个装饰器会自动完成很多底层工作,例如:
- 生成 Tool 的 JSON 描述;
- 告诉 LLM:
- 工具叫什么;
- 参数是什么;
- 返回值是什么;
- 什么时候应该调用。
开发者无需自己编写 Tool Schema。不过,有一点非常重要:
一旦某个 Tool 被注册到 Agent,它的描述信息就会随着每一次 LLM 请求一起发送。
无论 Agent 最终有没有调用这个 Tool,LLM 都会收到它的 JSON 定义。
虽然一个 Agent 可以注册几十个 Tool,但 Tool 越多,并不意味着效果越好。现代的大模型相比早期模型,确实能处理更多 Tool。但实际能够管理多少 Tool,还取决于:
- Tool 是否容易区分;
- Tool 描述是否清晰;
- 底层模型本身的能力。
因此,与其关注「最多支持多少 Tool」,更应该关注 Tool 带来的成本和复杂度。下面几个问题尤其值得注意。
Tool 会增加 Token 开销:每个 Tool 的 JSON Schema 都会作为 Prompt 的一部分发送给 LLM。正如前面介绍 JSON Tokenization 时所说:JSON 本身就比普通文本消耗更多 Token。因此 Tool 越多,Prompt 越长,输入 Token 成本越高。即使 Tool 没有真正被调用,这部分 Token 费用也必须支付。对于一次任务需要调用很多次 LLM 的 Agent 来说,这部分成本会迅速累积。
Tool 会增加 Prompt 的复杂度:每增加一个 Tool,就意味着 Prompt 中要增加一段说明:工具作用是什么、如何调用、适用于哪些场景。Prompt 越长、规则越多:输出越容易产生随机性、Agent 越容易选错 Tool、系统失败的概率也会增加。
Tool 本身也可能失败:每增加一个 Tool,就增加了一个潜在故障点。例如:
- API 超时;
- 网络异常;
- 请求频率限制;
- 服务宕机;
- 返回格式错误。
一个成熟的 Agent Workflow 应该提前考虑这些情况,而不是让程序直接崩溃。常见做法包括:
- 对临时错误进行指数退避重试;
- 返回结构化错误,而不是直接抛异常;
- 提供备用 Tool;
- 设置调用超时时间,避免 Agent 一直等待。
Tool 就意味着决策权:每一次 Tool Call,本质上都是 Agent 在做决策。有些决策风险很低,例如:搜索网页、查询数据库。但有些 Tool 风险却很高,例如:删除文件、和转账付款、和修改数据库。因此,在赋予 Agent 工具之前,一定要认真思考:如果 Agent 判断错误,会造成什么后果?作者举了一个非常形象的例子,如果你给 Agent 一个可以删除文件的 Tool,那么就要做好心理准备:它可能会删除它有权限访问的所有文件。
Tool 是 Agent 最强大的扩展能力之一,但同时也是最容易产生风险和故障的地方。因此,一个优秀的 Agent 应该遵循最小权限原则:
只给 Agent 完成任务所必需的工具,不要提供多余能力。
幸运的是,OpenAI 提供的 Tracing 功能可以完整记录每一次 Tool 的调用过程。开发者可以通过 Trace 快速发现:
- Tool 是否被正确调用;
- 调用了哪些 Tool;
- 调用是否成功;
- 哪一步发生了错误。
这也是调试复杂 Agent 系统最重要的工具之一。
2.4.2 追踪 Agent 的工具调用
随着 Agent 调用的 Tool 越来越多,整个执行流程会迅速变得复杂。这时,OpenAI Traces 页面就成为调试问题、优化性能以及分析 Workflow 的重要工具。下面的示例(清单 2.12)进一步扩展了前面的 Research Planning Agent。现在 Agent 拥有两个工具,而且第二个工具依赖第一个工具的输出。
清单 2.12 08_agent_with_tools_tracing.py
instructions = """
You are a research planning assistant.
**TASK INSTRUCTIONS**
- You will be given a research topic.
- Begin by using the tool get_research_sources()
to get a list of available research sources.
- Use the tool get_resource_url() #1
to look up the url for the research source.
- Constrain your research plan
only to use the available research sources.
- Your task is to provide a plan for researching this topic.
- Output 5 concise tasks and specify which of the
available research sources will be used for each task.
"""
class ResearchSource(TypedDict): #2
name: str
"""Name of the search source."""
url: str
"""URL of the search source."""
class Task(TypedDict):
step: int
"""Task Step."""
research_source: ResearchSource #2
"""The source to search."""
description: str
"""Task description."""
class ResearchPlanModel(BaseModel):
tasks: list[Task]
"""Numbered tasks for research."""
model_config = ConfigDict(extra='forbid')
@function_tool
def get_research_sources() -> list[str]:
"""Provides a list of research sources."""
search_sources = [
"Wikipedia",
"Google",
"YouTube",
]
return search_sources
@function_tool
def get_resource_url(research_source: str) -> str: #3
"""Provides a url for the research source."""
search_sources = {
"Wikipedia": "https://www.wikipedia.org",
"Google": "https://www.google.com",
"YouTube": "https://www.youtube.com",
}
return search_sources[research_source]
agent = Agent(
name="Research Planner",
instructions=instructions,
output_type=ResearchPlanModel,
tools=[get_research_sources, get_resource_url], #4
)
input = "learn about AI agents"
with trace("Deep Research Workflow (Tools)"):
result = Runner.run_sync(
agent,
input=input,
)
print(result.final_output)
代码说明
- #1 Prompt 明确要求 Agent 在获取研究来源后,再调用
get_resource_url()查询每个来源的网址。 - #2 新增
ResearchSource类型,用于保存研究来源名称和对应 URL。 - #3 新增工具
get_resource_url(),根据来源名称返回对应的网址。 - #4 将两个工具一起注册到 Agent。
现在,Agent 的执行流程变成了:
- 调用
get_research_sources()获取可用的数据源; - 对返回的每一个数据源,再调用
get_resource_url()获取对应的网址; - 最后根据这些数据源生成研究计划。
这意味着 Agent 已经开始执行多个 Tool Call,并且后面的调用依赖前面的结果。虽然这个例子比较简单,但它展示了 Agent 中一种非常常见的模式:
Tool Chaining
Tool Chaining 是指 Agent 将一个工具的输出作为另一个工具的输入,从而将多个工具串联起来完成任务。在某些情况下,Prompt 中的指令会明确规定工具链的执行流程;但更常见的是,由 Agent 自主决定哪些工具需要串联,以及它们之间应如何衔接。
现代的前沿大模型还支持在同一次响应中并行调用多个工具,前提是这些工具之间彼此独立、互不依赖。例如,一个负责研究某个主题的 Agent,可能会同时调用:
- 搜索工具;
- 日历工具;
- 知识库查询工具。
待所有工具返回结果后,Agent 再综合这些信息进行推理。与串行执行工具链相比,并行调用能够显著降低整体延迟。不过,并行调用仅适用于各个工具之间不存在依赖关系的场景;如果某个工具必须依赖另一个工具的输出,就只能按顺序执行。至于哪些工具应该串行、哪些可以并行,则由 Agent(基于自身推理)或开发者(通过 Prompt 设计)来决定。
OpenAI Traces 页面提供了一种非常直观的方式,用于查看这种复杂的工具调用链路。图 2.9 展示了 Traces 页面的一张截图,其中包含了代码清单 2.12 中 Agent 的示例工具调用轨迹。
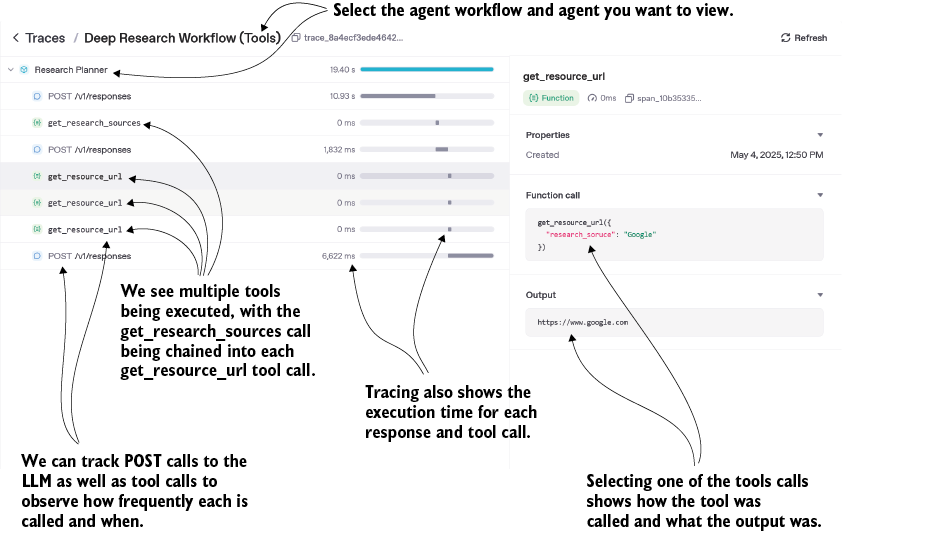
图 2.9 展示了清单 2.12 中 Agent 的完整 Tool 调用链。
从 Trace 中可以看到:
- 每一次 LLM 调用;
- 每一次 Tool 调用;
- Tool 的输入参数;
- Tool 的输出结果;
- 每一步发生的先后顺序。
因此,我们可以非常容易地分析:整个 Tool Chain 是如何执行的。
除此之外,Traces 还能显示:
- 每一步开始时间;
- 每一步结束时间;
- 每个 Tool 花费了多少时间;
- 哪一步最耗时。
这些信息对于性能优化非常有帮助。
如果你使用的是 OpenAI API,Tracing 功能是开箱即用的。如果 Agent 使用的是其他模型提供商(例如 Anthropic 或本地模型),理论上也可以继续使用 OpenAI 的 Traces,但需要注册 OpenAI API并配置对应的 API Key。这是一个较高级的使用场景,本书不会展开介绍。
正如本章所展示的:一个 Agent 往往几分钟就可以搭建完成。但随着:
- Tool 数量增加;
- Tool Chain 增多;
- Multi-Agent 协作出现;
系统复杂度会迅速上升。这也是为什么 Tracing 会成为 Agent 开发过程中最重要的调试工具之一。它能够帮助开发者清楚地了解:Agent 在什么时候做了什么,以及为什么这么做。
2.5 练习
练习 1:构建并运行最小 Agent
目标: 创建第一个版本的 Research Planner Agent,并验证其基本输出。
任务:
- 打开
listings文件夹中的01_first_agent.py。 - 将其另存为
exercise1_minimal_agent.py。 - 将占位文本
<user query here>替换为"learn about AI agents"。 - 运行脚本。
- 确认控制台输出恰好五条编号任务。
预计耗时: 8 分钟
练习 2:调整模型,提高输出稳定性
目标: 观察 Temperature 对回答一致性的影响。
任务:
- 将文件复制为
exercise2_model_tuning.py。 - 在
Agent(...)构造函数中设置:
model="gpt-4.1",
model_settings=ModelSettings(
temperature=0.0,
max_tokens=150
)
- 连续运行脚本两次,并保存两次输出。
- 将
temperature修改为1.0,再次运行。 - 在文件底部添加注释,说明三次运行中哪些输出发生了变化。
预计耗时: 10 分钟
练习 3:强制使用严格类型输出
目标: 将 Agent 修改为返回结构化的 ResearchPlanModel,并解决严格 JSON错误。
任务:
- 将
exercise2_model_tuning.py复制为exercise3_typed_output.py。 - 按照代码清单 2.7添加
ResearchPlanModel类。 - 在 Agent 中设置:
output_type=ResearchPlanModel
- 运行脚本,观察出现的关于 Strict JSON 的
UserError。 - 将
dict[int, str]替换为代码清单 2.9中的TypedDict实现,并重新运行。 - 验证最终控制台输出为类似 JSON 的列表,包含五个对象,每个对象格式如下:
{
"id": ...,
"description": ...
}
预计耗时: 12 分钟
练习 4:应用 Prompt Engineering 最佳实践
目标: 优化 Prompt,使用分隔符、明确角色和长度限制等技巧。
任务:
- 将上一节文件复制为
exercise4_prompt_refinement.py。 - 重写
instructions,至少应用表 2.2 中的四种 Prompt 技巧,例如:- 明确 Persona
- 使用分隔符
- 明确输出长度
- 使用积极的指令描述
- 使用 Markdown 代码块(
```)将 TASK 部分包裹起来,作为分隔符。 - 保持
temperature=0,连续运行两次脚本。 - 确认每次运行都返回:
- 恰好 5 个任务;
- 每个任务长度不超过 7 个单词。
预计耗时: 12 分钟
练习 5:添加内部工具并查看 Trace
目标: 为 Agent 添加 get_research_sources 工具,并查看执行 Trace。
任务:
- 将上一节文件复制为
exercise5_tool_and_tracing.py。 - 按照代码清单 2.11实现
get_research_sources(),并将其注册到 Agent:
tools=[get_research_sources]
- 修改 Prompt,使第一步明确要求 Agent 调用该工具。
- 使用
trace()包裹Runner.run_sync():
with trace("Chapter 2 Tool Demo"):
...
- 运行脚本一次。
- 打开 OpenAI Dashboard → Traces,确认在 LLM 响应之前出现了一次工具调用(Tool Call)。
预计耗时: 15 分钟
本章总结
- 大语言模型本质上是概率性的 Token 预测器。 理解分词和概率预测机制,是控制成本、上下文窗口以及输出质量的基础。
- 文本长度并不等于 Token 数量。 应使用
tiktoken或 OpenAI Agents SDK 提供的 Token 统计功能测量 Token 数,以便合理控制成本预算和上下文窗口。 - Temperature、Top-p、Max Tokens、Penalty 等生成参数 可以根据不同 Agent 的角色,在创造力、一致性和成本之间进行权衡。
- 高质量的 Prompt 应遵循几个基本原则:明确角色、将关键指令放在最前面、使用结构化分隔符、提供 Few-shot 示例,以及利用 Chain-of-Thought 等方法,引导 LLM 输出稳定且符合要求的结果。
- 结构良好的 Prompt 能避免常见问题,例如 Prompt 过于复杂、存在相互矛盾的指令、分隔符不统一以及输出结果不稳定,从而让 Agent 更安全、更高效、成本更低。
- OpenAI Agents SDK 可以将一个 Prompt 快速封装为可运行的 Agent,并支持指定模型和模型参数,使 Agent 的行为更符合具体任务需求。
- 使用 Pydantic 定义输入/输出类型 可以避免脆弱的字符串解析,即使 LLM 具有随机性,也能保证多 Agent 工作流的稳定运行。
- OpenAI API 内置的 Tracing功能 能记录每一次 LLM 调用和工具调用,为调试、性能分析和优化 Agent 提供极大的便利。
- 赋予 Agent 工具——无论是本地函数还是未来基于 MCP 的远程服务——才能真正赋予 Agent 行动能力(Agency)。同时,应尽量控制工具数量,以减少 Token 开销和工具失败带来的风险。
- Tool Chaining 允许 Agent 自主串联多个工具完成复杂任务,而 Trace 数据可以帮助开发者查看 Agent 的决策过程,并发现性能瓶颈。
- 将 Prompt Engineering、模型参数调优、类型化 Schema、Tracing 以及精心设计的工具集结合起来, 可以构建出具备生产级能力的 AI Agent,使其能够稳定地进行规划、推理,并执行复杂的 Deep Research等任务。