本章内容
- 拆解三层 Agentic Loop(智能体循环)
- 使用深度研究 Agent 进行循环
- 多 Agent 编排循环
- 构建协作式 Agentic Loop
早在第 1 章,我们就探索了核心智能体循环模式,也就是我们称之为 SPAL(sense-plan-act-learn,感知-规划-行动-学习)过程循环的模式。在本章中,我们将视角从智能体内部循环扩展到智能体之外的循环模式。这些模式用于构建长周期(long-horizon)、目标驱动型智能体,例如深度研究(deep research)中涉及的智能体,或者更广泛意义上被称为**智能体协作(agent collaboration)**工作流的系统。
利用智能体循环机制增强智能体能力,可以在单智能体和多智能体系统中引入新的命令与控制层级。本章将探索智能体循环的三个层次。这些层次从我们已经了解的内部循环(SPAL),扩展到长周期目标执行,再到多智能体系统中的元引导循环(meta-guided looping)。在此过程中,我们将研究每一层的实际应用,以及如何将这些模式引入你的智能体工作流中。
9.1 剖析三个智能体循环层级
内部循环(SPAL)是智能体的第一层,也是核心层。这个循环使智能体能够进行迭代、探索、推理,并执行任务,从而完成目标。但另外两层智能体循环还可以进一步扩展智能体的工作能力:第 2 层是任务循环(task loop),第 3 层是元循环(meta loop)。
9.1.1 第 1 层:内部循环(感知-规划-行动-学习)
第 1 层智能体循环通过将智能体的执行过程封装在一个受控循环中来工作。这个循环会持续重复,直到智能体的目标达成,或者满足某个终止条件。图 9.1 展示了第 1 层核心智能体循环架构。如图所示,智能体从一个目标开始,并感知当前内部状态(包括之前迭代过程中积累的上下文信息)。随后,它规划下一步行动,使用工具执行该行动,评估执行结果,并更新内部状态。接着,智能体判断目标是否已经完成;如果没有完成,它会携带所有已学习的信息回到循环起点,继续下一轮迭代。
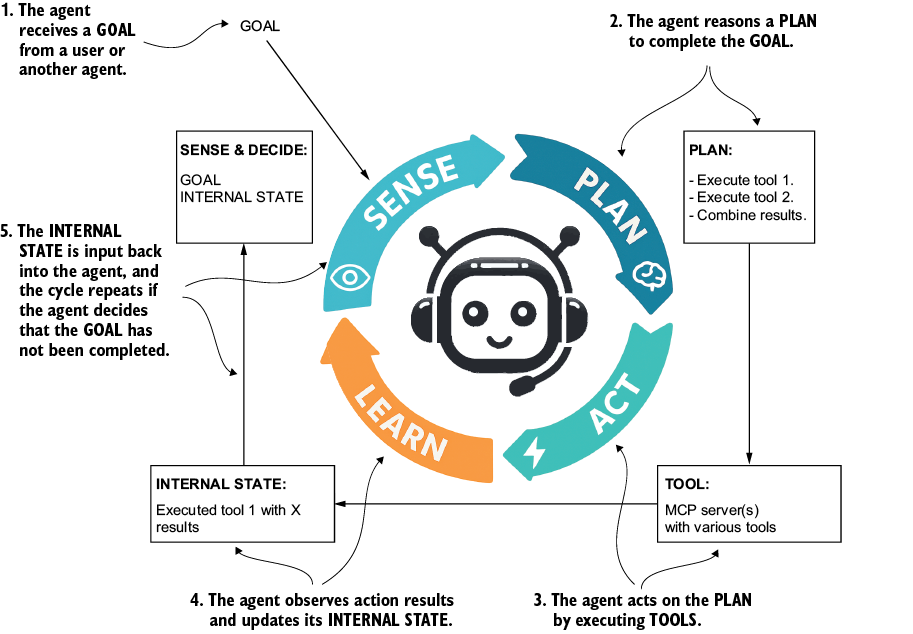
图 9.1 核心智能体循环。智能体会循环执行感知(sense)、规划(plan)、行动(act)和评估(evaluate)步骤,直到目标完成或触发终止条件。内部状态会在多次迭代中不断积累,使每一次循环都比前一次拥有更多上下文信息。
使这个循环具有 智能体特征 的关键,并不只是代码中的一个 while 循环,而在于智能体本身会在每一步做出决策。智能体决定如何完成目标、调用哪个工具、判断结果是否足够好,以及何时停止。开发者定义目标、提供工具并建立边界,但驱动整个迭代过程的是智能体本身。
从图中可以看到,其中标识了一些重要术语。目标,即智能体将要执行的任务;计划,即智能体如何执行任务;工具,即智能体如何采取行动;状态(内部状态),即智能体如何保持上下文(记忆);以及 感知/决策,即智能体如何判断自己何时完成任务。在第 1 层循环中,所有这些元素都位于智能体内部。
每一个智能体层级循环都建立在这些核心元素之上:目标、计划(迭代策略)、状态以及决策(终止条件)。正确处理这些要素,决定了一个智能体是能够不断收敛并产生高质量输出,还是会无限运行,或者过早放弃。
9.1.2 第 2 层:任务循环
智能体循环的第 2 层,核心在于将核心元素(目标-计划-状态-决策)从智能体内部外置出来。这扩展了智能体能够持续追踪和执行的目标范围,使其从简单目标扩展到非常复杂的目标。图 9.2 展示了我们可能要求智能体执行的短周期目标和长周期目标示例。同时,它也展示了如何将第 1 层智能体循环的概念扩展到第 2 层智能体循环。
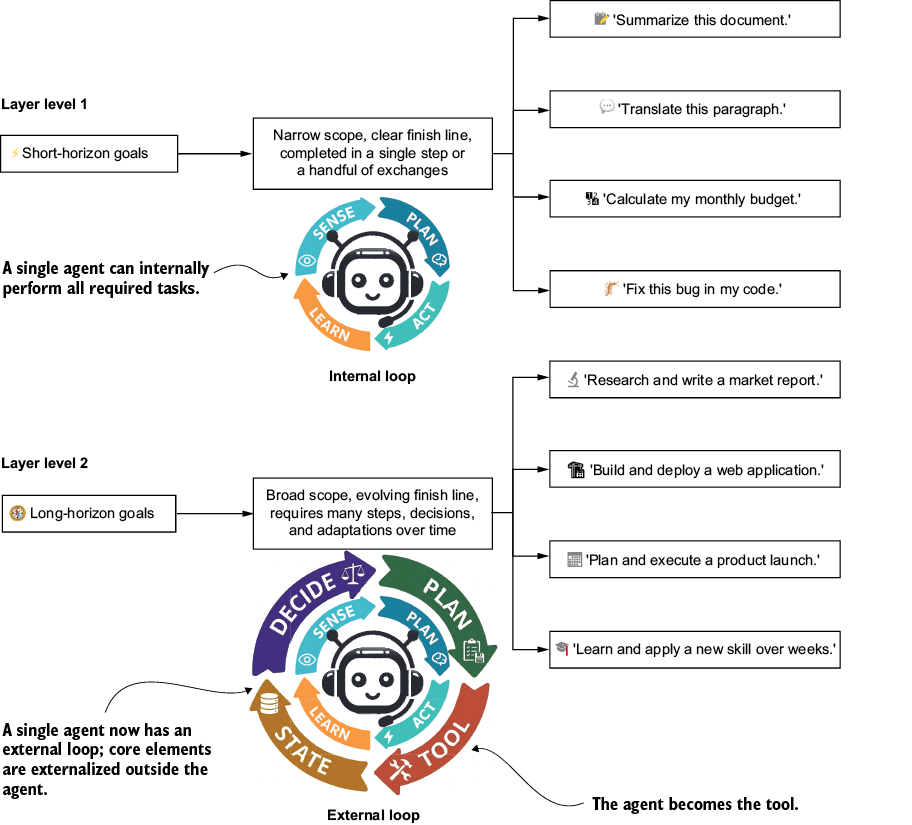
图 9.2 短周期目标与长周期目标的比较。可以看到,这一过程需要将单智能体内部循环提升到第 2 层基于任务的外部智能体循环。
我们引入一个额外的外部循环,以便为长期计划和持续状态保存提供空间。在内部,智能体仍然会维护计划和内部状态,但这些内容在智能体内部循环中只是短暂存在的。为了完成长周期目标,智能体系统需要将计划和状态持久化存储到外部。
通过将智能体的计划和状态外置,一个单一智能体可以跨越多个短周期目标工作,从而实现深度研究(deep research)这类长周期目标。这样做不仅仅是因为我们不希望超出 LLM 的上下文窗口限制。另一个原因是,从设计上来看,通用型 LLM 并不适合进行长时间运行的迭代过程。近年来,面向智能体优化的 LLM 开始流行,但它们依然面临大规模上下文窗口的问题。
驱动第 2 层的机制通常是围绕智能体构建的、以程序化和确定性方式实现的封装结构。正如我们将在本章后续部分看到的,计划过程可能涉及一个长期运行的顺序思考服务器;状态可以存储在进程内存或数据库中;决策则可以是代码中的一次检查,而工具则是智能体自身。
9.1.3 第 3 层:元循环(Meta Loop)
第 3 层,即元智能体循环(meta-agentic loop),是一个智能体或多个智能体,用于控制内部的第 1 层或第 2 层过程。第 2 层和第 3 层之间的关键区别在于:第 2 层通常由代码驱动,而元层则由一个智能体或多个智能体进行控制。图 9.3 展示了第 3 层元循环的引入,该循环由智能体编排器(agent orchestrator)或多个智能体之间的协作来控制。
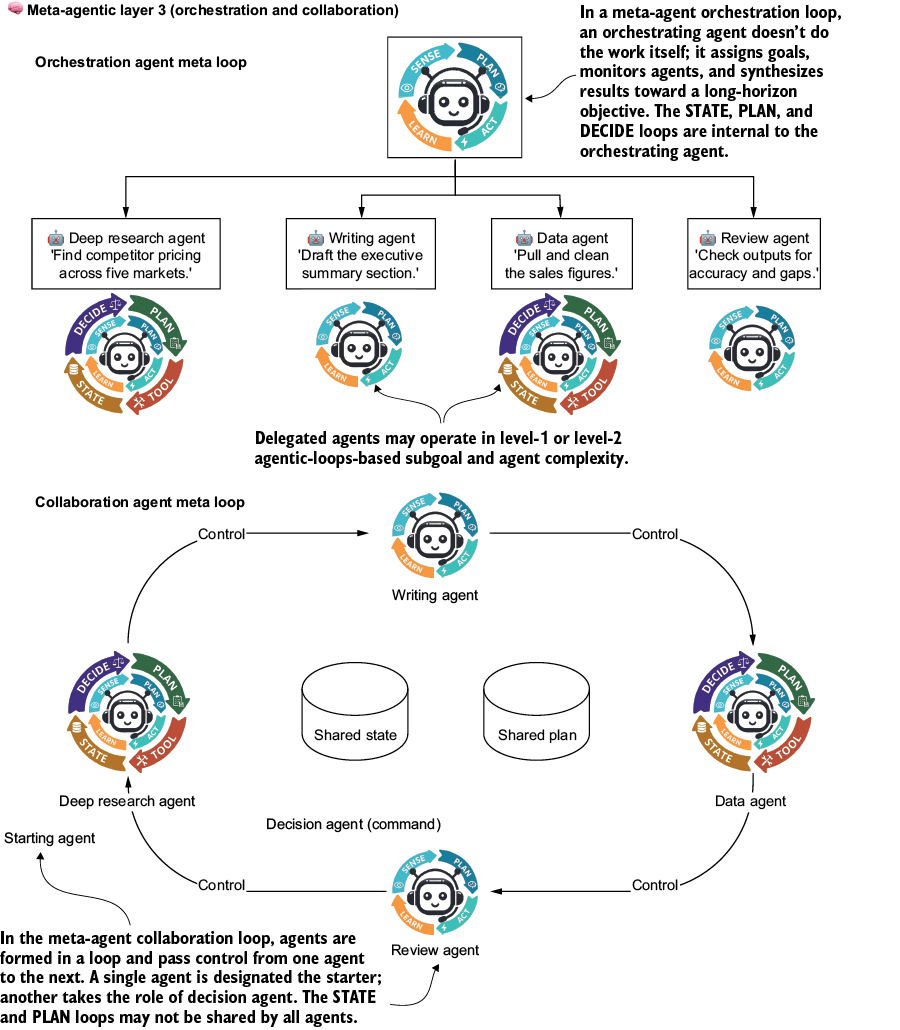
图 9.3 使用编排控制器的第 3 层智能体循环与更自由形式的协作模式之间的比较
由于第 3 层元循环由智能体控制,因此智能体在其中的位置决定了循环的子类型:编排(orchestration) 或 协作(collaboration)。
在由编排控制的元循环中,一个负责委派任务的智能体将 决策(decide)、状态(state) 和 计划(plan) 这些元素封装在自身的内部循环中,并将负责执行任务的子智能体(delegation subagents)作为 工具(tools) 使用。
当负责决策的智能体或多个智能体本身成为循环的一部分时,该系统就变成了智能体协作模式。在这种模式下,多个智能体可能会共享 状态(state) 和 计划(plan) 组件,也可能不会共享,具体取决于实际使用场景。
由于我们已经对内部智能体循环进行了较为深入的介绍,因此本章剩余部分将重点讨论更高级形式的智能体循环实现:第 2 层任务循环,以及两种形式的元循环(第 3 层)。
9.2 第 2 层:使用深度研究智能体进行循环
深度研究智能体(deep research agent)可能是第 2 层智能体循环最广为人知的实现方式。其中,“深度(deep)”指的是智能体为了完成更长周期、更深入的研究目标而执行的更加广泛的搜索过程。
研究型智能体已经得到广泛应用,所有基础模型提供商(Google Gemini、Anthropic Claude 和 OpenAI ChatGPT)都提供了某种形式的深度研究智能体。
一个优秀的智能体循环和一个失控的成本生成器之间的区别,归根结底取决于三个因素:
- 如何管理迭代之间的状态;
- 如何定义终止条件;
- 如何将智能体连接到外部工具。
如果这些因素处理正确,你将拥有一个能够可靠收敛并产生高质量输出的系统。如果处理错误,你将得到一个不断循环消耗 token,却无法取得有效进展的系统。
图 9.4 展示了第 2 层智能体循环的组件架构实现。该图扩展了图 9.1,展示了构成深度研究智能体的各个代码组件的实际实现方式。整个工作流代表了智能体外部的代码部分,这些代码负责控制智能体循环中的状态、计划、工具以及决策。
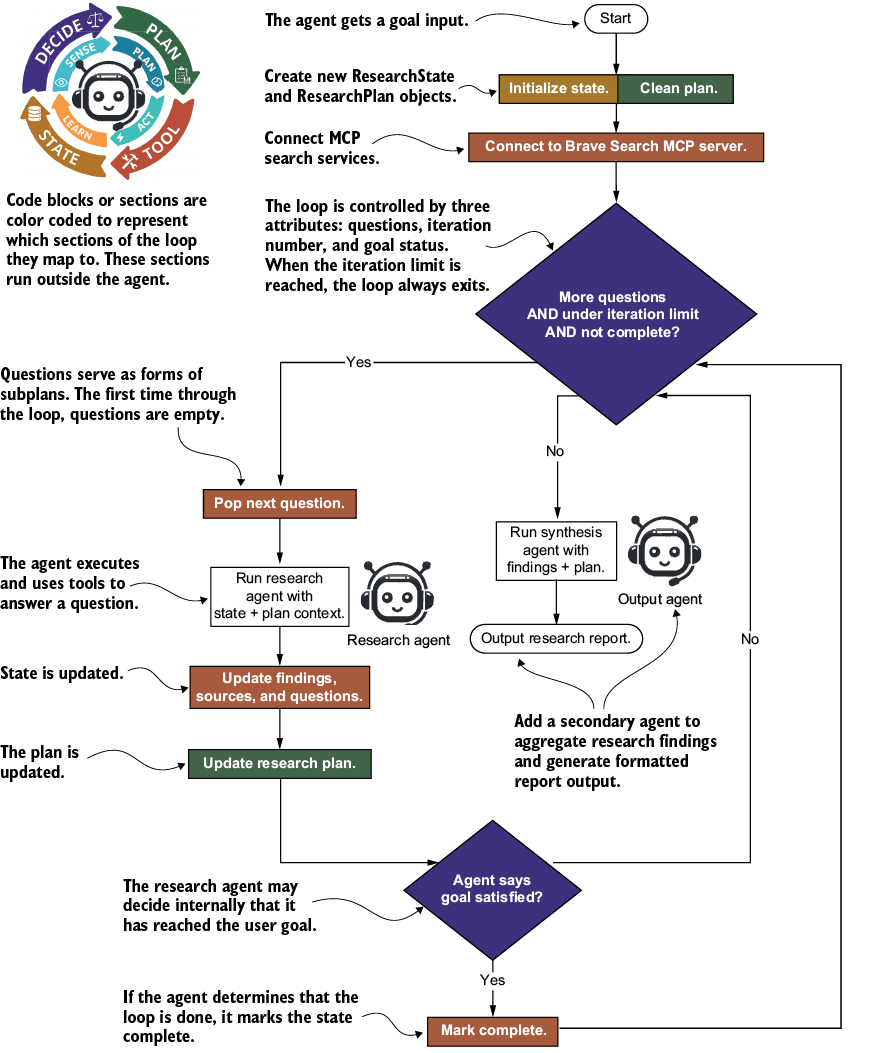
图 9.4 控制深度研究智能体的外部组件/代码部分,以及代码如何贯穿智能体循环中的每一个外部步骤
在图示顶部,深度研究流程从引入一个智能体必须持续追踪的长周期目标开始。随后,它会依次经过图中的每一个代码组件框,通过创建、更新或检查状态对象和计划对象,来维护第 2 层循环中位于智能体外部的状态和计划信息。
9.2.1 创建初始状态和计划
该流程首先初始化 ResearchState 和 ResearchPlan 对象,如下面的代码清单所示。这些对象在智能体执行过程之外维护外部状态和计划,并且会在智能体循环的每一次迭代之间共享。
代码清单 9.1 01_research_state_plan.py(研究状态和计划)
from pydantic import BaseModel, Field
class SubTopic(BaseModel):
"""A single sub-topic within the research plan."""
name: str
status: str = "pending" # pending | in_progress | complete
notes: str = ""
class ResearchPlan(BaseModel):
"""Strategic plan that guides the research process."""
sub_topics: list[SubTopic] = Field(default_factory=list)
strategy_notes: str = ""
def to_context(self) -> str: #1
return str(dict(
sub_topics=[
dict(name=st.name, status=st.status, notes=st.notes)
for st in self.sub_topics
],
strategy_notes=self.strategy_notes,
))
@property
def progress_summary(self) -> str: #2
if not self.sub_topics:
return "No plan yet"
total = len(self.sub_topics)
complete = sum(1 for st in self.sub_topics
if st.status == "complete")
in_progress = sum(1 for st in self.sub_topics
if st.status == "in_progress")
return (f"{complete}/{total} complete, "
f"{in_progress} in progress")
class ResearchState(BaseModel): #3
goal: str = ""
findings: list[str] = Field(default_factory=list)
sources_consulted: list[str] = Field(default_factory=list)
follow_up_questions: list[str] = Field(default_factory=list)
plan: ResearchPlan = Field(default_factory=ResearchPlan)
iteration_count: int = 0
max_iterations: int = 10
status: str = "in_progress"
@property
def should_continue(self) -> bool: #4
return (
self.status == "in_progress"
and self.iteration_count < self.max_iterations
and len(self.follow_up_questions) > 0
)
def to_context(self) -> str: #5
return str(dict(
goal=self.goal,
findings=self.findings,
sources=self.sources_consulted,
pending_questions=self.follow_up_questions,
plan=self.plan.to_context(),
iteration=self.iteration_count,
remaining=self.max_iterations - self.iteration_count,
))
注释:
- #1 用于将计划转换为字符串上下文,以供 LLM 使用的辅助函数
- #2 计划的属性,用于返回计划执行过程的上下文字符串摘要
- #3 可以在智能体不同迭代之间传递的状态对象
- #4 用于判断智能体是否应该继续进行研究的属性
- #5 用于将状态转换为字符串上下文,以供 LLM 使用的辅助函数
ResearchState 本质上是共享记忆,用于跟踪循环中每一次智能体迭代的状态。在第一次迭代时,状态对象为空,但随着智能体不断迭代,它会快速累积信息。同样,ResearchPlan 保存了智能体在每次迭代中将采用的策略。在这个示例中,计划会随着智能体根据观察结果进行迭代而不断更新,同时也会提升它对于如何更好地执行搜索/研究任务的理解。
代码清单 9.1 中最关键的设计决策是 to_context 方法,该方法会将累积的状态/计划序列化为智能体可以使用的字典字符串。通过控制智能体在每次迭代中能够看到的信息,我们可以管理上下文窗口的使用,并让智能体始终聚焦于最相关的信息。
随着多轮迭代不断积累研究发现,你可能需要对早期发现进行总结,而不是直接传递原始信息。
9.2.2 添加工具
在构建状态之后,我们需要设置研究智能体将使用的工具和 MCP 服务器。代码清单 9.2 展示了一个典型的内部(STDIO)MCP 服务器实现方式,用于连接 Brave Search 服务。
注意:你可以使用任何想要的 MCP 搜索服务。在这个示例中,我们使用 Brave Search,同时还需要在项目的 .env 文件中设置 BRAVE_API_KEY。如果需要回顾项目配置,请参阅附录 A。
代码清单 9.2 02_mcp_search_setup.py(MCP/工具)
async def create_search_server() -> MCPServerStdio: #1
server = MCPServerStdio(
name="Brave Search",
params={
"command": "npx", #2
"args": ["-y", "@anthropic/brave-search-mcp"],
"env": {"BRAVE_API_KEY": os.environ["BRAVE_API_KEY"]},#3
},
)
await server.connect()
return server
注释:
- #1 在运行前,需要在
.env文件中设置BRAVE_API_KEY=your-key,或者使用其他 MCP 搜索服务器 - #2 使用该 MCP 服务器需要先安装 Node。
- #3 确保为你使用的任何搜索服务配置对应的 API 密钥。
在这个示例中,只使用了一个搜索源,但智能体可能可以访问多个工具和 MCP 服务器资源。这些资源可以连接到外部 API(例如 Brave Search),也可以连接到数据库、文件以及其他资源。
这些工具可以用于搜索、分析、聚合、分类以及其他各种使用场景。在这里,可能性几乎是无限的。
9.2.3 理解迭代主体输出
在进入主要决策模块之前,我们需要先介绍每一次智能体迭代所产生的输出。迭代输出记录了循环每一轮中发生的工作过程。这正是智能体进行感知、规划、行动和学习的地方。
在代码中,迭代主体通常表现为一次对 Runner.run() 的调用,并将当前状态/计划作为上下文传入,随后解析智能体的输出,以更新状态。
迭代输出(ResearchIteration)的设计应该确保智能体能够生成结构化输出,使循环控制器可以对其进行解析。这一点非常重要,因为循环控制器需要从每次迭代中提取特定信息:
- 智能体发现了什么;
- 智能体下一步想做什么;
- 智能体是否认为目标已经达成。
下面的代码清单展示了一个用于研究迭代的强类型输出模型。该模型还包含一个子对象,用于跟踪子主题的更新情况。
代码清单 9.3 03_iteration_output.py(迭代主体)
class SubTopicUpdate(BaseModel): #1
"""An update to a single sub-topic in the plan."""
name: str
status: str # pending | in_progress | complete
notes: str = ""
class ResearchIteration(BaseModel): #1
"""Output from a single research iteration."""
summary_of_findings: str #2
sources_used: list[str] #2
follow_up_questions: list[str] #2
goal_satisfied: bool #2
confidence: float #2
reasoning: str #2
plan_updates: list[SubTopicUpdate] = [] #3
new_sub_topics: list[SubTopicUpdate] = [] #4
strategy_notes: str = ""
#1 使用嵌套对象是在智能体输出中强制要求结构化格式的一种优秀方式。
#2 这些字段要求智能体通过自我评估输出迭代过程中的关键指标和状态,例如以高置信度判断目标是否已经满足。
#3 将应用于下一次迭代计划中的更新内容。
#4 智能体识别出的仍然需要解决的一组子目标(主题)。
在这里使用强类型输出是不可妥协的。如果没有它,你就只能通过解析自由文本响应来判断循环控制流程,而这种方式既脆弱又容易出错。
follow_up_questions 和 goal_satisfied 字段尤其重要,因为它们会驱动下一轮迭代。当这个列表为空,或者目标被标记为已满足时,它会向状态对象发出信号,表示没有剩余内容需要继续调查。这将触发终止。
智能体中的强类型输出
需要注意的是,当我们在 Agents SDK 中使用强类型输出时,并不会在智能体指令中明确指定输出格式。SDK 会负责将输出格式作为指令的一部分传递进去。
通过让 SDK 管理输出类型,我们避免了每次修改类结构时都需要同步修改智能体指令的问题。
9.2.4 终止门(Termination Gate)
终止门是每次迭代结束时的决策点,用于判断循环应该继续执行还是退出。正如前面所讨论的,终止条件应该始终采用分层设计。以下是一些你可能需要考虑的优先级:
硬限制(Hard limit) —— 最大迭代次数。这是你的安全保障机制,应该始终存在。该限制的设置取决于你希望智能体运行多长时间以产生高质量输出。
预算限制(Budget limit) —— 最大 token 消耗量或最大成本支出。对于具有成本约束的生产系统来说,这是关键因素。为了更好地控制成本,可以减少智能体每次迭代消耗的 token 数量。
目标满足度(Goal satisfaction) —— 智能体声明目标已经完成。这是理想的退出路径,但它同时也是一种可能存在偏差的内部自我评估。为了解决这种偏差,你可以引入另一个目标智能体来进行判断。
质量阈值(Quality threshold) —— 外部评估器或智能体自身评估结果超过最低置信度标准。由于这是自我评估过程,你可能希望使用一个质量评估智能体,或者组合式目标/质量智能体来控制这一过程。
停滞检测(Stagnation detection) —— 智能体的输出在连续 N 次迭代中没有发生有意义的变化。这可以防止产生收益递减的循环。
to_context函数可以帮助标准化输出,并跟踪主要变化。
硬限制和预算限制属于防御性机制,是不可妥协的。目标满足度和质量阈值表明智能体正在良好地完成任务。停滞检测则是在智能体没有失败、但也没有取得进展的情况下提供安全保障,避免它不断重复改写相同发现,或者执行类似的搜索。
停滞比失败更难检测
失败的智能体通常会抛出错误或返回空结果,而这些情况都很容易捕获。停滞的智能体则会返回看似合理的输出,但这些输出与两轮之前生成的内容没有实质区别。
为了检测这种情况,可以比较连续迭代摘要之间的语义重叠程度。你可以将两组文本转换为向量嵌入(vector embeddings),然后计算余弦相似度(cosine similarity)来检查语义重叠。
如果连续两次迭代的重叠程度超过某个阈值(例如 85%),则终止循环并返回当前结果。因为额外的迭代已经无法带来新的价值。
无约束循环的成本
没有硬终止条件的智能体循环,是生产环境事故的潜在来源。
每一次迭代都会消耗 token、产生 API 成本,并增加延迟。在开发阶段,让智能体一直循环直到它“满意”为止可能很有吸引力,但在生产环境中,你必须始终设置最大迭代次数和成本上限。
即使你相信智能体对于收敛的判断能力,一个防御性的最大限制仍然可以保护系统,避免模型陷入推理循环,或者持续搜索根本不存在的信息。
9.2.5 编写深度研究循环
现在,让我们组合完整的研究循环。代码清单 9.4 展示了完整的深度研究智能体实现。
其中包括循环控制器、智能体定义、MCP 服务器配置以及终止代码。注意观察状态如何从一次迭代流转到下一次迭代,以及终止条件如何协同工作。
这段代码覆盖了图 9.4 中展示的整个迭代循环,除了最后负责将所有内容整合成格式化输出报告的辅助智能体之外。
注意,智能体指令会告诉智能体它正在一个循环环境中运行。同时,指令也展示了如何初始化计划和状态,以及如何设置停止条件。
正如代码清单中所说明的,你通常还需要选择一个能够有效执行工具调用的模型,以完成每个子主题或任务。
代码清单 9.4 04_deep_research_loop.py(智能体初始化)
research_agent = Agent(
name="Deep Research Agent",
instructions=""" #1
You are a deep research agent.
Your goal is to thoroughly research a topic by searching for
information, reading results, and synthesizing findings.
RESEARCH PLAN:
- On your FIRST iteration (when no plan exists yet), analyze the
research goal and create a plan by returning sub-topics in
new_sub_topics. Each sub-topic should be a distinct aspect of
the goal. Set status to "pending" for unstarted topics and
"in_progress" for the one you are currently researching.
- On SUBSEQUENT iterations, update existing sub-topics via
plan_updates (change status to "in_progress" or "complete",
add notes summarizing what was learned). You may also add
new sub-topics via new_sub_topics if you discover the research
requires areas not in the original plan.
- Use strategy_notes to record high-level observations about
your research approach or adjustments to strategy.
Each iteration, review your plan and accumulated state, identify
gaps, search for new information, and update your findings.
follow_up_questions should contain specific search queries for
the next iterations. The plan provides strategic direction while
follow_up_questions drive tactical execution.
When you believe you have sufficient information to answer
the research goal comprehensively, set goal_satisfied to true.
""",
model="gpt-5.1", #2
output_type=ResearchIteration,
)
def apply_plan_updates( #3
plan: ResearchPlan, iteration: ResearchIteration
) -> None:
"""Apply plan changes from an iteration to the mutable plan."""
existing = {st.name: st for st in plan.sub_topics}
for update in iteration.plan_updates:
if update.name in existing:
existing[update.name].status = update.status
if update.notes:
existing[update.name].notes = update.notes
for new_st in iteration.new_sub_topics:
if new_st.name not in existing:
plan.sub_topics.append(
SubTopic(
name=new_st.name,
status=new_st.status,
notes=new_st.notes,
)
)
if iteration.strategy_notes:
plan.strategy_notes = iteration.strategy_notes
注释:
- #1 智能体指令会告知智能体它正在一个循环环境中运行。
- #2 一个能够有效执行所需工具的模型,以完成每个子主题/任务。
- #3 使用迭代主体输出中提供的更新内容更新计划。
代码清单 9.4 中包含了大量内容,因此让我们逐步分析其中的关键设计决策。
首先,to_context 方法只向智能体传递最近五条发现结果。这是一个在上下文丰富度和上下文窗口管理之间进行的有意权衡。
在一个运行 10 次迭代的循环中,如果传递所有发现结果,将会消耗上下文窗口中相当大的一部分空间。这会减少智能体用于思考以及处理工具结果的可用空间。
通过截断为最新的发现结果,我们可以让智能体聚焦于最新信息,同时相信较早的发现已经被后续内容进行了综合和吸收。
接下来,循环会从 follow_up_questions 列表的前端取出问题,并将新问题追加到列表末尾。这会形成一种广度优先探索模式。
如果你希望采用深度优先探索模式(即在进入下一个方向之前,完整追踪当前研究线索),则应该从列表末尾取出问题。
广度优先和深度优先探索之间的选择,是一个可以调节的参数,应根据你的研究场景进行匹配。
实际上,这里执行的是一种思维树搜索(tree-of-thought search)。
代码清单 9.5 04_deep_research_loop.py(完整研究循环)
async def run_research_loop( #1
goal: str, max_iterations: int = 10
) -> ResearchState:
search_server = MCPServerStdio(
name="Brave Search",
params={
"command": "npx",
"args": ["-y", "@anthropic/brave-search-mcp"],
"env": {"BRAVE_API_KEY": os.environ["BRAVE_API_KEY"]},
},
)
async with search_server:
agent = research_agent.clone(
mcp_servers=[search_server]
)
state = ResearchState( #2
goal=goal,
max_iterations=max_iterations,
follow_up_questions=[goal],
)
while state.should_continue: #3
state.iteration_count += 1
question = state.follow_up_questions.pop(0)
input_context = dict(
current_question=question,
accumulated_state=state.to_context(),
research_plan=state.plan.to_context(),
)
print(f"\n--- Iteration {state.iteration_count} ---")
print(f"Investigating: {question}")
result = await Runner.run(
agent, input=str(input_context)
)
iteration = result.final_output
state.findings.append(iteration.summary_of_findings)
state.sources_consulted.extend(iteration.sources_used)
state.follow_up_questions.extend(
iteration.follow_up_questions
)
apply_plan_updates(state.plan, iteration)
if iteration.goal_satisfied: #4
state.status = "complete"
print(f"Goal satisfied (confidence: "
f"{iteration.confidence:.0%})")
print(f"Found: {iteration.summary_of_findings[:100]}...")
print(f"New questions: {len(iteration.follow_up_questions)}")
print(f"Plan: {state.plan.progress_summary}")
return state
async def main(): #5
state = await run_research_loop(
goal="What are the latest advances in solid-state batteries "
"and which companies are leading commercialization?",
max_iterations=8,
)
print(f"\n{'='*50}")
print(f"Research complete after {state.iteration_count} iterations")
print(f"Sources consulted: {len(state.sources_consulted)}")
print(f"Status: {state.status}")
print(f"Plan progress: {state.plan.progress_summary}")
if state.plan.sub_topics:
for st in state.plan.sub_topics:
print(f" [{st.status}] {st.name}")
for i, finding in enumerate(state.findings, 1):
print(f"\nFinding {i}: {finding[:200]}...")
asyncio.run(main())
注释:
- #1 执行完整第 2 层智能体循环的主要代码。
- #2 初始化主要状态对象。
- #3 执行循环,直到智能体满足停止条件,或者超过最大迭代次数。
- #4 如果目标已经满足,则准备退出循环。
- #5 运行研究循环并输出结果的主循环。
注意,MCP 服务器是在 run_research_loop 函数内部通过异步上下文管理器(async context manager)创建并连接的。
这样可以确保循环完成时服务器能够被正确关闭,即使过程中发生异常也是如此。
永远不要在循环退出后让 MCP 服务器继续运行。它们会消耗资源,并可能导致后续运行过程中出现端口冲突。
9.2.6 综合最终输出
循环完成后,我们会得到一个发现结果列表,但此时还没有一个连贯、结构良好的研究报告。
这些发现来自各个独立迭代过程中的快照,可能存在内容重叠、相互矛盾,或者遗漏关键部分。
为了生成经过整理的最终输出,我们会运行一个独立的综合智能体(synthesis agent),利用累积的状态信息生成统一的报告。
代码清单 9.6 展示了综合智能体,以及循环完成后如何调用它。
这个智能体被刻意设计为与研究智能体分离,以保持清晰的职责划分:
- 研究智能体负责探索;
- 综合智能体负责整理和汇总。
代码清单 9.6 05_research_synthesis.py(综合智能体)
class ResearchReport(BaseModel): #1
title: str
executive_summary: str
key_findings: list[str]
sources: list[str]
confidence_assessment: str
gaps_and_limitations: str
synthesis_agent = Agent( #2
name="Research Synthesizer",
instructions="""
You are a research synthesis agent.
Given a set of research findings, their sources, and the
research plan with sub-topics, produce a comprehensive,
well-structured research report.
Use the research plan's sub-topics as a structural guide
for organizing your report sections.
Identify themes, resolve contradictions between findings,
and note any gaps or limitations in the research.
Mark any plan sub-topics that were not fully completed
as gaps in your report.
""",
model="gpt-5.1", #3
output_type=ResearchReport,
)
async def synthesize_research(state: ResearchState)
-> ResearchReport: #4
synthesis_input = dict(
goal=state.goal,
all_findings=state.findings,
all_sources=list(set(state.sources_consulted)),
iterations_completed=state.iteration_count,
final_status=state.status,
research_plan=state.plan.to_context(),
)
result = await Runner.run(
synthesis_agent, input=str(synthesis_input)
)
return result.final_output
注释:
- #1 用于最终输出的强类型报告结构。
- #2 一个职责明确的独立综合智能体。
- #3 选择一个能够组织输出的模型,但不要选择过于智能的模型,以避免它试图执行额外的研究工作,而高级推理模型可能会倾向于这样做。
- #4 用于准备综合输入,然后调用并返回结构化报告的函数。
注意,在综合步骤中,我们会将所有发现结果传递给综合智能体,而不仅仅是最近五条。这是因为综合智能体只运行一次,而不是处于循环之中,因此上下文窗口压力较低。综合智能体还会接收最终状态信息,其中包含研究目标是否已经完全达成,或者循环是否提前终止。该状态信息使智能体能够在生成报告时合理地添加限制说明或上下文说明。
智能体循环中的职责分离
让研究智能体在最后一次迭代中直接生成最终报告是一种很自然的想法,但应该抵制这种诱惑。研究智能体的职责是探索和发现。综合智能体的职责是整理和组织结构。当你将这两个职责合并时,会得到这样的智能体:它们会在探索过程中开始优化报告结构,从而降低搜索质量。保持两者分离,每个智能体都可以专注于自己最擅长的工作。
9.2.7 何时使用智能体循环
并不是每个智能体都需要循环。当任务具有以下一个或多个特征时,可以使用智能体循环:
迭代发现(Iterative discovery) —— 智能体无法通过单一步骤获取所有所需信息。研究、分析和探索类任务几乎总是属于这一类别。
渐进式优化(Progressive refinement) —— 输出结果会随着每次迭代而改进。写作、摘要生成和内容生成任务都可以从迭代式草稿过程中受益。
批处理(Batch processing) —— 存在一个需要处理的任务队列,智能体会逐个处理任务,或者以小批量方式处理。
条件分支(Conditional branching) —— 智能体下一步的行动取决于前一步的结果。诊断智能体、故障排查流程以及决策树都采用这种模式。
多源聚合(Multisource aggregation) —— 智能体需要整合多个来源的信息,并且相关来源是在执行过程中发现的,而不是提前已知。
相反,对于需要一次性处理完成的任务,应避免使用智能体循环。分类、简单问答以及格式转换通常不会从迭代中获得明显收益。为这些任务添加循环,只会增加延迟和成本,而不会提升质量。
9.2.8 构建重复任务循环智能体
智能体循环的第二种主要模式是重复任务完成(repetitive task completion)。与负责探索和发现的研究智能体不同,任务智能体拥有一个定义明确的工作队列,并按照顺序处理其中的任务。例如:
- 批量处理发票;
- 转换一系列文档;
- 针对多个端点运行测试;
- 将记录从一个系统迁移到另一个系统。
图 9.5 展示了重复任务循环智能体的架构。该智能体维护一个任务队列,每次迭代处理一个任务项,更新进度追踪器,并持续执行,直到队列为空或者满足终止条件。
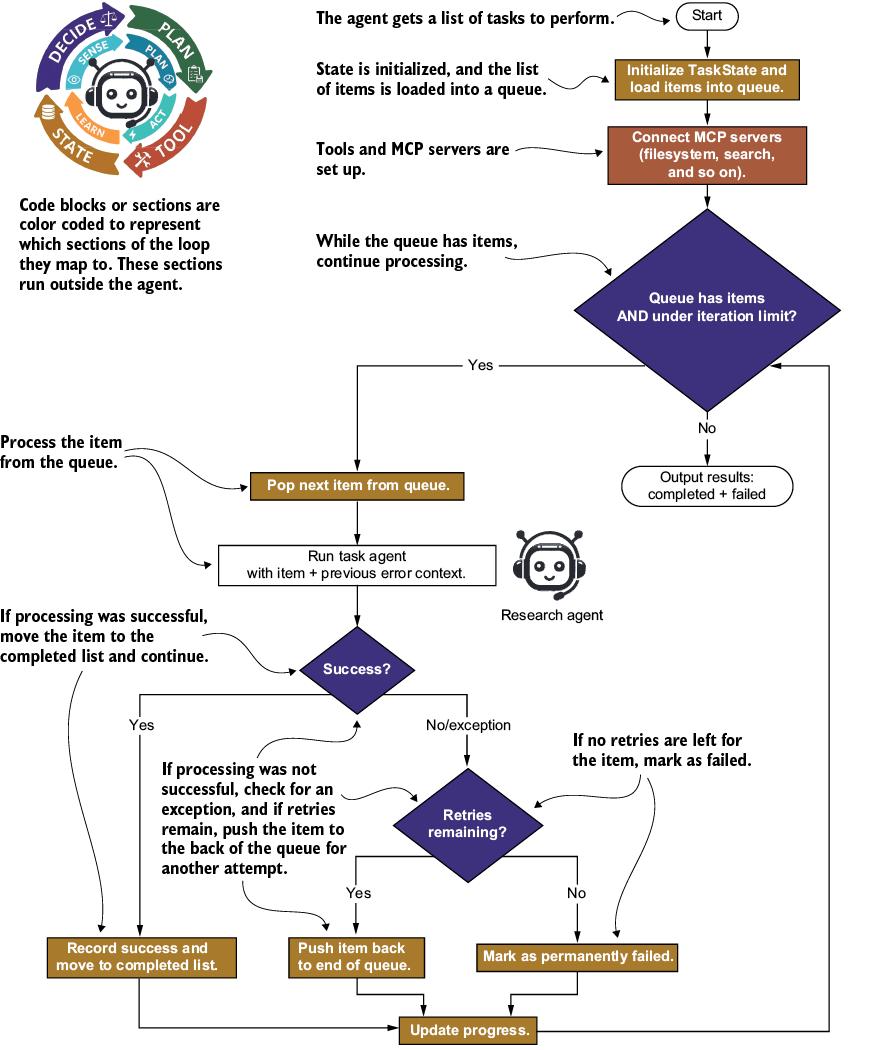
图 9.5 重复任务循环智能体的工作流程。智能体从任务队列中获取任务项,使用 MCP 服务器中的工具处理每个任务,记录结果,并跟踪进度,直到队列为空或触发停止条件。
再次强调,状态(任务项队列)和决策流程都位于执行任务的智能体之外。由于智能体是在遍历一个定义明确的列表,因此这种智能体循环变体不需要外部计划。
本章源码中的 07_task_loop.py 文件提供了任务循环智能体的代码实现。它展示了如何使用 MCP 文件系统服务器和 Brave Search 服务器处理文件列表。这个示例很容易调整,以适配其他你可能希望智能体执行的任务列表。
9.3 第三层:多智能体编排循环
在建立了第二层任务循环和研究循环之后,我们现在转向第三层元循环(meta loop)。回顾第 9.1 节,元循环将控制权从代码转移给智能体,使智能体负责 decide(决策)、state(状态)和 plan(规划)这些核心元素。在编排(orchestration)子类型中,单个编排器智能体会将工作委派给专门的子智能体,评估它们的结果,并决定是否再次循环或最终生成输出。
图 9.6 展示了由编排器控制的元循环架构。编排器维护全局计划和状态,通过工具调用的方式将独立任务分派给工作智能体,并评估所有输出是否满足目标要求。
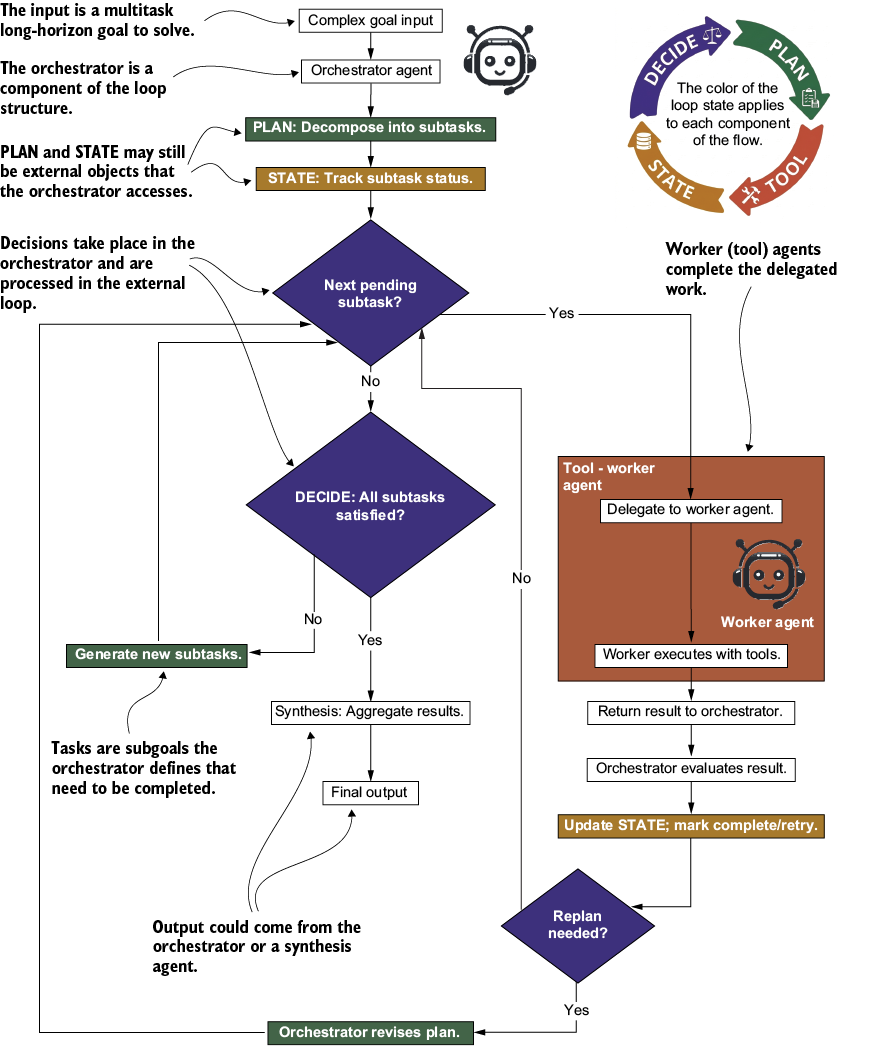
图 9.6 该图展示了编排器智能体循环流程。同时展示了状态和计划如何被访问和管理、执行哪些决策,以及任务如何被委派给工作智能体。
这种架构与第二层循环之间的关键区别在于:编排器本身就是一个由 LLM 驱动的智能体。它会推理下一步应该推进哪个子任务、工作智能体的输出是否足够好,以及是否需要调整整体计划。这使得元循环具备了硬编码 for 循环无法实现的自适应能力。
清单 9.7 展示了用于构建编排计划和决策模型的类型定义。随后会初始化研究智能体和分析智能体这些工作智能体,最后初始化编排智能体。
清单 9.7 08_orchestrator_loop.py(类型定义与智能体初始化)
class OrchestratorPlan(BaseModel):
"""The orchestrator's decomposition of a complex goal."""
sub_tasks: list[SubTopic] = Field(default_factory=list)
overall_strategy: str = ""
current_focus: str = ""
class OrchestratorDecision(BaseModel): #1
"""Output from the orchestrator after evaluating progress."""
next_action: str # "delegate" | "re_plan" | "finalize"
target_worker: str = "" # which worker to delegate to
task_description: str = ""
reasoning: str = ""
plan_updates: list[SubTopicUpdate] = []
is_complete: bool = False
research_worker = Agent( #2
name="Research Worker",
instructions="""You are a focused research worker.
You receive a specific research sub-task and execute it
thoroughly using your search tools. Return detailed findings
with sources. Do not deviate from the assigned sub-task.""",
model="gpt-5.1",
output_type=ResearchIteration,
)
analysis_worker = Agent( #3
name="Analysis Worker",
instructions="""You are a data analysis worker.
You receive findings and data to analyze. Identify patterns,
contradictions, and gaps. Return a structured analysis with
confidence assessments.""",
model="gpt-5.1",
output_type=ResearchIteration,
)
orchestrator_agent = Agent( #4
name="Research Orchestrator",
instructions="""
You are a research orchestrator managing a team of workers.
Your job is to decompose complex goals, delegate sub-tasks
to the right worker, evaluate their output, and decide
when the overall goal is satisfied.
Workers available:
- Research Worker: for searching and gathering information
- Analysis Worker: for analyzing and synthesizing findings
Each iteration, review the current state and plan, then decide:
1. "delegate" - assign a sub-task to a specific worker
2. "re_plan" - revise the plan based on new information
3. "finalize" - all sub-tasks complete, ready for synthesis
Always provide reasoning for your decision.
""",
model="gpt-5.1",
output_type=OrchestratorDecision,
)
注释:
- #1 编排器在每次迭代后返回的结构化输出,用于控制循环
- #2 一个具有搜索工具访问权限的专用研究工作智能体
- #3 一个用于综合和评估研究结果的专用分析工作智能体
- #4 控制元循环的编排器智能体,负责向工作智能体委派任务
清单 9.8 展示了编排器元循环的实现。编排器智能体将工作智能体作为工具使用,通过 OpenAI Agents SDK 的 handoff(交接)机制来委派工作并收集结果。
清单 9.8 08_orchestrator_loop.py(编排器元循环)
async def run_orchestrator_loop( #1
goal: str, max_iterations: int = 15
) -> ResearchState:
search_server = MCPServerStdio(
name="Brave Search",
params={
"command": "npx",
"args": ["-y", "@anthropic/brave-search-mcp"],
"env": {"BRAVE_API_KEY": os.environ["BRAVE_API_KEY"]},
},
)
async with search_server:
workers = { #2
"Research Worker": research_worker.clone(
mcp_servers=[search_server]
),
"Analysis Worker": analysis_worker,
}
state = ResearchState(
goal=goal, max_iterations=max_iterations,
follow_up_questions=[goal],
)
plan = OrchestratorPlan()
for iteration in range(max_iterations): #3
orch_input = dict(
goal=state.goal,
current_state=state.to_context(),
plan=str(dict(
sub_tasks=[
dict(name=st.name, status=st.status,
notes=st.notes)
for st in plan.sub_tasks],
strategy=plan.overall_strategy,
focus=plan.current_focus,
)),
iteration=iteration + 1,
max_iterations=max_iterations,
)
decision = (await Runner.run(
orchestrator_agent, input=str(orch_input)
)).final_output
if decision.is_complete or \
decision.next_action == "finalize": #4
state.status = "complete"
break
if decision.next_action == "delegate": #5
worker = workers.get(decision.target_worker)
if worker:
worker_result = (await Runner.run(
worker, input=decision.task_description
)).final_output
state.findings.append(
worker_result.summary_of_findings
)
state.sources_consulted.extend(
worker_result.sources_used
)
apply_plan_updates(
state.plan, worker_result
)
if decision.next_action == "re_plan": #6
for update in decision.plan_updates:
existing = {st.name: st
for st in plan.sub_tasks}
if update.name in existing:
existing[update.name].status = \
update.status
else:
plan.sub_tasks.append(SubTopic(
name=update.name,
status=update.status,
notes=update.notes,
))
state.iteration_count = iteration + 1
return state
注释:
- #1 运行带有 MCP 服务器配置的编排器循环的主函数
- #2 工作智能体被存储在一个字典中,供编排器进行动态调度。
- #3 编排器进行迭代,在每一步决定下一步应该执行什么操作。
- #4 如果编排器判断目标已经完成,则退出循环。
- #5 在进行任务委派时,编排器会将工作路由到合适的工作智能体。
- #6 在重新规划时,编排器会根据已获取的信息更新全局计划。
编排器模式之所以强大,是因为它将战略推理(应该推进哪个子任务、是否需要重新规划)与战术执行(搜索和分析)分离开来。编排器从不直接操作搜索工具;它负责推理下一步需要发生什么,并将实际工作委派出去。这与高效的人类管理者的工作方式类似:他们负责规划、委派和评估,而不是亲自完成每一项任务。
注意,编排器可以在循环过程中动态地重新规划。如果工作智能体的发现结果表明原始任务拆解并不完整,编排器可以添加新的子任务,或者重新调整现有任务的优先级。这种适应能力正是元循环相比静态的第二层循环,在处理复杂、多维度目标时更具能力的原因,尤其适用于那些在编排器解决问题过程中可能发生变化的目标。
编排器开销
编排器的每一次决策都需要调用一次 LLM。在一个包含 15 次迭代的循环中,除了工作智能体的调用之外,还会额外产生 15 次调用。对于那些任务拆解已经提前确定的简单任务,使用硬编码任务分发的第二层循环成本更低、速度更快。编排器模式应该保留给那些任务拆解本身存在不确定性,或者计划必须根据中间结果不断演化的目标。
9.4 构建协作型智能体循环
第三层元循环的第二种子类型是协作(collaboration),其中多个智能体作为平等参与者共同工作,而不是采用委派者-工作者的层级结构。在协作循环中,智能体共享状态,并共同决定何时达成目标。这里不存在单一的编排器;相反,智能体轮流参与贡献、批评和改进彼此的工作。
图 9.7 展示了协作型元循环的架构。多个智能体共享一个公共状态对象,并循环进行多轮贡献。一个轻量级的轮次管理器控制当前由哪个智能体行动,但智能体自身负责驱动内容生成,并决定何时停止。
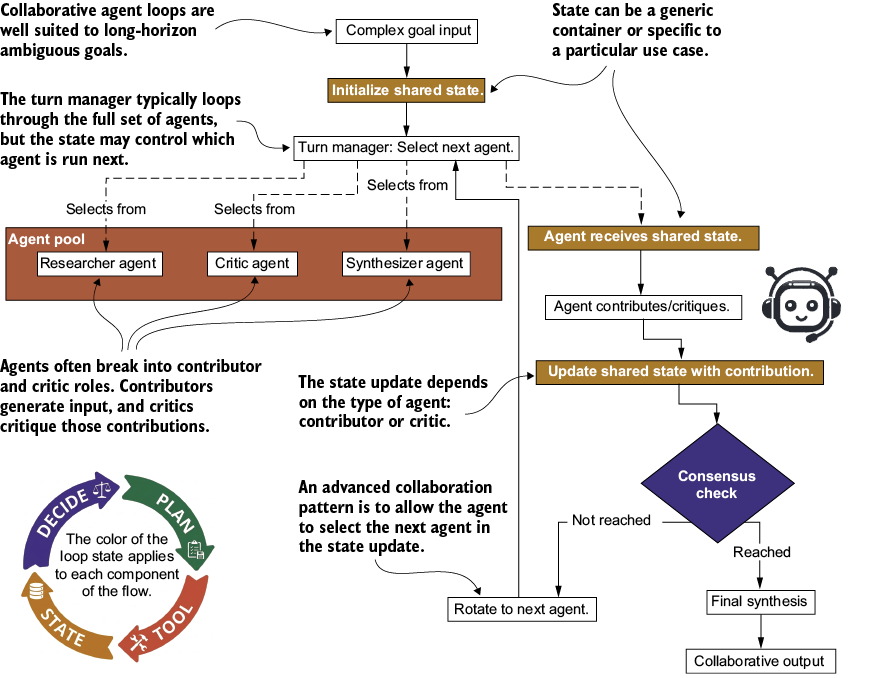
图 9.7 智能体协作型第三层元智能体循环的组件工作流程
当不同视角能够提升输出质量时,协作模式表现出色。一种常见配置是“研究者-批评者-综合者”三元组:一个智能体生成研究发现,另一个智能体对这些发现提出质疑并进行验证,第三个智能体则将经过验证的发现编织成连贯的叙事。每个智能体都可以看到完整的共享状态,包括其他智能体的贡献,因此每一轮都会基于集体成果继续构建,而不是依赖孤立的工作。
通常,在这种智能体循环协作模式中,智能体会遵循这样的循环:贡献者之后接批评者(负责提供依据、质量保证,或者由另一个智能体对工作进行批评)。更高级的模式可能会发展为由智能体自身选择下一个智能体。这可以让智能体在将结果发送给批评者之前,先对自己的工作进行迭代优化。从本质上讲,这使得一个第二层智能体循环能够存在于第三层协作元循环内部。
清单 9.9、9.10 和 9.11 展示了一个使用基于轮次轮换机制以及共享状态对象实现的协作循环。代码中涉及很多内容,但我们之前已经介绍过所有这些概念和模式。我们将从清单 9.9 开始,其中展示了类型化模型的构建。
清单 9.9 09_collaboration_loop.py(协作元循环)
class Contribution(BaseModel):
"""A single agent's contribution to the shared state."""
agent_name: str
content: str
critique: str = ""
suggestions: list[str] = []
agrees_goal_met: bool = False
confidence: float = 0.0
class CollaborationState(BaseModel):
"""Shared state for a collaborative agent loop."""
goal: str
contributions: list[Contribution] = Field(
default_factory=list
)
round_number: int = 0
max_rounds: int = 5
consensus_threshold: float = 0.8 #1
@property
def has_consensus(self) -> bool: #2
if len(self.contributions) < 2:
return False
recent = self.contributions[-3:]
if not recent:
return False
agreeing = sum(1 for c in recent if c.agrees_goal_met)
return agreeing / len(recent) >= self.consensus_threshold
def recent_context(self, n: int = 6) -> str:
recent = self.contributions[-n:]
return str([
dict(agent=c.agent_name, content=c.content[:500],
critique=c.critique, agrees=c.agrees_goal_met)
for c in recent
])
注释
- #1 共识阈值——最近参与的智能体中必须有多少比例同意目标已经达成
- #2 检查最近的智能体是否已经就目标满足情况达成共识
清单 9.10 展示了研究者、综合者和批评者智能体的初始化过程。
清单 9.10 09_collaboration_loop.py(智能体初始化)
researcher_agent = Agent( #1
name="Collaborative Researcher",
instructions="""
You are a researcher in a collaborative team. Review the shared
state and previous contributions. Search for new information that
fills gaps identified by the critic or extends existing findings.
Return your findings as content, note any concerns as critique,
and suggest next steps for the team. Set agrees_goal_met to true
only if you believe the research goal is comprehensively answered.
""",
model="gpt-5.1",
output_type=Contribution,
)
critic_agent = Agent( #2
name="Collaborative Critic",
instructions="""
You are a critic in a collaborative team. Review the shared state
and all contributions so far. Your job is to:
1. Identify weaknesses, gaps, or unsupported claims in findings
2. Challenge assumptions and flag contradictions
3. Suggest specific areas that need more research
Be constructive but rigorous. Set agrees_goal_met to true only
if you believe the collective findings are strong, well-sourced,
and comprehensive enough to answer the goal.
""",
model="gpt-5.1",
output_type=Contribution,
)
synthesizer_agent = Agent( #3
name="Collaborative Synthesizer",
instructions="""
You are a synthesizer in a collaborative team. Review all
contributions and weave them into a coherent narrative. Resolve
contradictions flagged by the critic, integrate the researcher's
findings, and produce a unified summary.
Set agrees_goal_met to true if the synthesized output
comprehensively answers the research goal. Your confidence score
should reflect how complete and well-supported the synthesis is.
""",
model="gpt-5.1",
output_type=Contribution,
)
注释:
- #1 研究者智能体向共享状态中贡献新的研究发现。
- #2 批评者智能体会对其他智能体的贡献提出质疑并进行验证。
- #3 综合者智能体将各个贡献整合成连贯的叙事。
最后,我们在清单 9.11 中构建协作循环函数,该函数负责控制循环并执行各个智能体。
清单 9.11 09_collaboration_loop.py(协作元循环)
async def run_collaboration_loop( #1
goal: str, max_rounds: int = 5
) -> CollaborationState:
agents = [researcher_agent, critic_agent,
synthesizer_agent]
search_server = MCPServerStdio(
name="Brave Search",
params={
"command": "npx",
"args": ["-y", "@anthropic/brave-search-mcp"],
"env": {"BRAVE_API_KEY": os.environ["BRAVE_API_KEY"]},
},
)
async with search_server:
agents[0] = researcher_agent.clone( #2
mcp_servers=[search_server]
)
state = CollaborationState(
goal=goal, max_rounds=max_rounds
)
agent_index = 0
while (state.round_number < state.max_rounds
and not state.has_consensus): #3
current_agent = agents[agent_index % len(agents)]
collab_input = dict(
goal=state.goal,
your_role=current_agent.name,
round=state.round_number + 1,
recent_contributions=state.recent_context(),
)
print(f"\nRound {state.round_number + 1}, "
f"Agent: {current_agent.name}")
result = await Runner.run(
current_agent, input=str(collab_input)
)
contribution = result.final_output
contribution.agent_name = current_agent.name
state.contributions.append(contribution)
print(f" Content: {contribution.content[:100]}...")
print(f" Agrees goal met: "
f"{contribution.agrees_goal_met}")
agent_index += 1
if agent_index % len(agents) == 0: #4
state.round_number += 1
return state
注释
- #1 运行协作循环的主函数,使用轮询方式(round-robin)轮换智能体
- #2 只有研究者需要搜索工具。批评者和综合者基于已有的研究发现开展工作。
- #3 循环会持续执行,直到达成共识或达到最大轮次限制。
- #4 当所有智能体都完成一次贡献时,一个完整轮次结束。
对于受益于对抗性验证的任务,协作模式相比单智能体循环能够产生更高质量的输出。批评者能够发现那些单独的研究智能体可能忽略的无依据声明和事实漏洞。综合者则会解决研究者和批评者在往返交流过程中暴露出的矛盾。每一轮循环都会进一步完善集体认知。
协作 vs 编排:什么时候使用哪一种
当目标天然可以拆解为相互独立的子任务,并且这些任务可以分配给不同专业智能体时,应使用编排模式。当子任务之间相互依赖,并且需要多种视角共同完善结果时,应使用协作模式。研究综合、文档审查和战略分析是协作模式的自然适用场景。数据流水线处理、并行搜索和批量转换则更适合采用编排模式。如果无法确定,应优先从编排模式开始(因为它更容易调试),只有当输出质量需要对抗性审查时,再升级为协作模式。
决定使用协作还是编排取决于具体使用场景。对于简单的批处理任务,编排模式效果很好。对于需要更强对抗性审查的任务,则应使用协作模式。
9.5 练习
使用以下练习来提升你对本章内容的理解:
练习 1:构建基础研究循环。
目标:实现一个能够围绕后续问题进行迭代的最小化智能体循环。
任务:
- 使用清单 9.1 中的
ResearchState和清单 9.3 中的ResearchIteration创建exercise1_basic_loop.py。 - 使用清单 9.4 中的指令定义一个研究智能体,但使用
@function_tool搜索工具替代 MCP(搜索类似第 7 章中的本地事实列表)。 - 设置
max_iterations=5,并使用你选择的目标作为循环初始目标。你选择的目标将受到所使用工具/MCP 服务器的引导。例如,如果你使用的是 Web 搜索 MCP 服务器,你的目标可以是查找关于 X 的信息。 - 运行循环,并打印迭代次数、发现数量以及最终状态。
预计耗时:15 分钟
练习 2:添加终止条件。
目标:为循环添加多层终止条件。
任务:
- 将你的文件复制为
exercise2_termination.py。 - 添加置信度阈值:如果智能体的置信度超过 0.85,则终止循环。
- 添加停滞检测:如果连续两个发现之间存在超过 80% 的词语重叠,则终止循环。
- 运行并与练习 1 的行为进行比较。
预计耗时:12 分钟
练习 3:构建带重试机制的任务循环。
目标:使用重试逻辑处理一批任务项。
任务:
- 使用清单 9.6 中的
TaskState创建exercise3_task_loop.py。 - 定义五个任务项(使用简单的文本转换任务)。
- 使用一个
@function_tool,让其随机以 30% 的概率失败,以模拟瞬态错误。此行为可以模拟任意类型的错误。 - 设置
max_retries=3并运行循环。打印最终完成率以及所有永久失败的任务项。
预计耗时:15 分钟
练习 4:实现并行任务处理。
目标:通过并行迭代提升任务处理速度。
任务:
- 将练习 3 复制为
exercise4_parallel.py。 - 使用清单 9.9 中的
asyncio.gather并行模式,实现batch_size=3的批量处理。 - 同时运行顺序版本(练习 3)和并行版本。比较两者的总执行时间和完成率。
- 添加注释说明加速倍数。
预计耗时:15 分钟
练习 5:构建编排器元循环。
目标:实现一个包含多个工作智能体的第三层编排器循环。
任务:
- 使用清单 9.7 和清单 9.8 中的编排模式创建
exercise5_orchestrator.py。 - 定义两个工作智能体:一个带有
@function_tool搜索工具的研究工作智能体,以及一个分析工作智能体。 - 在一个多维目标上运行编排器循环(例如:“比较太阳能和风能在住宅使用场景中的环境影响和成本效益”)。
- 打印编排器在每次迭代中的决策,以及最终聚合后的研究结果。
预计耗时:20 分钟
练习 6:构建协作循环。
目标:实现包含研究者、批评者和综合者智能体的协作循环。
任务:
- 使用清单 9.9 中的协作模式创建
exercise6_collaboration.py。 - 为研究者智能体使用
@function_tool搜索工具。 - 针对适合对抗性审查的主题运行循环,设置
max_rounds=3(例如:“AI 生成代码在生产系统中的风险和收益是什么?”)。 - 打印每个智能体的贡献,并跟踪是否达成共识。
- 将最终输出质量与针对同一主题的单智能体研究循环进行比较。
预计耗时:20 分钟
总结
- 智能体循环(agentic loop)是驱动研究智能体、任务智能体以及所有需要不断迭代以达成目标,而不是一次性回答的智能体的核心迭代引擎。
- 每个智能体循环都建立在三个支柱之上:目标(要实现什么)、迭代策略(每个循环周期执行什么)以及终止条件(何时停止)。在设计中,这三者都必须明确。
- 状态累加器(state accumulators)负责在不同迭代之间传递上下文。随着循环推进,可以通过截断、总结或压缩早期发现结果来控制智能体在每个周期中看到的内容,从而管理上下文窗口使用量。
- 强类型的迭代输出(Pydantic 模型)对于循环智能体来说是不可妥协的要求。循环控制器需要结构化数据,例如后续问题、目标满足标志以及置信度评分,来管理流程控制。
- 终止条件应该采用分层设计:硬性迭代限制(安全保护)、预算限制(成本控制)、目标满足情况(理想退出条件)、质量阈值(由评估器驱动)以及停滞检测(收益递减)。
- MCP 服务器为循环智能体提供动态工具发现能力,使智能体能够搜索网络、访问文件系统以及调用外部服务,而无需硬编码
@function_tool封装器。使用MCPServerStdio配合异步上下文管理器,可以实现清晰的生命周期管理。 - 深度研究循环通过“搜索-循环-综合”的方式不断迭代,累积研究发现并生成后续问题。在循环完成后,应使用独立的综合智能体将研究结果整理成经过润色的报告。
- 重复任务循环通过重试逻辑处理工作队列中的瞬态失败。需要明确跟踪已完成、失败和待处理的任务项,并在重试时将之前的错误反馈给智能体。
- 使用
asyncio.gather进行并行迭代,可以显著提升独立任务项的处理速度,但在启用之前需要注意速率限制,并确保任务之间确实相互独立。 - 自适应迭代预算允许智能体根据任务复杂度估算并请求迭代次数,同时遵守开发者设定的硬性上限。
- 永远不要在没有同时设置硬性迭代限制和成本上限的情况下部署智能体循环。一个没有约束的循环,就是一场等待发生的生产事故。