本章内容
- 理解 AI 应用中的检索
- 向量数据库与相似度搜索
- 构建具备 RAG 能力的 Agent
- 利用 MCP 为 Agent 添加记忆能力
到目前为止,我们构建的 Agent 都受限于模型训练时所学到的知识。它们无法回答用户昨天上传的文档内容,无法引用上周刚发布的新政策,也无法记住上一轮会话中与用户讨论过的事情。这些都是真实存在的限制,而且一旦 Agent 需要处理模型训练数据之外的信息,这些问题便会立即暴露出来。
本章的目标,就是解决这些问题。我们首先介绍检索,即一种能够从模型训练数据之外获取相关信息,并在恰当时机将其引入 Agent 上下文中的机制。正是检索能力,使 Agent 能够回答关于文档、政策、代码仓库以及其他外部知识源的问题。
随后,我们将进一步介绍记忆。从本质上来说,记忆就是将检索技术应用于 Agent 自身过去的经历。借助记忆,Agent 可以跨会话记住用户偏好,回忆此前尝试过的方法,并不断积累上下文,而不是每次交互都重新开始。检索与记忆共同作用,使 Agent 从一个没有状态的推理器(Stateless Reasoner),演变为一个能够获取知识并拥有持续记忆的智能系统。
6.1 理解 AI 应用中的检索
在 Agent 和聊天应用中,检索 是一种从外部长久存储中获取知识或记忆的机制。对于非结构化知识,通常包括历史对话、任务记录、事实、用户偏好等,这些信息主要用于丰富 Prompt 的上下文。而结构化知识一般存储在数据库或文件系统中,通过数据库查询、插件或原生函数进行访问。
Agent 的记忆可以包含许多内容,例如此前的对话记录、过去执行任务时积累的经验、关于用户的事实与偏好,以及其他具有参考价值的信息。从理论上讲,这些记忆可以无限增长,因为它们存储在模型之外,例如数据库、向量数据库或文件系统中,并不会受到 LLM 上下文窗口大小的限制。
真正受到限制的,是一次模型调用能够使用多少信息。上下文窗口决定了一次 Prompt 最多能够容纳多少 Token。目前主流模型的上下文窗口已经从约二十万 Token 扩展到一百万 Token 以上,但仍然是有限的。
检索机制正是连接这两者之间的桥梁。它能够从无限增长的外部存储中搜索信息,只挑选当前最相关的内容,将其放入当前 Prompt,使 Agent 能够利用这些信息完成当前任务。
表 6.1 展示了 Agent 中不同类型的知识与记忆,它们的来源、存储方式以及对应的检索机制。
表 6.1 Agent 中知识与记忆的来源、存储形式及检索方式
| 来源 | 存储形式 | 检索方式 |
|---|---|---|
| 短期记忆(上一轮会话) | Agent 或用户的对话文本 | 自动作为消息历史提供 |
| 长期记忆(历史用户会话) | 文本摘要或向量数据库中的语义向量 | 语义检索 / 向量检索 |
| 非结构化知识(PDF、文档等) | 向量数据库 + 文本索引 | 向量检索 + 关键词检索 |
| 结构化知识(数据库表、日志等) | 保持原始结构 | SQL 查询、日志解析 |
正如图 6.1 所示,知识 和 记忆 都可以作为额外上下文,补充到系统 Prompt 或 Agent 的指令中。增强的上下文既可以来自文档,也可以来自历史任务、历史对话或其他相关信息。无论是知识还是记忆,它们都来自模型之外的外部数据源,例如向量数据库、文档索引、关系数据库以及其他能够存储和检索信息的系统。
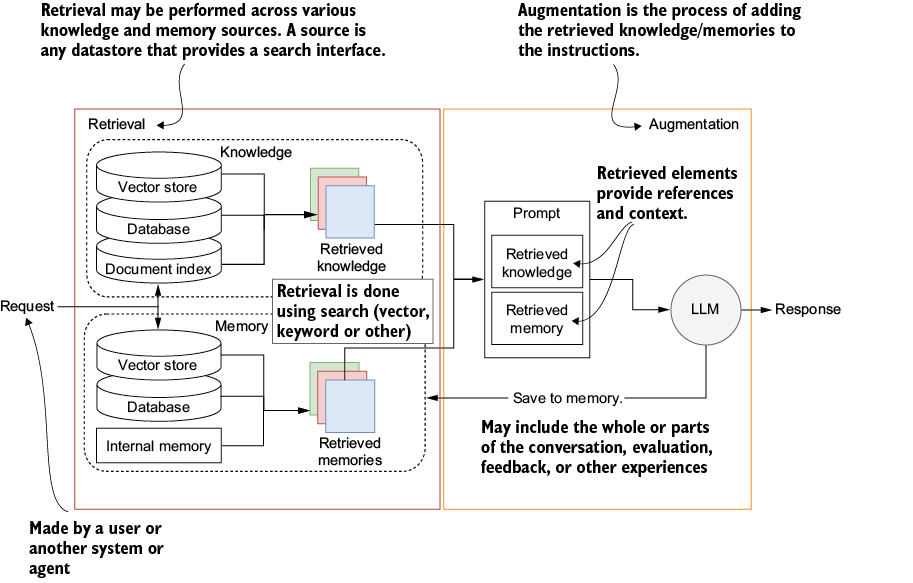
图 6.1 检索知识与记忆的流程,以及它们如何与上下文增强结合
检索与增强是让 Agent 使用知识和记忆的两个核心环节。其中,检索负责根据用户当前输入,在外部知识库中寻找相关信息;而增强则负责把检索得到的信息加入 Prompt,作为额外上下文提供给 LLM。
知识通常来源于文档、PDF、数据库表等外部信息源;而记忆则记录 Agent 或用户过去的经历,包括结构化和非结构化的信息。无论是哪一种,都依赖检索机制来查询和获取所需内容。
检索与增强结合起来,就形成了如今广泛采用的 RAG(Retrieval-Augmented Generation,检索增强生成)。RAG 已成为当前 Agent 获取知识和记忆的标准方案,因此理解其工作原理十分重要。
6.1.1 RAG 基础原理
近年来,RAG 已成为文档问答和知识问答系统中最流行的技术方案之一。典型流程如下:用户首先上传一份文档,例如 PDF。系统利用Embedding 模型将文档转换为向量,并存储到向量数据库中;随后,当用户提出问题时,系统会检索与问题最相关的文档片段,并把这些内容作为上下文提供给大语言模型生成最终答案。这里需要注意的是,Embedding 模型和 LLM 是两个完全不同的模型,它们承担不同的职责:
- Embedding 模型负责把文本编码成向量,用于语义相似度搜索;
- LLM 则负责根据检索出的内容生成自然语言答案。
图 6.2 将 RAG 分为了两个主要阶段:数据导入与检索。在导入阶段,系统会加载文档,将其切分为多个文本块,利用 Embedding 模型生成向量,并存储到可搜索的向量数据库中。在检索阶段,用户的问题同样会被转换成向量,随后在同一向量空间中寻找最相似的文本块,最后把这些文本块作为上下文交给 LLM,由其生成最终回答。
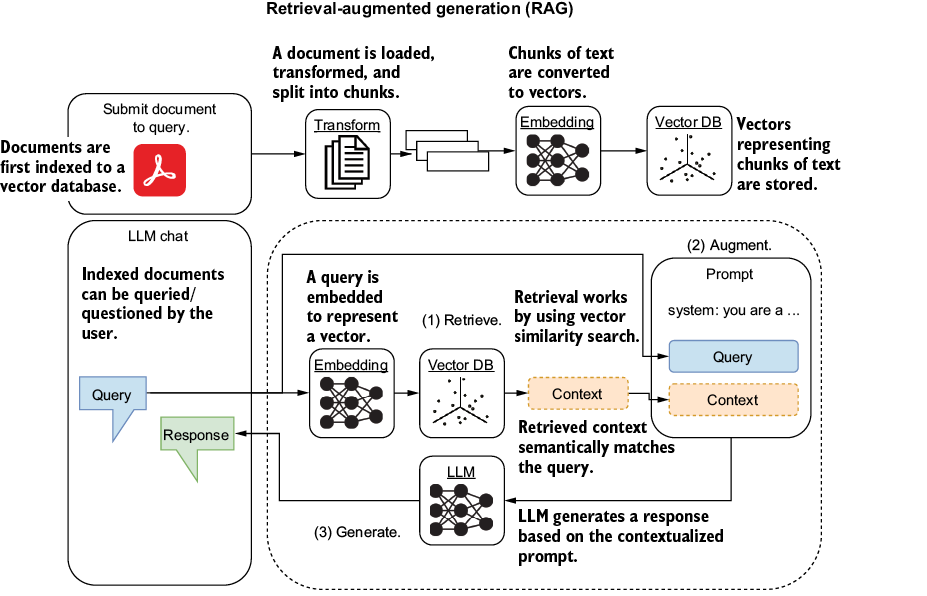
图 6.2 RAG 的两个阶段:数据导入与检索
用户可以针对已经完成索引的文档提出问题。系统首先将用户的问题编码为向量表示,然后利用该向量在向量数据库中查找最相似的文本块。找到匹配内容之后,系统会将这些内容作为 Prompt 的补充上下文,一并发送给 LLM,从而帮助模型生成更加准确、更有依据的回答。
例如,当用户提问:
"法国的首都是什么?"
系统首先利用 Embedding 模型将该问题转换为向量,然后在向量数据库中搜索语义最接近的内容。如果数据库中存在如下文本:
"法国的首都是巴黎"
那么这一文本便会被检索出来,并作为上下文加入 Prompt,最终 LLM 可以依据这段检索到的信息回答:
法国的首都是巴黎。
因此,LLM 的答案并非完全依赖模型参数中的知识,而是建立在检索得到的信息基础之上,从而具有更强的真实性和可追溯性。
向量数据库是一种专门用于向量相似度搜索的数据存储系统,而不是传统数据库那种按字段进行精确查询。传统数据库通常回答的问题是:
找到
user_id = 42的那一行数据。
而向量数据库回答的问题则更像:
找出哪些向量与当前查询向量最相似,并按相似度排序。
这里所说的稠密向量,指的是 Embedding 模型生成的向量表示。稠密向量通常由 384~3072 个浮点数组成,每一个维度都携带一定的语义信息,因此能够有效表达文本含义。这与稀疏向量不同,后者的大多数维度都为零,仅少量维度包含有效信息。截至 2026 年,主流的向量数据库包括:
- Pinecone
- Qdrant
- Weaviate
- Turbopuffer
- pgvector(PostgreSQL 的向量检索扩展,可直接为已有 PostgreSQL 数据库增加向量搜索能力)
这些数据库都能够高效执行向量相似度搜索,是当前 RAG 系统最常见的底层存储方案。
为什么 Agent 需要知识?
LLM 虽然是在海量数据上训练出来的,但它的内部知识会固定在训练完成的那一刻。举例来说,如果一个模型的知识截止时间是 2025 年,那么它就无法告诉你今天的股票价格、卡尔加里的实时天气、CAD 与 USD 的最新汇率、昨晚比赛的比分、你公司最新发布的价格政策,或者任何发生在知识截止日期之后的事情。
RAG 正是用来弥补这一缺陷的。它允许 Agent 在收到用户请求时,从外部数据源动态检索最新的信息。这样一来,模型本身就不再是系统中唯一的知识来源,而是充当位于知识层之上的推理引擎。真正的知识可以来自文档、数据库、API,或者 Agent 能够访问的任何外部资源。这种模式意味着,Agent 不再受限于"模型训练时记住了什么",而是能够"基于当前上下文推理最新获取到的知识"。
很多非结构化知识和长期记忆都会依赖语义相似度搜索,而不是传统的关键词匹配,这与图 6.2 展示的检索流程一致。语义搜索通过稠密向量比较查询内容与存储内容之间的语义相似性,因此即使查询的是 "vehicles",也能够匹配到讨论 "cars" 的文档,即使两个词完全不同。
图 6.3 展示了 Memory 的工作方式。它实际上复用了与 RAG 相同的 Embedding 模型和向量数据库,只不过输入的数据从预先导入的文档变成了用户的历史对话。对话内容会被切分、Embedding,并保存到向量数据库中。之后,无论是在当前会话还是未来的新会话中,系统都可以根据语义相似度检索出相关的历史内容,再作为上下文提供给 LLM。
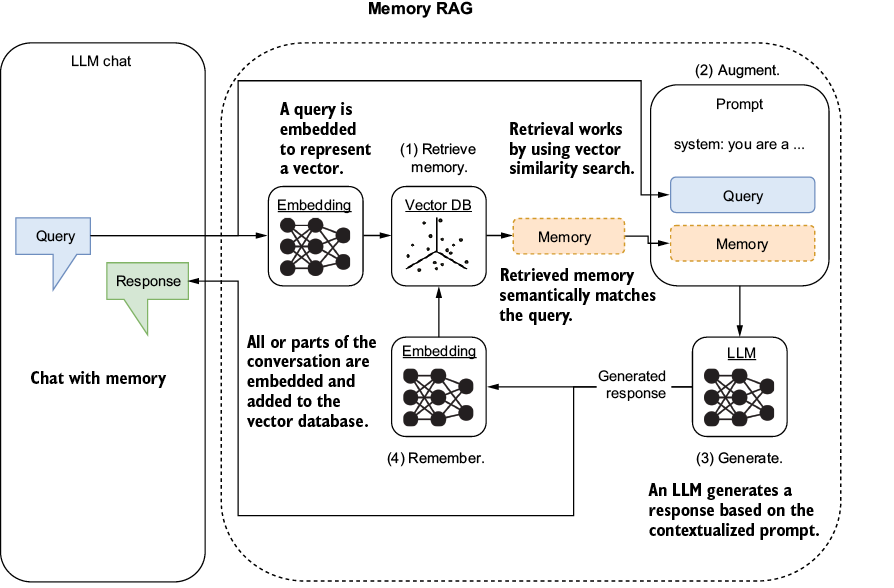
图 6.3 Memory 检索同样利用 Embedding 将内容编码为向量,并存储到向量数据库中,从而支持后续的检索增强生成。
不过,真正做好检索和文档索引并没有看起来那么简单。文档应该如何切分、如何建立索引、如何检索,都需要经过精心设计,否则即使拥有向量数据库,也很难获得高质量的检索效果。下一节将详细介绍这些关键问题。
6.1.2 深入理解语义搜索与文档索引
文档索引的目的,是把原始文档转换成便于语义检索的数据结构,使系统能够在后续根据用户的问题快速找到相关内容。文档如何建立索引,很大程度上取决于未来希望如何进行搜索。例如,是希望支持关键词搜索,还是希望能够做到整句话、整段内容的语义匹配,不同目标都会影响索引方式。
语义搜索与传统关键词搜索最大的区别在于,它匹配的是内容的含义,而不是文字本身。这种方式十分强大,因为开发者无需再人为维护大量关键词或同义词列表。正如上一节介绍的,无论是 RAG 还是 Memory,它们本质上都采用了相同的方法:利用 Dense Embedding,把查询语句与存储内容映射到同一个向量空间,再比较两者之间的语义距离。
不过,语义搜索也存在几个值得注意的问题。
第一,语义相似并不代表事实正确。检索系统只能判断两段内容是否"意思相近",却无法判断内容是真是假。例如,当用户搜索"治疗偏头痛的最佳方法"时,系统可能返回一篇语义非常相关的文章,但其中的治疗建议可能已经过时、存在错误,甚至来自一个不可靠的信息源。也就是说,向量数据库只能负责"找到相似内容",并不会负责验证事实真伪。
第二,大多数向量数据库都会返回固定数量的结果(Top-K),通常是最相似的 5 条或 10 条。如果真正需要的信息恰好排在第 11 位,它就会被直接丢弃。这种情况在以下场景尤其容易发生:一个问题存在多个正确答案,或真正相关的信息表达方式与查询差异较大,因此相似度稍低。因此,在实际项目中,开发者通常会调整 K 值,或者结合重排序(Re-ranking)等二次排序策略,提高最终检索质量。
第三,向量检索本身也是近似搜索,而不是绝对精确搜索。绝大多数向量数据库都会采用近似最近邻算法,以牺牲少量准确率换取极高的搜索速度。因此,数据库返回的结果通常只是"极有可能是最相似的内容",而不是数学意义上的绝对最近邻。对于绝大多数应用而言,这一点影响并不大;但当你调试某些"为什么没有检索出来"的问题时,这一点非常值得注意。
语义搜索最大的优势在于,它能够根据概念和语义进行匹配,而无需依赖完全一致的关键词。例如,如果查询的是 "dog",如果采用关键词搜索,那么只能找到真正包含 dog 这个单词的文档。而采用语义搜索后,系统还能够匹配到介绍**犬类(dogs)的文章、介绍具体犬种(例如 Cockapoo)的内容,甚至关于幼犬护理(Puppy Care)**或其他相关活动的资料,即使这些内容完全没有出现 dog 这个单词。
6.1.3 向量相似度搜索
在正式介绍语义 Embedding之前,我们先来看一种更简单、但并不能真正理解语义的方法。它就是经典的信息检索算法——TF-IDF(Term Frequency–Inverse Document Frequency,词频-逆文档频率)。TF-IDF 会根据单词是否出现以及该单词在整个文档集合中的重要程度,把文本转换成一个稀疏向量(Sparse Vector)。虽然它并不能表达文本的真正语义,但由于原理简单,非常适合作为理解向量检索机制的入门方法。
TF-IDF 衡量的是词的重要程度,而不是词的含义。例如,当用户搜索 "vehicles" 时,它无法匹配讨论 "cars" 的文档,因为两个词本身并不相同。这正是 TF-IDF 的天然局限,也是后来语义 Embedding出现的原因。
语义 Embedding 则完全不同。它由经过训练的神经网络生成,将文本映射到一个高维稠密向量空间,使语义相近的文本即使使用完全不同的词汇,也会落到相邻的位置。正是这种训练过程,让 Embedding 具备了理解语义的能力,而不是简单统计词频。本章先介绍 TF-IDF,是因为它实现起来更加简单,更容易理解整个检索流程;随后我们会进入真正决定现代 RAG 性能的核心——语义 Embedding。
请打开 chapter_06 文件夹,并在新的 VS Code 工作区中创建 Python 虚拟环境。随后使用 pip 安装 requirements.txt 中列出的所有依赖。如果你不熟悉 Python 环境配置,可以参考附录 A。
接下来,打开 document_vector_similarity.py 文件,查看代码顶部,如代码清单 6.1 所示。该示例采用的是 TF-IDF。TF-IDF 是一种数值统计方法,用来衡量某个词对于某篇文档的重要程度。一个词在文档中出现得越频繁,它的重要性越高;但如果它在整个文档集合中也非常常见,那么它的重要性又会相应降低。因此,TF-IDF 能够较好地衡量一个词在整个文档集合中的区分能力。
代码清单 6.1 document_vector_similarity(将文本转换为向量)
import plotly.graph_objects as go
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
documents = [ #1
"The sky is blue and beautiful.",
"Love this blue and beautiful sky!",
"The quick brown fox jumps over the lazy dog.",
"A king's breakfast has sausages, ham, bacon, eggs, toast, and beans",
"I love green eggs, ham, sausages and bacon!",
"The brown fox is quick and the blue dog is lazy!",
"The sky is very blue and the sky is very beautiful today",
"The dog is lazy but the brown fox is quick!"
]
vectorizer = TfidfVectorizer() #2
X = vectorizer.fit_transform(documents) #3
注释:
- #1 示例文档集合
- #2 使用 TF-IDF 进行向量化
- #3 将所有文档转换为向量表示
下面,我们以示例句子:The sky is blue and beautiful中的单词 blue 为例,分别看看 TF-IDF 的两个组成部分。
词频(Term Frequency,TF)
词频(TF) 用来衡量某个词在当前文档中出现得有多频繁。对于单篇文档来说,最简单的计算方式就是:某个词出现次数 ÷ 文档总词数。在我们的例子中,blue 出现次数是1 次,文档总词数是 6 个。因此:TF = 1 ÷ 6 ≈ 0.16
逆文档频率(Inverse Document Frequency,IDF)
逆文档频率(IDF)用来衡量一个词在整个文档集合中的重要程度。计算公式为:IDF = log(文档总数 ÷ 包含该词的文档数量)。实际工程实现中,为了避免某个词完全不存在导致分母为 0,通常都会在分母中加入一个很小的常数,例如:log(N / (n + ε))。假设当前共有 8 篇文档,其中 blue 出现在 4 篇文档中,则:IDF = log(8 ÷ 4)。随后即可将 TF 与 IDF 相乘,得到该词最终的 TF-IDF 权重。
TF-IDF 的计算
最后,TF-IDF 分数就是将 TF(词频) 与 IDF(逆文档频率)相乘得到:TF-IDF = TF × IDF。下面继续使用前面的示例,计算单词 blue 的实际 TF-IDF 值。首先计算词频(Term Frequency),也就是 blue 在当前文档中出现的频率:TF = 1 ÷ 6。假设采用以 10 为底 的对数(这是最常见的做法),则逆文档频率(IDF)的计算方式为:IDF = log10(8 ÷ 4)。接下来即可得到 "The sky is blue and beautiful" 这句话中 blue 的 TF-IDF 值。其中:TF(词频)≈ 0.167, IDF(逆文档频率)≈ 0.301。因此:
TF-IDF = TF × IDF
≈ 0.167 × 0.301
≈ 0.050
这个 0.050 就表示 blue 在当前文档中的相对重要程度。这里的"重要程度"并不是指这个词本身有多重要,而是指它在当前文档中具有多大的区分能力。在本例中,我们的语料库共有 8 篇文档,其中 blue 出现在 4 篇中,因此它既不是一个非常罕见的词,也不是一个几乎所有文档都会出现的高频词,所以最终得到一个中等偏低的 TF-IDF 分数。一般来说,TF-IDF 分数越高,说明该词越能代表当前文档的特点。
之所以这里介绍 TF-IDF,是因为它既容易理解,也容易实现。当文本被表示成向量之后,我们就可以进一步利用余弦相似度(Cosine Similarity)来衡量不同文档之间的相似程度。余弦相似度计算的是两个非零向量之间夹角的余弦值,因此它关注的是方向是否一致,而不是向量本身有多长。换句话说,它衡量的是两个文档是否表达了相似的内容,而不会受到文本长度的明显影响。
余弦相似度之所以成为目前最常用的相似度指标,是因为它既适用于 TF-IDF 产生的稀疏向量,也适用于后面将介绍的语义 Embedding。它最大的特点是忽略向量长度,只关注向量方向。因此,即使两篇文档长度相差很大,只要它们包含相近比例的重要特征,它们仍然会被认为具有较高的相似度。对于信息检索而言,这通常正是我们希望得到的效果。相比之下,像欧氏距离或点积等指标都会受到向量长度的影响。虽然这些方法在某些检索场景中也很有价值,但很多时候会因为文档长短不同而引入额外噪声,因此并不是默认首选。
尽管余弦相似度与 TF-IDF 配合得很好,但它也存在一些局限。由于 TF-IDF 得到的是高度稀疏的向量,因此有时两篇文档仅仅因为共享了几个较少见的单词,就可能获得较高的余弦相似度。这种情况容易产生误匹配。而后面介绍的语义 Embedding属于稠密向量(Dense Vector),每个维度都携带一定的语义信息,因此能够更准确地表达文本含义,这也是现代 RAG 系统普遍采用 Embedding 而不是 TF-IDF 的主要原因。
图 6.4 展示了余弦相似度如何比较两段文本(或两个文档)对应向量之间的夹角。余弦相似度的取值范围通常为 -1 到 1:
- 1 表示两个向量方向完全一致,即内容最相似;
- 0 表示两者彼此无关;
- -1 表示方向完全相反。
与之对应的还有一个概念叫余弦距离(Cosine Distance)。它通常定义为:Cosine Distance = 1 - Cosine Similarity。因此,余弦距离的取值范围一般为 0 到 2:
- 0 表示两个对象完全一致;
- 2 表示完全相反。
不过,在本例中,由于 TF-IDF 向量全部都是非负数,因此所有向量都位于第一象限,所以实际得到的余弦相似度都会落在 0~1 之间。
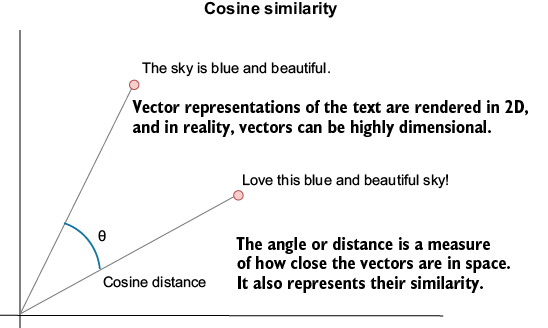
图 6.4 余弦相似度通过比较两个向量之间的夹角来衡量它们的相似程度,可应用于任意维度的向量空间。
在阅读代码清单 6.2 之前,先理解底层计算过程会更容易看懂代码。首先,语料库中的每一句话都会经过 TF-IDF 转换成一个向量。向量中的每一个位置都对应整个语料库中的一个词汇。如果整个语料库共有 10000 个不同的单词,那么每个句子都会被表示成一个长度为 10000 的向量。其中,出现在当前句子中的词,其对应位置保存 TF-IDF 值,没有出现的词,则对应位置为 0。因此,一个只包含几百个单词的句子,最终得到的向量依然可能有几万个维度,只不过绝大多数位置都是 0。
随后,cosine_similarity() 会两两比较所有文档对应的向量。假设共有 N 篇文档,那么最终会生成一个 N × N 的相似度矩阵。矩阵中:
- 第 i 行、第 j 列表示第 i 篇文档与第 j 篇文档之间的相似度;
- 该矩阵关于主对角线完全对称,因为 A 与 B 的相似度等于 B 与 A 的相似度;
- 主对角线上的值全部都是 1,因为任何文档与自身的相似度都等于 1。
代码清单 6.2 就利用 scikit-learn 提供的 cosine_similarity() 函数完成了这一计算。最终得到的相似度矩阵保存在变量 cosine_similarities 中。程序随后通过一个输入循环,让用户选择任意一篇文档,并查看它与其它所有文档之间的相似度。实际上,只需要查看矩阵中的某一行,就可以知道对应文档与整个语料库中其它所有文档的相似程度。
代码清单 6.2 document_vector_similarity(余弦相似度计算)
cosine_similarities = cosine_similarity(X) #1
while True: #2
selected_document_index = input(f"Enter a document number
➥ (0-{len(documents)-1}) or 'exit' to quit: ").strip()
if selected_document_index.lower() == 'exit':
break
if not selected_document_index.isdigit() or \
not 0 <= int(selected_document_index) < len(documents):
print("Invalid input. Please enter a valid document number.")
continue
selected_document_index = int(selected_document_index) #3
selected_document_similarities = cosine_similarities[selected_document_index] #4
# code to plot document similarities omitted
注释:
- #1 计算所有文档两两之间的余弦相似度。
- #2 主输入循环。
- #3 获取用户选择的文档编号。
- #4 提取该文档与其它所有文档之间的相似度结果。
图 6.5 展示了该程序在 VS Code 中运行后的效果(按 F5 即可进入调试运行)。选择任意一篇文档之后,程序会显示它与其它所有文档之间的余弦相似度。需要注意的是,每篇文档与自身的相似度始终都是 1。另外,由于 TF-IDF 生成的是非负向量,因此这里不会出现负的余弦相似度。后面的章节还将介绍更加先进、更能体现文本语义的相似度计算方法。
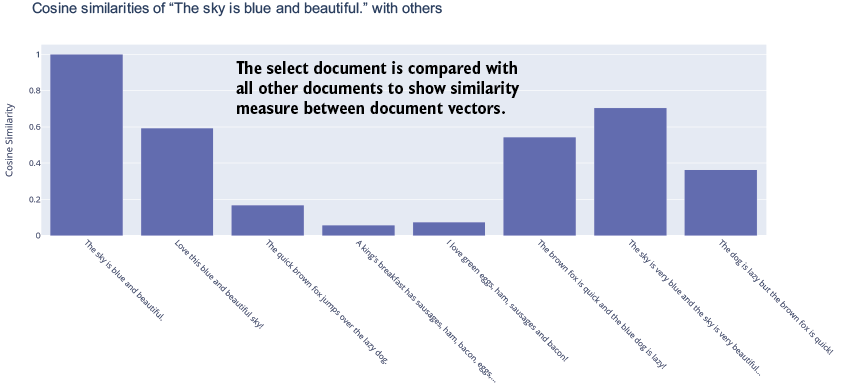
图 6.5 选定文档与整个文档集合之间的余弦相似度结果。
文本采用哪一种向量化方法,将直接决定最终能够计算出的语义相似度质量。在继续介绍更加先进的文本向量化方法之前,我们先来了解一下向量数据库是如何存储这些向量,并支持高效相似度检索的。
6.2 向量数据库与相似度搜索
在将文档向量化之后,我们就可以把这些向量存储到向量数据库中,以便后续执行相似度搜索。为了演示这一过程,我们可以先用 Python 编写一个简单的示例,高效地模拟一个基础的向量数据库。
打开 VS Code 中的 document_vector_database.py 文件,如代码清单 6.3 所示。这段代码演示了如何在内存中创建一个简单的向量数据库,并允许用户输入查询文本,对数据库进行搜索并返回最相似的结果。返回的结果不仅包含匹配到的文档内容,还会显示对应的相似度分数。
代码清单 6.3 document_vector_database.py
# 上方代码省略
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(documents)
vector_database = X.toarray() #1
def cosine_similarity_search(query,
database,
vectorizer,
top_n=5): #2
query_vec = vectorizer.transform([query]).toarray()
similarities = cosine_similarity(query_vec, database)[0]
top_indices = np.argsort(-similarities)[:top_n] # Top n indices
return [(idx, similarities[idx]) for idx in top_indices]
while True: #3
query = input("Enter a search query (or 'exit' to stop): ")
if query.lower() == 'exit':
break
top_n = int(input("How many top matches do you want to see? "))
search_results = cosine_similarity_search(query,
vector_database,
vectorizer,
top_n)
print("Top Matched Documents:")
for idx, score in search_results:
print(f"- {documents[idx]} (Score: {score:.4f})") #4
print("\n")
### 输出
Enter a search query (or 'exit' to stop): blue
How many top matches do you want to see? 3
Top Matched Documents:
- The sky is blue and beautiful. (Score: 0.4080)
- Love this blue and beautiful sky! (Score: 0.3439)
- The brown fox is quick and the blue dog is lazy! (Score: 0.2560)
注释:
- #1 将文档向量保存到数组中,作为简单的向量数据库。
- #2 定义执行余弦相似度搜索的函数,输入查询后返回最匹配的文档及其相似度分数。
- #3 主输入循环,持续接收用户输入的查询内容。
- #4 遍历搜索结果,输出匹配到的文档文本以及对应的相似度分数。
运行这个示例(在 VS Code 中按 F5 即可)。你可以输入任意文本作为查询,观察返回的搜索结果。这种搜索方式对于查找包含相同单词或相似短语的文档效果不错,但它仍然无法真正理解文档的上下文和语义。例如,查询 "automobile" 可能无法匹配主要使用 "car" 一词的文档,因为 TF-IDF 关注的是词项本身,而不是它们表达的含义。因此,我们需要一种更先进的方法,将文档转换为能够更好保留语义信息的向量表示。这正是下一节将要介绍的语义嵌入(Semantic Embeddings)技术。
6.2.1 揭开文档嵌入的神秘面纱
TF-IDF 是一种纯统计方法,它依据单词在文档中的出现频率来衡量其重要性,并不会尝试理解文本的语义。因此,把 TF-IDF 看作一种“效果不佳的语义方法”其实并不准确,因为它本来就不是为理解语义而设计的。对于那些必须精确匹配关键词的场景,例如查找某个专有名词、代码标识符或罕见术语,TF-IDF 具有速度快、行为可预测,并且在很多情况下甚至比语义嵌入更准确的优势。
TF-IDF 的局限在于,它无法根据含义进行匹配。例如,查询 "vehicles"(交通工具)时,并不会匹配到讨论 "cars"(汽车)的文档,因为两者使用了不同的词汇,即使它们表达的是密切相关的概念。语义嵌入正是为了解决这一问题而提出的。它将文本映射到一个向量空间中,使语义相近的内容在空间中彼此靠近,而不仅仅依赖于是否使用了相同的单词。下一节将详细介绍这一机制。
在生产环境中,效果最好的检索系统通常不会二选一,而是将两者结合起来使用。我们稍后会介绍的混合检索,就是同时执行 TF-IDF(或 BM25)检索和语义向量检索,然后融合两种结果。这种方式既能获得关键词精确匹配的优势,又能拥有语义召回的能力。因此,TF-IDF 并不是一种“不可靠”的技术,它只是检索系统中的一种重要信号。
嵌入模型本质上是经过训练的神经网络,它们能够把文本转换为稠密向量,使语义相近的文本映射到彼此接近的位置。目前已经有大量可直接使用的预训练模型,例如 OpenAI、Anthropic、Cohere、Hugging Face,以及开源项目 sentence-transformers 提供的模型。这些模型输出的向量维度通常在 384~3072 个浮点数之间,具体取决于所使用的模型。
从 TF-IDF 跳跃到神经网络嵌入,是一次非常大的技术升级,因此有必要对其原理建立一个基本认识。在训练过程中,模型会接触海量文本数据,并学习完成各种预测任务,例如预测下一个单词、判断两个句子是否相关、识别哪段文本能够回答某个问题等。这些训练目标迫使模型必须理解文本的语义关系,而不仅仅是记住单词本身。最终,模型学会了把语义信息编码到向量空间的几何结构中,因此具有相似含义的文本,其向量自然会彼此靠近。
神经嵌入还有一个值得注意的特点。TF-IDF 的每一个维度都具有明确的人类可解释意义,例如某一个维度对应某个具体单词;而神经网络生成的嵌入向量则不同,每一个维度都是模型自动学习出来的,人类通常无法解释它代表什么。因此,我们并不是通过单独分析每一个维度来理解嵌入,而是通过向量之间的关系——例如相似度、距离和方向——来理解文本之间的语义联系。
接下来的示例将使用 OpenAI 提供的嵌入模型。这类模型属于性能优秀的通用语义嵌入模型,能够很好地处理绝大多数常见文本内容,但它们也并非万能。例如,它们仍然会受到训练数据偏差的影响;对于法律、医疗、程序代码等专业领域,或者训练数据较少的语言,其表现可能没有通用领域那么优秀;面对差异极大的内容类型时,也可能出现一定的不一致性。
代码清单 6.4 展示了如何调用 OpenAI 的嵌入接口,将文档转换为向量,并进一步将高维向量降至三维后进行可视化展示。对于那些对领域准确率要求较高的生产系统,更合理的做法是根据自己的文档和查询场景,对多个嵌入模型进行评估,而不是默认选择某一个模型。
代码清单 6.4 document_visualizing_embeddings.py(关键代码)
load_dotenv() #1
api_key = os.getenv('OPENAI_API_KEY')
if not api_key:
raise ValueError("No API key found. Please check your .env file.")
client = OpenAI(api_key=api_key) #1
def get_embedding(text, model="text-embedding-ada-002"): #2
text = text.replace("\n", " ")
return client.embeddings.create(input=[text],
model=model).data[0].embedding #2
embeddings = [get_embedding(doc) for doc in documents] #3
print(embeddings_array.shape)
embeddings_array = np.array(embeddings) #4
pca = PCA(n_components=3) #5
reduced_embeddings = pca.fit_transform(embeddings_array)
注释:
- #1 加载
.env文件中的 OpenAI API Key,并创建 OpenAI 客户端。 - #2 调用 OpenAI Embedding 接口,将文本转换为向量表示。
- #3 为每篇文档生成一个 1536 维的嵌入向量。
- #4 将所有嵌入向量转换为 NumPy 数组,便于后续计算。
- #5 使用 PCA(主成分分析)将高维向量降到三维,以便进行可视化。
当使用 OpenAI 的嵌入模型处理文档时,每篇文档都会被转换为一个 1536 维向量。如此高维的数据无法直接进行可视化,因此这里采用主成分分析(PCA)进行降维,将 1536 个维度压缩为 3 个维度,同时尽可能保留原始数据中的主要信息。
图 6.6 展示了运行该程序后的结果。经过降维之后,我们便可以在三维空间中绘制这些向量,从而直观地观察哪些文档因为语义相似而聚集在一起。
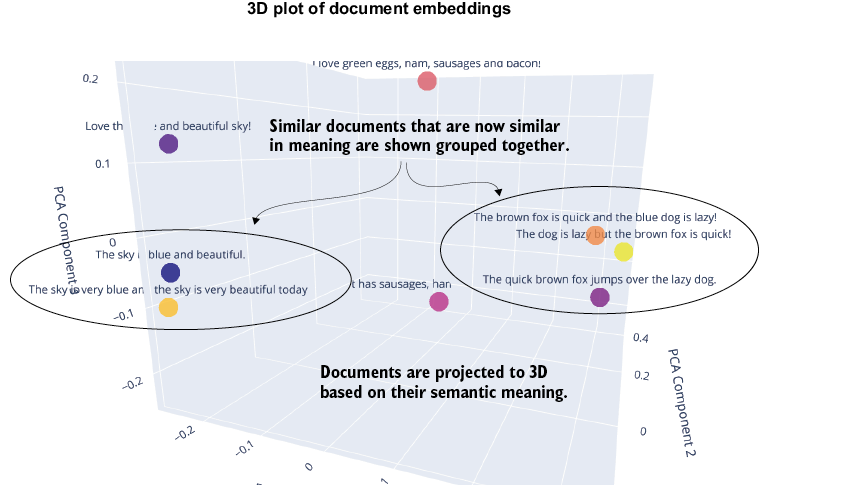
图 6.6 三维空间中的文档嵌入,可直观展示语义相近的文档如何聚集在一起
具体使用哪一种嵌入模型或服务,由开发者自行选择。OpenAI 的嵌入模型目前被广泛认为是通用语义相似度任务中表现最优秀的方案之一,因此已经成为大多数记忆系统和检索增强生成(RAG)应用的默认选择。现在,我们已经了解了如何利用嵌入模型将文本转换为向量,并将这些向量存储到向量数据库中。接下来,我们将进入一个更加贴近真实应用场景的案例。
6.2.2 使用 Chroma DB 查询文档嵌入
现在,我们可以把前面介绍的各个组成部分组合起来,构建一个完整的检索示例。这里使用的是一个本地向量数据库——Chroma DB。目前市面上存在许多向量数据库产品,而 Chroma DB 非常适合本地开发、学习以及中小规模项目。当然,在后续构建生产系统时,你也可以根据需求选择功能更完善的其他方案。
代码清单 6.5 展示了 document_query_chromadb.py 文件中的关键代码。需要注意的是,这里返回的不是相似度,而是距离。其中,余弦距离的计算公式如下:
Cosine Distance(A,B) = 1 − Cosine Similarity(A,B)
因此,余弦距离越小,表示两个向量越相似。距离为 0 表示两个向量几乎完全一致;距离越大,相似度越低;理论上的最大值为 2,表示两个向量方向完全相反,即语义完全相反。
代码清单 6.5 document_query_chromadb.py(关键代码)
embeddings = [get_embedding(doc) for doc in documents] #1
ids = [f"id{i}" for i in range(len(documents))] #2
chroma_client = chromadb.Client() #2
collection = chroma_client.create_collection(
name="documents") #2
collection.add(
embeddings=embeddings,
documents=documents,
ids=ids
)
def query_chromadb(query, top_n=2): #4
query_embedding = get_embedding(query)
results = collection.query(
query_embeddings=[query_embedding],
n_results=top_n
)
return [(id, score, text) for id, score, text in
zip(results['ids'][0],
results['distances'][0],
results['documents'][0])]
while True: #5
query = input("Enter a search query (or 'exit' to stop): ")
if query.lower() == 'exit':
break
top_n = int(input("How many top matches do you want to see? "))
search_results = query_chromadb(query, top_n)
print("Top Matched Documents:")
for id, score, text in search_results:
print(f"""
ID:{id} TEXT: {text} SCORE: {round(score, 2)}
""")
print("\n")
输出示例
Enter a search query (or 'exit' to stop): dogs are lazy
How many top matches do you want to see? 3
Top Matched Documents:
ID:id7
TEXT: The dog is lazy but the brown fox is quick!
SCORE: 0.24
ID:id5
TEXT: The brown fox is quick and the blue dog is lazy!
SCORE: 0.28
ID:id2
TEXT: The quick brown fox jumps over the lazy dog.
SCORE: 0.29
注释:
- #1 为每篇文档生成嵌入向量,并分配唯一 ID。
- #2 创建 Chroma DB 客户端,并建立一个文档集合。
- #3 将文档、对应的嵌入向量以及 ID 添加到集合中。
- #4 根据用户查询生成嵌入向量,在数据库中检索最相关的前 n 条文档。
- #5 主输入循环,负责接收用户输入,并输出检索到的文档及对应距离分数。
正如前面的示例所展示的,现在我们已经可以依据文本的语义含义进行检索,而不仅仅依赖关键词或短语是否一致。通过这些示例,你应该已经能够理解整个检索流程是如何工作的。有了这些基础知识之后,接下来我们将开始学习如何构建真正实用的 RAG 智能体。
6.3 构建实用的 RAG 知识智能体
相似度搜索或向量搜索为构建 RAG 系统提供了非常优秀的基础能力。然而,仅依赖向量搜索并不足以构建一个真正实用的 RAG 系统。正如下一节将要介绍的,在实际构建 RAG 系统或 RAG 智能体时,我们通常会组合多种不同的检索方式,而不是只依赖单一的向量检索。
6.3.1 一切都始于搜索与相关性
获取信息的方法有很多种。向量搜索(或语义相似度搜索)的优势在于,它通常能够找到语义相同或相近的文档。随后,我们把这些语义相似的文档作为上下文提供给 LLM 或智能体,再由模型从中筛选出真正有用的信息。这种方式虽然简单有效,但也会带来一些问题。表 6.2 总结了仅依赖向量搜索进行上下文检索时最常见的一些不足。
表 6.2 语义/向量搜索的常见局限
| 问题(使用场景) | 简单示例 | 解决方案(对应检索方法) |
|---|---|---|
| 无法匹配精确的单词或数字 | 查询“显示错误代码 P0420 的公告”,结果却返回了一堆排气系统的通用文档,却没有真正包含 P0420 的页面。 | 使用关键词搜索进行精确匹配,或采用混合检索(Keyword + Vector),确保能够命中具体代码。 |
| 行业术语或缩写容易混淆 | 用户搜索 Freon,而文档全部使用 refrigerant(制冷剂),结果正确的 HVAC 文档没有被检索出来。 | 为关键词搜索增加同义词词典,或者采用混合检索,同时利用关键词和语义信息。 |
| 大量重复内容占据搜索结果 | 同一份产品说明书有十几份副本,占满了 Top-K,导致其他更有价值的文档无法进入结果。 | 在向量搜索基础上加入 MMR(最大边际相关性) 或去重(Dedup),再结合混合检索,让具有不同关键词的文档也有机会进入结果。 |
| 内容相关,但没有真正回答问题 | 用户问“Model X 是什么时候发布的?”,返回的却是一篇产品对比文章,其中根本没有发布日期。 | 采用两阶段混合检索:先利用向量搜索召回候选文档,再通过关键词搜索、关系数据库过滤或重排序(Rerank)提高准确率。 |
| 无法理解实体之间的关系 | 查询“谁向 Alice 的经理汇报工作?”,需要组织架构关系,而普通向量搜索无法推理这种关系。 | 在向量搜索之外,引入知识图谱或关系数据库(SQL)查询能力。 |
| 检索结果容易过时 | 昨天商品价格刚刚调整,但嵌入向量尚未更新,因此仍然返回旧价格。 | 将实时数据保存在**关系数据库(SQL)**中,并结合实时数据库查询与向量检索共同完成回答。 |
| 一词多义导致语义理解错误 | 查询“Mouse care guide”,结果返回的是电脑鼠标使用手册,而不是宠物老鼠饲养指南。 | 利用关键词过滤类别信息,或采用混合检索,提高相关主题词的权重。 |
| 可能泄露受限内容 | 向量检索把 HR 的保密记录返回给了没有权限的用户。 | 对向量索引实施访问控制(ACL),并结合关键词过滤或基于权限的数据库查询进行二次过滤。 |
从这些例子可以看出,如果完全依赖向量搜索作为文档检索方式,在实际应用中会遇到各种问题。因此,在任何真正投入生产的 RAG 系统或 RAG 智能体中,几乎都会组合多种不同的检索技术,而不是只依赖一种搜索方式。除了向量搜索之外,我们还可以结合多种检索技术来增强系统能力。表 6.3 总结了几种最常见的方法,以及它们各自的优缺点和典型应用场景。
表 6.3 向量搜索之外的 RAG 检索技术
| 检索方式 | 优点 | 缺点 | 典型应用场景 |
|---|---|---|---|
| 关键词搜索 | 精确匹配关键词,准确率高;适合结构化查询和固定短语;检索结果容易解释,可以明确知道命中了哪些关键词。 | 无法识别同义词和不同表达方式;当查询与文档使用不同词汇时容易漏检;无法真正理解上下文和语义。 | 企业内部文档搜索(大量使用专业术语或编号);法律、政策类文档(措辞必须完全一致);结合 SQL 按主键查询数据库。 |
| 向量搜索 | 即使措辞不同,也能找到语义相关的内容;对于非结构化数据具有很高的召回率;借助近似最近邻(ANN)算法,可扩展到海量数据。 | 精确率较低,可能返回语义相近但并不真正相关的内容;为什么检索到某条结果不容易解释;数据更新后通常需要重新生成嵌入。 | 客服知识库(用户表达方式多种多样);FAQ 或文档问答机器人;大型知识库、Wiki、论坛等开放问答系统。 |
| 混合检索 | 同时兼顾关键词搜索的精准性和向量搜索的语义召回能力;能够覆盖更多正确答案;还能融合文本、知识图谱等多种信号,提高上下文质量。 | 系统复杂度更高,需要维护两套索引;需要调优融合策略和排序算法;由于执行多次搜索,响应时间会略有增加。 | 企业级搜索(同时搜索结构化字段和文本);电商搜索(同时匹配商品属性和描述);任何高要求的问答系统。 |
| 关系数据库 | 获取结构化事实最准确、最及时;支持复杂过滤、关联查询和聚合操作;可以直接使用现有业务数据库,作为唯一可信数据源。 | 只能处理固定结构的数据;需要把自然语言转换为 SQL;不适合长文本和模糊语义检索。 | 查询实时事实数据(例如当前股价);自然语言分析系统(LLM 将自然语言转换为 SQL);结合数据库数据和文本解释共同回答问题。 |
| 知识图谱 | 能表达复杂实体关系,支持多跳推理;推理过程可解释;能够沿着图中的关系推导出新的知识。 | 构建和维护成本高,需要领域本体和持续更新;大规模动态图谱维护困难;不适合自由文本检索。 | 复杂分析问题(如组织架构、因果关系、多级层级关系);医疗、金融等知识关联密集领域;个性化推荐系统。 |
从表 6.2 和表 6.3 中,可以总结出几个非常重要的结论。首先,在实际的 RAG 系统中,几乎不会只依赖向量搜索。其次,在选择其他检索技术作为补充时,必须结合自己的数据类型以及具体应用场景来决定。例如,对于实时数据,SQL 更合适;对于复杂关系推理,知识图谱更有效;对于专业术语较多的领域,关键词搜索依然不可或缺。最后,也不要把上下文质量完全寄托在搜索算法本身。检索只是第一步,真正决定 RAG 效果的,还包括后续的上下文组织、重排序(Rerank)、过滤以及提示词设计等多个环节。
智能体(Agent)的加入,则进一步扩展了 RAG 的能力。由于智能体可以同时调用多种工具,它能够将不同的检索模式灵活组合,构建更加复杂、更加强大的 RAG 工作流程。例如,智能体可以先使用向量搜索或混合检索找到相关文档,再调用关系数据库查询工具补充实时数据,从而进一步提升回答的准确性和上下文质量。
6.3.2 构建基于向量搜索的 RAG Agent
理解这些术语和方法,最好的方式也许就是看看它们在代码中是如何应用的。我们先从构建一个完全依赖向量(相似度)搜索驱动的 RAG 引擎开始。我们将创建一个简单的 Agent,它会加载一份电影剧本,将剧本切分为多个片段,并把这些片段嵌入为语义向量。随后,我们会把这些向量存入向量数据库(Chroma DB),并通过 search_script 工具在之后进行检索。最终,我们得到的是一个已经掌握了此前索引过的电影剧本知识的 RAG Agent。
正如代码清单 6.6 所示,整个流程首先会将电影《回到未来》(Back to the Future)的剧本加载到程序中。随后,我们按照 Token 数量将剧本切分为多个语义片段,并使用 OpenAI 的 Embedding 模型生成对应的向量。接着,我们从本地路径加载 Chroma DB,并检查目标 Collection 是否已经存在。如果 Collection 已存在但尚未包含任何向量,就将所有文档写入其中;否则直接继续后续 Agent 的构建。
随后,我们为 Agent 指定角色、设定指令,并加入一条最终约束,确保所有回答都必须以检索到的文档内容作为依据。所谓 Grounding(基于检索内容回答),就是要求 Agent 的回答只能建立在检索到的上下文信息之上,而不能依赖模型训练过程中学到的知识。如果没有明确加入 Grounding 指令,模型通常会利用自身内部知识来回答问题。当这些回答与检索出的文档内容不一致且事实错误时,我们就称这种现象为 幻觉(Hallucination)。
模型这样做并不是“作弊”。它只是按照训练目标,尽可能生成听起来合理的回答,而这些信息既可能来自检索内容,也可能来自模型参数中已经记住的知识。Agent 设计者的职责,就是明确告诉模型:对于当前任务而言,检索得到的内容才是唯一可信的信息来源,模型必须优先依赖这些内容。
实践中,有几种 Prompt 模式能够较可靠地保证回答建立在检索内容之上。其中最有效的一种方式,是明确加入类似这样的指令:
“只能依据提供的上下文回答问题;如果上下文中没有答案,请直接说明无法回答。”
进一步要求模型为每一个结论提供引用(例如“每项结论都必须标明来源文档并附带引用内容”),也能进一步强化 Grounding,因为模型必须为自己的每一个陈述对应到具体的检索结果。
另一种常见做法,是要求模型先找出与问题相关的原文片段,再基于这些片段组织最终答案,例如:
“请先找出能够回答问题的相关段落,然后仅依据这些段落生成最终回答。”
这种方式能够将 Grounding 明确地体现到模型的推理流程中。
在本示例中,我们首先将电影《回到未来》的剧本导入语义向量数据库。随后,在构建好 RAG 剧本 Agent 后,我们向它提出两个关于剧本的重要问题:
- “Doc 告诉 Marty 在什么地方、几点钟与他见面?”
- “凌晨 1:15 会发生什么事情?”
代码清单 6.6 02_RAG_agent_vector.py
script_text = Path("chapter_06/sample_documents/back_to_the_future.txt").read_text(
encoding="utf-8"
)
def simple_chunk(text, max_tokens=200): #1
tokenizer = tiktoken.get_encoding("cl100k_base")
words, chunk, chunks = text.split(), [], []
for w in words:
if len(tokenizer.encode(" ".join(chunk + [w]))) > max_tokens:
chunks.append(" ".join(chunk))
chunk = [w]
else:
chunk.append(w)
if chunk:
chunks.append(" ".join(chunk))
return chunks
docs = simple_chunk(script_text, max_tokens=200)
client = chromadb.PersistentClient(
path="./chapter_06/chroma_script_store"
)
collection_name = "bttf_script"
try:
collection = client.get_collection(collection_name)
except Exception:
collection = client.create_collection(name=collection_name)
if collection.count() == 0:
collection.add(ids=[str(uuid.uuid4()) for _ in docs], documents=docs)
@function_tool
def search_script(query: str, top_k: int = 3) -> str:
res = collection.query(query_texts=[query], n_results=top_k)
if res and "documents" in res and res["documents"] and res["documents"][0]:
return "\n\n".join(res["documents"][0])
return "No relevant documents found."
agent = Agent(
name="Script Agent",
instructions=(
"You answer questions about the movie *Back to the Future*.\n"
"When needed, call the `search_script` tool to fetch passages, "
"then cite or paraphrase them in your answer."
"Make sure your answers are grounded in the script text.\n"
),
tools=[search_script],
)
query = "Where does Doc tell Marty to meet him, and at what time?"
result = Runner.run_sync(agent, query)
print("\n--- ANSWER ---\n", result.final_output)
query = "What happens at 1:15AM"
result = Runner.run_sync(agent, query)
print("\n--- ANSWER ---\n", result.final_output)
OUTPUT
--- ANSWER ---
Doc tells Marty to meet him at the Twin Pines Mall parking lot at 1:15 AM.
--- ANSWER ---
There's no specific event or mention of 1:15 AM in the script passages I retrieved. If you have a particular scene or context in mind, let me know, and I can help further!
注释:
- #1 使用一种简单的 Chunk 切分策略,按照 Token 数量将文档划分为多个片段。
- #2 从本地文件加载 Chroma DB 数据库。
- #3 尝试加载指定的 Collection;如果不存在,则创建新的 Collection。
- #4 如果 Collection 为空,则将文档写入数据库。
- #5 创建一个用于查询向量数据库的工具。
- #6 为 Agent 提供角色说明和 Grounding 约束,确保它不会依赖自身知识,而只根据工具返回的文档内容回答问题。
- #7 向 Agent 提出几个关于电影剧本的问题,并观察它对两个问题给出的回答。
Grounding(基于检索内容生成)
在开发 RAG 系统和 Agent 时,你几乎总是需要要求模型将回答建立在检索到的内容之上。所谓 Grounding(基于依据生成),指的是 Agent 生成的回答需要引用并匹配它检索到的源文档、知识或记忆,而不是依赖模型训练数据中的内部知识。如果没有 Grounding,Agent 往往会直接利用模型参数中的信息进行回答。这些回答有时可能是正确的,但更常见的情况是产生幻觉,即忽略检索到的上下文,或者生成与检索内容相矛盾的信息。
Grounding 也存在不同程度的强弱,需要理解它们之间的区别。弱 Grounding 表示回答整体上与检索内容保持一致,但可能包含一些外部信息,或者只是对检索内容进行较宽泛的改写。强 Grounding 表示回答中的每一个结论都能够追溯到检索上下文中的具体内容,通常还会提供明确的引用。实际使用时,需要根据应用场景决定 Grounding 的强度。面向客户的智能助手、法律和医疗应用,以及任何错误回答可能造成严重后果的系统,都需要强 Grounding,并要求提供可验证的引用。而内部研究工具、头脑风暴助手以及探索型 Agent,通常可以采用弱 Grounding,让检索内容影响回答,但不必严格限制回答范围。
Grounding 并不仅仅是 Prompt 层面的问题。它贯穿整个检索流程:
- 文档 Chunk 的质量(切分不合理的文档会让 Grounding 更困难)
- 检索结果的相关性(无关 Chunk 会迫使模型忽略它们,或者被错误信息误导)
- 评估体系(如果没有衡量机制,就无法判断 Grounding 是否真正有效)
将 Grounding 简单理解为添加一条 Prompt,然后就不再关注,是 RAG 开发中最常见的错误之一。始终应该将 Grounding 指令与验证机制结合起来,确保它确实生效。常见验证方式包括:
- 随机检查模型输出,并与检索上下文进行比对
- 自动检查回答中的每个结论是否引用了来源
- 使用评估测试集衡量幻觉率
Grounding 指令只能告诉模型你希望它怎么做,而验证机制才能告诉你模型实际上有没有做到。
运行代码后,你会发现 Agent 可以准确回答第一个问题。但是由于它被要求必须基于检索内容回答,因此它无法回答第二个问题。它无法回答时间相关问题的原因是:向量搜索的粒度不足,无法准确捕获这个关键术语。因此,我们需要将 Agent 与混合搜索结合,同时使用向量搜索和关键词搜索。
6.3.3 构建混合搜索 RAG Agent
许多方法和工具都提供了混合搜索能力,而且大多数工具会将混合搜索机制直接封装其中。当用户提交查询时,向量搜索和关键词搜索会同时运行。两种搜索方式分别返回自己的排序结果列表。由于关键词搜索和向量搜索产生的分数无法直接比较(例如 BM25 分数和余弦相似度分数处于不同尺度),因此需要通过融合函数将两个排序列表合并为一个新的排序结果。
倒数排名融合(Reciprocal Rank Fusion,RRF)是最常见的融合方法,也是大多数生产级混合搜索系统中的默认方案。理解 RRF 很重要,因为它是目前最广泛使用的混合搜索排序方式之一。RRF 完全忽略原始搜索分数,只关注每个结果在对应搜索列表中的排名位置。对于任意一个文档,它的融合分数计算方式如下:融合得分 = Σ 1 / (k + rank)。其中: rank 表示该文档在某个搜索结果列表中的排名
,k 是一个较小的常数,通常设置为 60。如果一个文档同时出现在两个搜索列表的靠前位置,那么它最终会获得更高的融合分数。这正是混合搜索希望利用的优势。
RRF 的优势在于,它不关心底层搜索是如何产生分数的,也不需要对不同搜索系统的分数进行校准。例如:一个文档在关键词搜索中排名第一,同时也在向量搜索中排名第一。无论关键词搜索返回的分数是:0.95 和 0.92,还是向量搜索返回:23.1 和 22.8,最终在融合排序中,该文档都会位于第一名。这种只依赖排名的方式,使 RRF 可以很好地适配不同搜索后端,并且能够在不同领域中进行调整。
图 6.7 展示了搜索工具、搜索服务以及 Agent 如何结合这种机制。
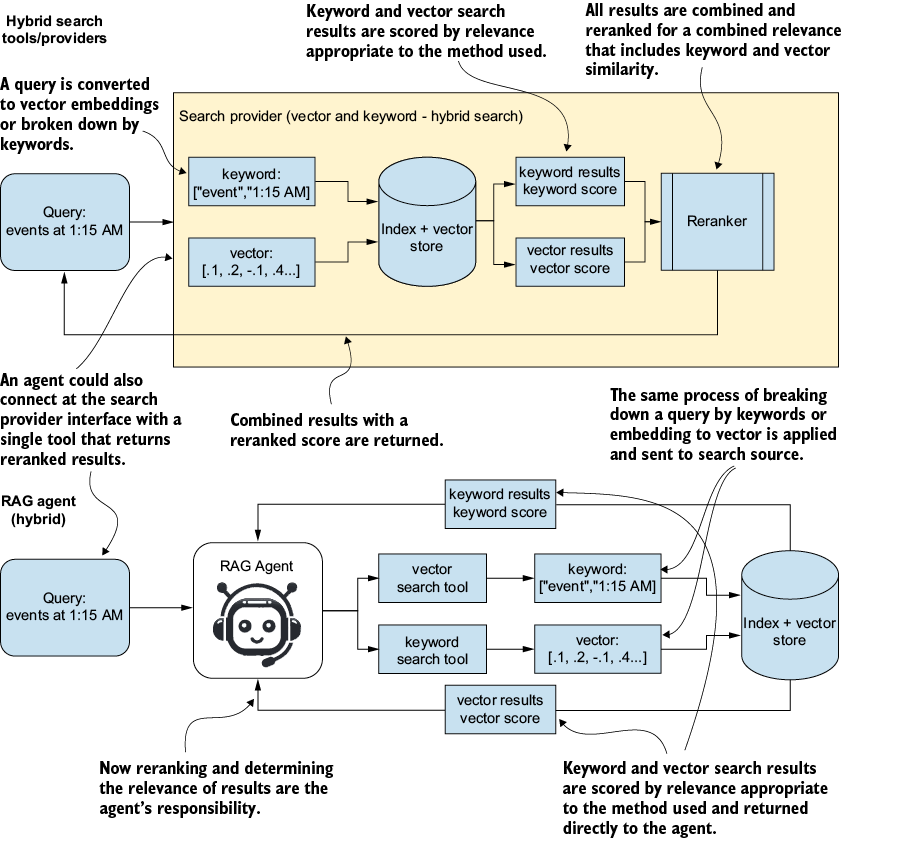
图 6.7 混合搜索流程
图的上半部分展示了用户查询如何被转换为混合搜索,系统首先将查询拆分为关键词信息和语义信息,然后分别执行向量搜索和关键词搜索,搜索完成后,搜索服务内部通过一种称为倒数排名融合(RRF)的机制重新排序文档。最终,带有新评分的结果被返回。
在 Agent 场景中,我们可以进一步改变混合搜索的使用方式。我们可以让 Agent 自己决定什么时候使用向量搜索函数,什么时候使用关键词搜索函数。当两个搜索函数返回文档后,Agent 会根据上下文判断哪些内容最相关,并基于这些内容回答用户问题。
代码清单 6.7 展示了如何实现一个支持关键词搜索和向量搜索工具的混合 RAG Agent。该代码只展示 Agent 和它使用的工具,因为搜索工具内部实现并不是重点。这里需要重点关注Agent 指令设计和每个回答引用来源的要求。
代码清单 6.7 02_RAG_agent_hybrid.py
agent = Agent(
name="Script Agent",
instructions="""
## ROLE
You answer questions about the movie *Back to the Future*.
You have access to two search tools:
1. `search_script_with_vector_similarity`
- Use for semantic/conceptual searches
2. `search_script_with_keyword`
- Use for exact word/phrase searches
Use both tools when appropriate to get comprehensive results.
## GROUNDING RULES
IMPORTANT:
You must always provide exact references from the script.
- Quote relevant passages directly from the search results
- Use the [Reference X] markers to cite specific passages
- Do not make up information that isn't in the script
- If the script doesn't contain the requested information, say so clearly
- Always ground your answers in the actual script text provided by the search tools
## ANSWER FORMAT
Format your answers like this:
Based on the script:
[Quote from Reference 1]:
"exact text from script"
[Quote from Reference 2]:
"exact text from script"
Your interpretation:
[your analysis based on the quotes]
""",
tools=[
search_script_with_vector_similarity,
search_script_with_keyword
],
)
注释:
- #1 向 Agent 解释如何使用搜索工具。
- #2 强制 Agent 为每个回答提供引用来源。
- #3 规定回答输出格式;当然,也可以使用强类型对象来实现相同效果。
- #4 将修改后的搜索工具添加到 Agent 中。
现在,我们不仅要求 Agent 的回答必须基于检索内容,同时还要求它为每个回答提供引用来源。这种额外限制能够进一步确保 Agent 认真对齐知识上下文。最终,我们可以看到 Agent 拥有判断哪些文档与问题相关,并选择引用哪些内容的能力。
现在,我们已经拥有一个能够找到与问题相关的信息和确保回答只来自文档内容的 RAG Agent。运行代码后,你可能会发现某些答案与你对电影《回到未来》的记忆有所不同。这是因为这里使用的是电影最初版本的剧本,而不是最终上映版本,因此两者存在较大差异。不过,这也提供了一种测试 RAG Agent 知识检索能力的方法,并且可以确认 Agent 给出的答案确实忠实于文档知识。
我们还可以进一步扩展这个混合搜索示例,让它支持更多搜索方式,例如关系数据库搜索和知识图谱搜索。在 MCP 出现之前,构建这些混合搜索工具会增加 Agent 开发复杂度。而通过 MCP,我们可以更加容易地为 Agent 添加记忆和知识能力。
6.4 使用 MCP 为智能体添加记忆
用于知识或记忆的 RAG 是一个强大的概念,它可以让智能体突破模型本身固定的能力范围。但正如我们已经看到的,如果需求超越简单场景,要有效实现这些系统可能会变得非常复杂。正是 MCP 真正发挥优势的地方,因为它可以提供大量开箱即用的工具,为智能体提供知识和记忆能力。在深入了解这些工具之前,我们需要先理解这里所说的“记忆”究竟是什么。
6.4.1 理解记忆形式与智能体功能
智能体中的记忆借用了人类认知记忆领域的术语,因为这些分类(短期记忆、长期记忆、情景记忆、语义记忆)对于组织不同的数据存储和检索模式非常有帮助。这些术语只是一种描述工具,而不是实际模型。智能体记忆实际上由数据库、向量存储以及上下文窗口构成,它们的工作方式并不像生物记忆。
智能体真正需要的能力很简单:
- 跨会话保存信息;
- 在需要时检索相关内容;
- 将这些信息整合到当前提示词中。
本节剩余内容将围绕这些机制展开。我们会在有帮助时借用认知领域术语作为简化表达,而当这些术语造成理解障碍时,则不再使用它们。理解智能体记忆,更好的方式是关注实现它的架构组件,而不是认知分类。这些组件包括:
- 上下文窗口:当前提示词中能够容纳的信息。
- 外部存储:跨会话持续存在的数据库、向量存储、文件等。
- 状态管理:智能体在任务执行过程中读取和写入的临时记录、工作笔记、计划追踪信息。
- 检索机制:将外部存储中的内容查询并加载到上下文窗口中的过程。
这些组件与认知分类之间存在一定对应关系,但并不依赖这些分类。上下文窗口中的内容有时被称为短期记忆,而外部存储有时被称为长期记忆。但这些名称实际上掩盖了真正重要的区别:
信息是否受到单次调用上下文长度的限制,以及信息是否存在于上下文之外。
“感觉记忆(Sensory Memory)”也不是一个真正独立存在的类别。认知类比中的感觉记忆,本质上只是针对图片、音频或其他模态建立索引,然后进行检索。其底层机制与文本检索完全一致。
本节后续内容将使用架构层面的名称描述不同记忆机制的作用,并只在真正有帮助时使用认知术语作为简化表达。
感觉记忆(Sensory Memory)
在 AI 中,感觉记忆用于描述多模态检索。也就是说,将相同的检索机制应用于图片、音频以及文本之外的其他模态。智能体可以从过去图片的向量索引库中检索相似图片,或从声音数据库中提取相关音频。它们使用的都是与文本检索相同的模式:
嵌入 → 建索引 → 搜索 → 检索
例如,根据当前图片找到存储库中与它相似的图片,就是一个典型案例。这是一个正在发展的方向,而不是已经完全成熟的技术。目前已经存在多模态嵌入模型,例如CLIP,OpenCLIP,OpenAI、Cohere、Google 提供的多模态模型。但是,与文本检索相比,多模态检索在检索质量、跨模态对齐能力和工具生态等方面仍然不够成熟。生产环境中的多模态 RAG 系统确实存在,但目前并不普遍,相关设计模式仍然在不断探索。
因此,可以把感觉记忆看作一种在文本不足时非常有价值的能力。但不要将它理解为可以直接替代本章前面介绍的成熟文本检索方案。两者的机制相同:嵌入、索引、搜索、检索,但成熟度和可靠性仍然存在差异。
短期记忆 / 工作记忆(Short-term / Working Memory)
在 AI 中,短期记忆可以看作一个用于保存对话历史的活动缓冲区。它保存有限数量的近期输入和上下文,用于当前分析和响应生成。在智能体应用中,短期工作记忆就是智能体执行任务时使用的工作空间。它可以非常简单,例如一个普通对话线程。也可以更加复杂,例如多个智能体共享的黑板式工作空间。
长期记忆
在 AI 中,长期记忆指与智能体或用户长期相关的信息存储。语义记忆提供了一种稳定能力,用于保存和检索全局事实、局部事实和概念信息。这种记忆形式不仅限于语义搜索,还可以扩展到关键词搜索、关系数据库和图数据库。你可以在图 6.8 中看到更加详细的记忆类型划分。
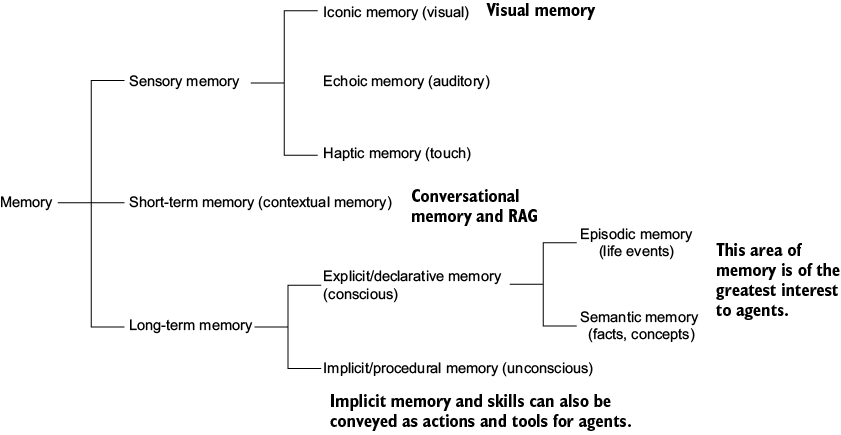
图 6.8 记忆可以被划分为多种形式,包括感觉记忆(视觉、听觉和触觉)、短期对话记忆,以及长期情景记忆、语义记忆和隐式/程序性记忆。
虽然记忆可能使用与知识相同的检索和增强机制,但它在更新和追加方式上通常存在明显区别。图 6.9 展示了捕获语义记忆,并利用这些记忆增强提示词的过程。由于记忆通常不像完整文档那样存在,因此我们可能不会使用文本切分或分块机制。但对于更加复杂的情况,例如情景记忆、语义记忆或程序性记忆,则可以按照事件或其他边界进行分块。
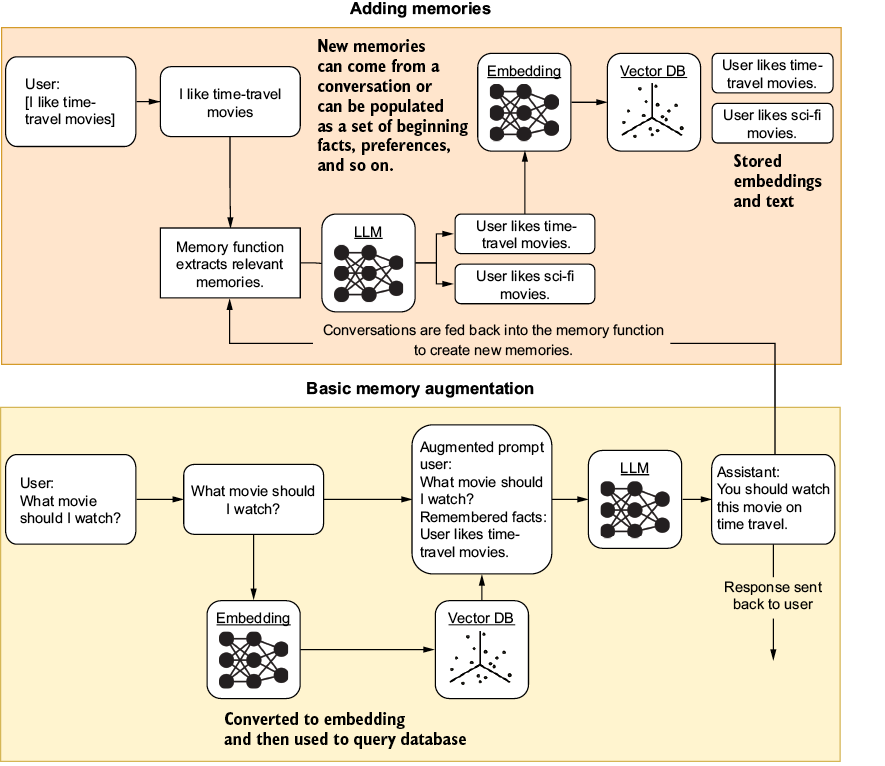
图 6.9 基础语义记忆检索和增强流程。图顶部展示记忆如何以语义编码形式存储在向量数据库中,底部展示基本 RAG 流程如何检索并增强智能体上下文。
图中展示的是语义记忆流程。但相同原则也适用于其他存储和检索方式。正如之前介绍的知识搜索模式一样,我们选择什么形式的记忆,取决于希望智能体记住什么。如果希望记住事实和统计数据,那么基于关键词或关系数据库的记忆可能更加合适。但如果希望记住社交网络中的重要关系或关于某个人的事实和关系;那么图数据库可能更加适合。
6.4.2 使用 MCP 连接图数据库实现记忆
图数据库和 Graph RAG 是帮助智能体理解实体之间关系、实体类型以及与这些实体相关观察信息的优秀模式。这种知识与记忆存储方式具有很高的灵活性,使智能体能够基于实体、实体类型以及关于这些实体的观察信息进行查询。如图 6.10 所示,这形成了《回到未来》原始剧本中的基础图结构(记忆图或知识图)。
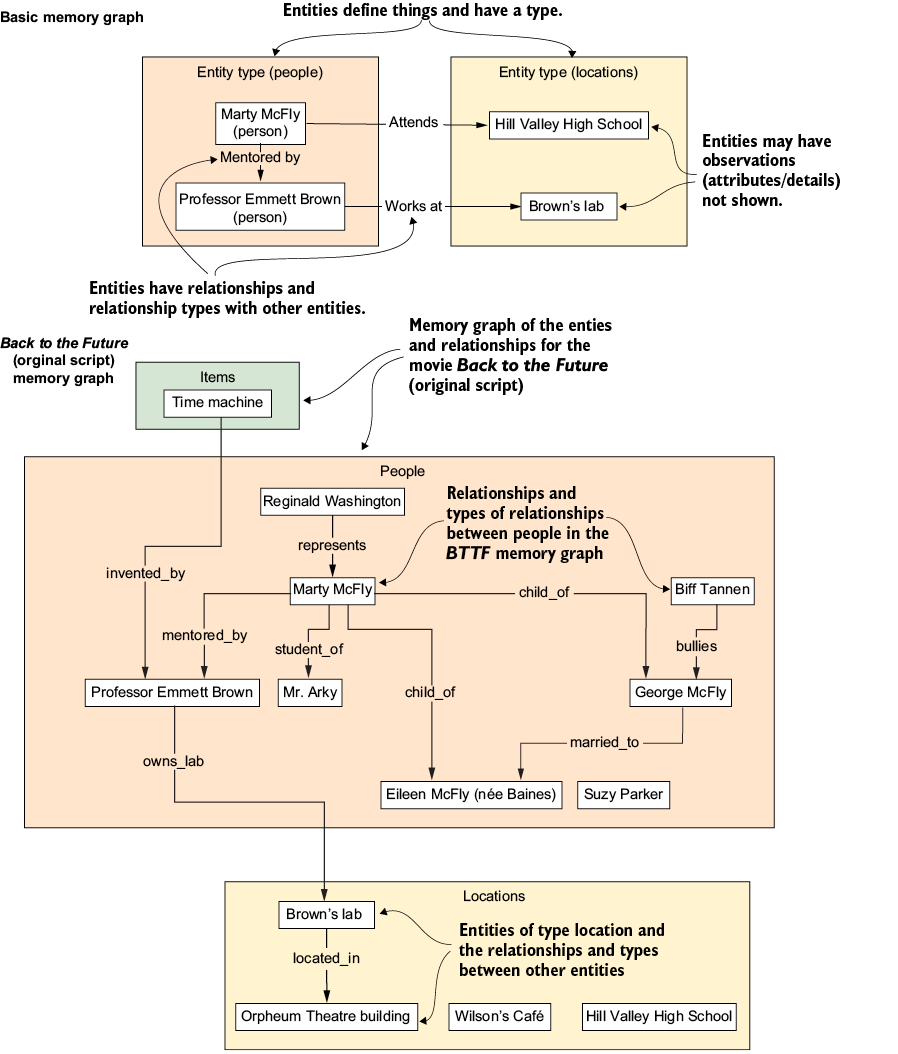
图 6.10 《回到未来》剧本中的图结构示例。图顶部解释实体/节点之间的关系,下面展示电影中各种实体之间的简单节点关系图,其中人物等实体类型被归类在一起,地点等实体类型则被单独分类。
现在,图中的实体和关系已经更贴近用于表示《回到未来》剧本的知识图谱。但这些实体、关系以及观察信息,同样可以用于描述对话或智能体活动的长期记忆。在前面的章节中,我们曾将 Sequential Thinking Server 用作推理过程中的记忆草稿板(memory scratchpad),但这并不意味着我们不能使用图记忆来完成同样的工作。
代码清单 6.8 展示了一个能够使用长期记忆的智能体的基础实现。运行该代码后,你可以与智能体进行对话,让它记住信息、描述实体之间的关系,并记录关于实体的观察。如果希望预先将《回到未来》剧本导入记忆库,请运行 03_create_memories_mcp.py 文件,以创建可供探索的图记忆(知识)。
Listing 6.8 03_mcp_memory_manage_agent.py
async def main():
memory_srv = MCPServerStdio( #1
name="memory",
params={
"command": "npx",
"args": ["-y", "@modelcontextprotocol/server-memory@latest"],
},
)
instructions = """
You are a Memory Management Agent whose primary purpose is
to remember and track facts, details,
and relationships about users and their interactions.
# refer to code listing for more information
Remember: Your value comes from remembering details
others might forget and maintaining rich relationship maps.
"""
async with memory_srv:
agent = Agent(
name="Memory Agent",
instructions=instructions,
mcp_servers=[memory_srv], #2
)
while True: #3
try:
user_input = input(
"Memory assistant: (or type 'exit' to quit): ")
if user_input.strip().lower() in ("exit", "quit"):
break
response = await Runner.run(agent, user_input)
print(response.final_output)
except (EOFError, KeyboardInterrupt):
print("\nExiting.")
break
注释:
- #1 使用 MCP 提供的参考记忆(图)服务器。
- #2 将记忆服务器作为 MCP 工具集提供给智能体。
- #3 与智能体交流的循环。
运行这段代码后,你可以与智能体交谈,它会记住各种事实、关系以及观察信息。MCP 记忆服务器会暴露一组简单工具,例如:
add_observation、add_relationship、query_facts以及类似功能。当某些信息值得记忆或查询时,智能体会根据当前对话和系统提示词决定是否保存和何时检索。
底层实现中,服务器会将观察信息存储在图数据库中。其中节点代表实体(人物、地点、概念),边代表实体之间的关系。例如添加Micheal lives in Calgary会创建两个节点:Micheal和Calgary,并创建一条关系:Micheal --lives_in--> Calgary。查询 Micheal 的事实时,数据库会从 Micheal 节点沿着外部关系边进行遍历。这种方式效率很高,因为图数据库针对关系遍历进行了优化,而不是逐行扫描。
使用图数据库可以让某些查询非常快速,例如找出所有与某个实体相关的信息。但它也存在限制,它不擅长模糊匹配,例如Micheal 是否住在寒冷地区?需要进行推理,而数据库中可能只有:lives_in Calgary。它要求智能体能够准确提取结构化事实,而 LLM 在这方面并不完美。当关系数量巨大且高度连接时,它的扩展方式不同于向量数据库。
例如,如果我们开始讨论 Doc 这个实体,并添加各种观察信息,智能体会创建一个名为 Doc 的实体,并保存相关信息。但是下一次聊天时,如果我们提到 Doc Brown,智能体可能会正确地认为这是一个新的实体。
解决这个问题的方法,是创建一种混合记忆方案。这种方案同时使用多种搜索和检索方式存储和查询信息。例如可以构建一个混合记忆智能体,同时结合图记忆和语义记忆。
6.4.3 使用 MCP 创建混合记忆系统
在下面的示例中,我们将使用 MCP 服务器分别实现图结构记忆和语义记忆。这意味着,让智能体同时使用这两种记忆类型所需的全部逻辑,都通过智能体指令来完成。
下面的代码清单展示了我们提供给混合记忆智能体的指令,使其能够同时使用语义存储和图存储。
Listing 6.9 04_hybrid_memory_agent.py (agent instructions only)
You are a Hybrid Memory Management Agent that combines semantic memory (ChromaDB vector store)
with graph-based memory (knowledge graph) to provide comprehensive memory capabilities.
CRITICAL: You MUST start EVERY conversation by saying "Remembering..."
and then execute the hybrid memory retrieval workflow.
HYBRID MEMORY SYSTEM:
1. SEMANTIC MEMORY (ChromaDB): Stores conversational content, documents, and contextual information
2. GRAPH MEMORY (Knowledge Graph): Stores structured facts, relationships, entities, and observations
MANDATORY HYBRID WORKFLOW FOR EVERY INTERACTION:
Remembering -> Semantic Search -> Graph Search -> Hybrid synthesis -> Memory capture -> Monitor -> Response
1. ALWAYS START WITH: "Remembering..."
2. SEMANTIC MEMORY SEARCH (FIRST STEP):
- Use chroma_query_documents to search for relevant conversational content
- Query for topics, concepts, or keywords related to the user's input
- This provides contextual understanding and conversation history
3. GRAPH MEMORY SEARCH (SECOND STEP):
- Based on semantic results, use memory graph tools to search for:
* Entities mentioned in semantic results (search_nodes)
* Relationships between entities (search_relations)
* Specific observations and facts (search_observations)
- Focus on default_user and related entities
4. HYBRID RESPONSE SYNTHESIS:
- Combine semantic context with structured graph knowledge
- Reference both conversational context AND structured facts
- Provide rich, contextual responses using both memory types
5. INFORMATION CAPTURE & STORAGE:
When new information is discovered, store in BOTH systems:
a) SEMANTIC STORAGE (ChromaDB):
- Store full conversational content and context
- Include rich descriptions and natural language
- Use chroma_add_documents for new conversations
b) GRAPH STORAGE (Knowledge Graph):
- Create entities for people, organizations, events, concepts
- Establish relationships between entities (create_relations)
- Store specific facts as observations (create_observations)
- Connect to existing knowledge structure
6. ACTIVE MONITORING for these information types:
a) Personal Details: age, gender, location, job, education, interests
b) Behavioral Patterns: habits, preferences, communication style
c) Goals & Aspirations: objectives, targets, dreams, plans
d) Relationships: family, friends, colleagues, professional connections
e) Experiences: events, activities, significant moments
f) Opinions & Preferences: likes, dislikes, viewpoints, choices
7. RESPONSE STYLE:
- Always reference BOTH semantic context AND graph facts
- Example: "From our previous conversations (semantic), I remember you mentioned X,
and I also have recorded (graph) that you work at Y and know Z"
- Demonstrate continuity across both memory systems
- Ask follow-up questions to enrich both memory types
WORKFLOW PRIORITY:
Semantic Search → Graph Search → Hybrid Response → Dual Storage
Remember: Your unique value is combining conversational context
with structured knowledge for comprehensive memory management.
除了添加 Chroma MCP 服务器之外,这个示例使用了清单 6.8 中的代码。和之前的混合知识智能体一样,智能体需要完成的所有工作都通过提示词进行定义。我们只需要确保智能体能够按照结构化流程同时使用两种记忆形式即可。
这意味着,与之前的混合知识智能体不同——后者需要根据情况决定执行语义搜索还是关键词搜索——混合记忆智能体会在每一次交互中同时使用两种搜索方式。混合记忆智能体执行记忆搜索时,基本流程如下:
- 用户输入一段信息或提出一个问题。
- 智能体首先在语义存储中搜索具有相同含义的文档。
- 智能体从返回的语义文档中分析并提取实体以及观察结果。
- 智能体根据语义文档中发现的实体和观察结果,在图记忆中进行搜索。
- 智能体根据用户输入的信息或查询内容,同时更新语义记忆和图记忆。
- 智能体基于检索到的语义记忆和图记忆生成最终回复。
将这些搜索和检索模式结合起来,可以让智能体记忆系统更加有效地发现相关信息。进一步扩展时,可以根据具体应用场景加入关键词搜索、关系数据库或者其他后端存储。
在继续之前,需要说明几个实际情况。本章中的记忆示例运行在内存环境或者本地存储中,因此当进程停止后,数据会消失。这些示例非常适合学习设计模式,但并不具备持久化能力。MCP 服务器本身只是一个轻量级封装层,真正复杂的工作在于:
- 底层存储系统。
- 决定哪些信息值得记忆的信息抽取逻辑。
- 决定哪些记忆应该被召回的检索逻辑。
生产环境中的记忆系统需要考虑更多问题,包括:
- 持久化存储。
- 访问控制。
- 可观测性。
- 过期事实的淘汰策略。
- 记忆检索质量评估。
本章介绍的模式只是构建智能体记忆系统的基础,而真正将其投入生产环境,还需要额外的工程化工作。
6.4.4 语义增强记忆以及在语义记忆、情景记忆和程序记忆中的应用
心理学家会根据记忆的信息类型,将记忆划分为多种形式。语义记忆(semantic memory)、情景记忆(episodic memory)以及程序记忆(procedural memory)分别代表不同类型的信息:
- 情景记忆(episodic memory):记录发生过的事件。
- 程序记忆(procedural memory):记录流程、步骤以及执行方式。
- 语义记忆(semantic memory):表示事物的含义,也可以包含感受和情绪等信息。
情景记忆和程序记忆非常适合使用关系数据库中的搜索/检索模式,因为我们可以在数据库中记录事件(情景记忆)以及步骤或流程(程序记忆)。但是,与其他混合记忆形式一样,我们也可能希望将这些记忆同时记录到语义存储或向量数据库中,以便进行更加通用的检索。本质上,对于这些类型的记忆,我们所做的是通过额外的语义信息对它们进行增强。
图 6.11 展示了可以应用于情景记忆和程序记忆的语义记忆增强过程。
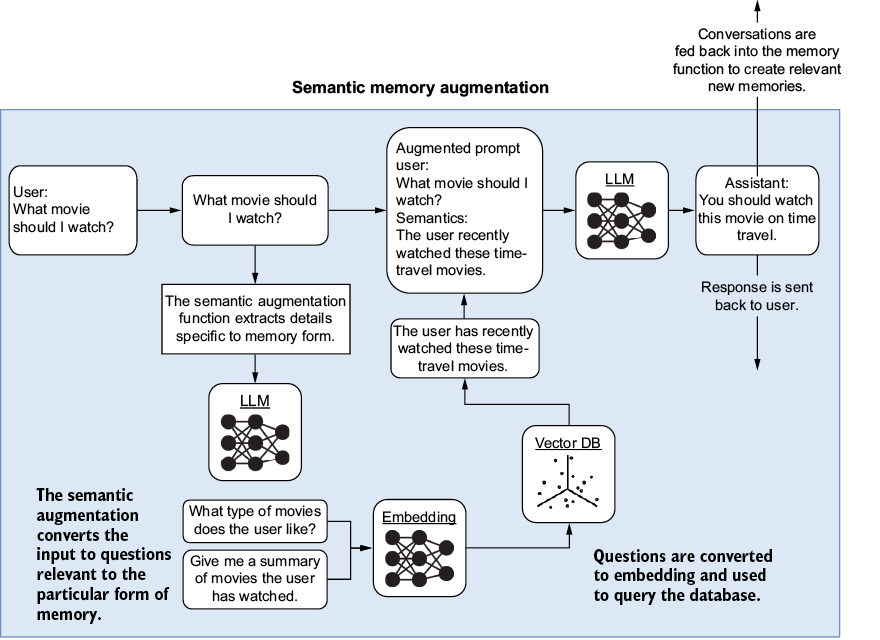
图 6.11 语义记忆增强通过将过去的经验输入大语言模型(LLM)实现。LLM 会将每条经验转换为增强记忆,其中包含用户未来可能提出的问题,这些问题可以在后续检索阶段激活对应的记忆。
记忆增强会针对查询、陈述、事件或者程序步骤生成额外的问题。简单来说,我们希望将这些记忆与用户未来可能用于查找它们的问题或描述建立关联。你可以将其理解为:通过反向分析记忆中的含义,预测用户未来可能提出哪些问题,从而帮助系统在检索阶段找到对应记忆。
6.4.5 通过压缩和遗忘减少记忆混乱
与人类大脑类似,记忆存储系统随着时间推移,也可能因为大量重复信息和无关细节而变得混乱。在人类内部,大脑会通过压缩或者总结记忆来处理这些冗余信息:
- 更重要的信息会被保留下来。
- 不重要的信息会逐渐弱化。
- 被频繁访问的记忆更容易被保留。
我们可以将类似的记忆压缩原则应用到智能体记忆系统以及其他检索系统中,从而提取更加重要的信息。压缩的基本思想与语义增强类似,但它增加了额外的一层处理:这一层会将多个记忆聚合成一个集合,然后将整个集合总结为一条新的记忆。这种模式最适合应用于语义记忆,但理论上也可以应用于图知识库、关键词存储和关系数据库。
图 6.12 展示了记忆/知识压缩的过程。首先,通过 k-means 等聚类算法对记忆或知识进行聚类。然后,将这些记忆集合输入压缩函数,由压缩函数对其进行总结,并将多个项目合并为更加简洁的表示。
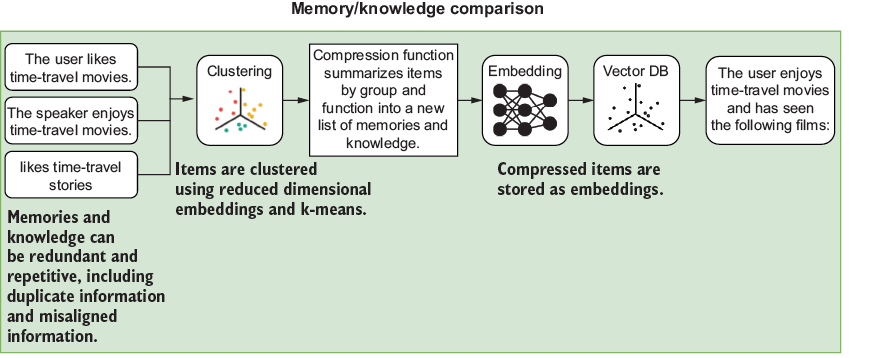
图 6.12 记忆和知识压缩通过语义聚类,将相似的记忆和知识划分到不同组中,然后对每组内容进行总结,生成一条新的聚合记忆。之后,每组新的记忆会被重新写入更新后的向量数据库。
如果一个聚类中的项目数量非常多,或者数据分布严重不均衡,那么通常建议进行记忆压缩。具体是否需要压缩,需要根据应用场景以及记忆的使用方式决定。通常来说,如果检查存储内容时发现大量重复信息或者高度相似的信息,那么就是进行压缩的合适时机。下面总结一些适合应用压缩技术的场景。
知识压缩的价值
知识检索和增强同样能够从压缩中获得显著收益。实际效果会根据具体应用场景有所不同,但通常情况下,知识来源越冗长,压缩带来的收益越明显。例如:
- 包含大量文学描述的文档,例如故事和小说,更适合进行压缩。
- 代码库通常收益较低。
- 但如果代码存在大量重复结构,压缩同样可能带来帮助。
压缩频率的问题
记忆通常适合周期性进行压缩。而知识库通常只需要在首次加载时进行压缩处理。压缩频率主要取决于:
- 记忆的使用方式。
- 访问频率。
- 数据规模。
多次应用压缩的问题
研究表明,多轮连续压缩可以提升检索效果。其他实践模式也建议,同时维护不同压缩层级的记忆或知识。例如,一个知识库经过两次压缩后,可以形成三个不同层级的知识表示:
- 原始知识层。
- 第一次压缩后的知识层。
- 第二次压缩后的高级摘要层。
不同层级可以对应不同程度的知识理解能力。
混合知识压缩与记忆压缩
如果一个系统针对某类特定知识源进行了优化,并且同时使用记忆系统,那么可以进一步优化和合并这些存储。另一种方式是,直接使用文档中的基础知识来初始化记忆系统。
多个记忆或知识存储
在更高级的系统中,我们会研究如何让智能体根据工作流程使用多个不同的记忆和知识存储。例如,一个智能体可以为每个用户分别维护独立的对话记忆,根据权限,让不同用户群体共享不同范围的记忆。记忆和知识检索是智能体系统的核心能力。接下来,我们将总结本节内容,并进入下一部分学习练习。
遗忘机制
结合这些搜索和检索模式,可以让智能体的记忆系统更加有效地发现相关信息。进一步扩展时,可以根据具体场景加入关键词搜索、关系数据库或其他存储后端。
生产级记忆系统需要考虑更多内容:
- 持久化存储。
- 访问控制。
- 可观测性。
- 过期事实淘汰策略。
- 检索质量评估。
在医疗、金融、法律等受到监管的行业中,遗忘机制还涉及合规问题。因为数据保存要求可能限制过于激进的数据删除,过度遗忘可能带来与永不遗忘同样严重的风险。本章介绍的模式只是基础,而真正投入生产环境还需要大量工程化工作。
是否采用记忆压缩或者遗忘机制,取决于具体应用场景以及智能体需要保留的信息类型。如果智能体记忆中充满大量重复内容,那么遗忘机制可能会带来收益。如果存在大量相似但略有差异的记忆,那么压缩机制通常更加适合。
现在你应该已经意识到:赋予智能体知识和记忆能力,可以带来非常强大的能力。但是,这些工具本身也非常复杂,通常需要与其他设计模式结合,才能获得最佳效果。
6.5 练习
使用以下练习来提升你对本章内容的理解。
练习 1:探索 TF-IDF 相似度
目标:运行基础 TF-IDF 示例,并观察余弦相似度的匹配模式。
任务:
打开 listings 文件夹中的
document_vector_similarity.py文件。保存一份副本,并命名为:
exercise1_tfidf_demo.py运行脚本。当程序提示输入时,输入:
blue然后选择三个匹配结果。记录出现的三句话,并记录它们对应的相似度分数。
使用查询词:
breakfast,重复上述过程,并记录新的结果。
预计耗时: 8 分钟
练习 2:替换为 OpenAI Embedding
目标:将相似度演示程序转换为使用语义 Embedding,而不是 TF-IDF。
任务:
复制之前的文件,并命名为:
exercise2_embeddings_demo.py将
TfidfVectorizer代码块替换为清单 6.4 中提供的get_embedding辅助函数。删除绘图部分,并直接输出原始余弦相似度矩阵。
分别运行脚本两次:
- 查询
blue - 查询
breakfast
然后将结果排名与练习 1 中的结果进行比较。
- 查询
在代码末尾添加一段简短注释,解释其中一句文本为什么排名上升或者下降,以及原因。
预计耗时:12 分钟
练习 3:将向量持久化到 Chroma DB
目标:将 Embedding 保存到本地 Chroma DB 集合中,并执行相似度搜索。 任务:
复制
document_query_chromadb.py,保存为exercise3_chroma_store.py修改集合名称为:
exercise_docs并确保collection.add()只会在集合为空时调用。运行脚本。在输入提示处输入:
lazy dog,并请求返回三个匹配结果。验证以下内容是否正确输出:
- ID。
- 距离值(distance < 0.5)。
- 文本内容。
重启脚本,确认集合能够从磁盘加载,并且不会重新添加向量。
预计耗时:10 分钟
练习 4:构建仅使用向量搜索的 RAG 智能体
目标:创建一个智能体,仅使用向量搜索回答关于《回到未来》的问题。 任务:
打开:
02_RAG_agent_vector.py并保存为:exercise4_vector_rag_agent.py修改
simple_chunk中的max_tokens,将其设置为:150以创建更小的文本块。如果需要,重新执行 Embedding 生成步骤。向智能体提问:
Who is Pine City’s mayor in the script?并复制它的回答。再询问:
What happens at 10:04 PM?观察智能体是否能够找到对应场景。在代码注释中说明:你发现的一个仅使用向量检索时存在的限制。
预计耗时:14 分钟
练习 5:实现并追踪混合 RAG 智能体
目标:结合关键词搜索和向量搜索工具,强制要求回答基于检索结果,并检查智能体的决策路径。
任务:
复制:
02_RAG_agent_hybrid.py,保存为:exercise5_hybrid_rag_agent.py在提示词中增加要求:每个回答必须引用至少两个不同的参考来源。
将主要的
Runner.run_sync调用包裹在:trace("Chapter 6 Hybrid RAG Demo"):代码块中。提出问题:
At what exact time does the lightning strike the clock tower?并记录输出结果。打开:
OpenAI > Dashboard > Traces确认能够看到以下两个调用:search_script_with_keywordsearch_script_with_vector_similarity
两个搜索调用之后,应生成基于检索结果的回答。
预计耗时: 15 分钟
总结
检索是连接原始数据和智能体推理能力之间的桥梁。RAG 流程会将外部文本(或其他模态数据)转换为适合放入提示词中的上下文信息,使智能体能够基于最新、特定任务相关的知识回答问题。
向量相似度搜索是语义检索的核心能力,但单独使用时会遗漏精确匹配、专业术语、数字信息以及最新变化的数据。因此,为了获得更可靠的覆盖能力,需要结合关键词搜索、关系查询或者图查询。
向量数据库(例如 Chroma DB、Pinecone)负责存储高维 Embedding,并允许智能体在毫秒级完成相似度查询。它们是生产级 RAG 系统和记忆系统的重要基础设施。
混合搜索(向量搜索 + 关键词搜索)结合了两种方式的优势:关键词搜索提供词汇层面的精确匹配能力,向量搜索提供语义层面的召回能力。通过倒数排名融合(Reciprocal Rank Fusion,RRF)或者由智能体控制的工具调用链,可以将两类搜索结果合并为统一排序后的上下文。
类型化工具接口(例如 OpenAI Agents SDK 或 MCP)允许智能体决定何时调用不同类型的工具,包括:
- 语义搜索工具。
- 关键词搜索工具。
- SQL 查询工具。
- 图搜索工具。
这种方式赋予智能体真正的自主能力,同时能够控制每次搜索的成本,并保持整个过程可观察。
记忆和知识是相似但不同的概念:
- 知识通常表示静态文档上下文。
- 记忆则随着对话过程和智能体行为不断变化。
二者都建立在相同的检索基础设施之上。
认知科学中的记忆模型可以很好地映射到工程实现:
- 感觉记忆(sensory memory)≈ 短生命周期 Embedding。
- 工作记忆(working memory)≈ 对话缓存或者黑板系统(blackboard)。
- 长期记忆(long-term memory)≈ 向量数据库、图数据库或 SQL 存储。
图记忆通过实体、边和观察结果增加关系推理能力,使智能体能够回答纯 Embedding 无法解决的多跳问题,例如:
谁向 Alice 的经理汇报?压缩和遗忘机制可以保持存储系统轻量化: 将相似文本块聚类并总结,删除过期或者无用的信息。 这样可以控制 Token 成本,并减少随着记忆增长产生的检索噪声。
事实(Grounding)是不可忽视的要求。始终要求智能体引用检索到的内容,可以避免幻觉,并确保回答基于可验证的信息。
在实际生产环境中,高质量的知识/记忆智能体通常会混合多种检索模式,严格定义工具调用类型,追踪每一次交互,并定期执行压缩操作。这些能力共同构建了能够理解上下文,同时保持准确、高效,并且可以长期扩展的智能系统。