本章内容
- 理解 LLM 如何进行推理与规划
- 如何指导 Agent 进行推理与规划
- 使用 Agent 实现高级规划
- 使用 Sequential Thinking MCP Server
对于大语言模型而言,推理包含两个不同但密切相关的认知过程:任务分解和规划。任务分解是指将一个复杂问题拆解成若干较小的子问题,即回答"这个任务由哪些部分组成?";而规划则是在这些子问题之间确定执行顺序、依赖关系以及解决方案,即回答"这些任务应该按照什么顺序完成?需要使用哪些工具?各部分之间如何衔接?"
这两个能力缺一不可,而且它们可能分别失败。Agent 可能能够正确完成任务拆解,却制定了糟糕的执行计划;也可能规划过程没有问题,但建立在错误的任务拆解之上。虽然最终都会导致任务失败,但两种失败的原因完全不同,因此解决方法也不同。明确区分这两个过程十分重要,因为只有知道是哪一步出了问题,才能采取正确的改进策略。
如果缺少任务分解和规划能力,Agent 就很难真正发挥自主性,无法有效地进行决策、执行操作并完成目标。正如本章将要介绍的,推理和规划能力的质量,很大程度上取决于驱动 Agent 的 LLM,以及围绕模型设计的推理结构。
5.1 理解 LLM 的推理与规划
通过一个简单的例子,可以更容易理解任务分解与规划的区别。假设目标是"出门"。一个简单的执行计划可能包括:穿衣服、检查烤面包机、拿钥匙,然后离开家。
然而,人类在处理这种日常事务时并不会真正经历这样的思考过程。我们依赖长期形成的行为习惯,以及通过现实世界长期积累起来的认知模型,能够自动完成这些步骤。而 LLM 并不具备这种基于现实经验形成的世界模型,因此它们必须依靠显式的任务分解和规划结构,才能完成那些人类几乎无需思考即可完成的工作。
传统的非推理模型在生成回答时,通常采用一次前向传播的方式完成整个输出,中间没有显式的思考过程。如果没有链式思维(CoT)等推理框架,这类模型在面对多步骤问题时,往往会直接生成一个看似合理但实际上较为肤浅的答案。这里需要强调的是,这种限制体现在多步推理质量上,而不是模型能够处理多少任务。模型仍然会尝试回答复杂问题,只是推理过程通常不够深入。
推理模型则不同,它们会将思考过程显式化。在输出最终答案之前,模型会先进入一个"思考阶段",为推理分配更多计算资源,从而能够解决更加复杂的问题。当然,这种能力也意味着需要消耗更多 Token,并带来更高的响应延迟。因此,两类模型真正的区别并不是"是否会推理",而是推理是隐式完成的、受限于一次生成过程,还是拥有一个能够充分展开的显式思考阶段。
链式思维(CoT)提示词则位于两者之间。它通过提示模型输出中间推理步骤,帮助普通 LLM 更好地完成多步任务。但 CoT 并不会赋予模型新的能力,它只是鼓励模型不要过早结束推理,而是展示中间步骤,并利用这些步骤逐步推导最终答案。因此,CoT 对于能力较强的模型提升更加明显,而对于能力本身有限的模型,则无法产生"脱胎换骨"的效果。在实践中,这一点非常重要,不应误以为某种 Prompt 技巧能够彻底改变模型本身的推理能力。
幸运的是,诸如 CoT 这样的 Prompt 技术已经能够让模型显式展示推理过程。正如前面所介绍的,它并不是赋予模型新的能力,而是减少模型直接跳到表面答案的倾向,引导模型生成可以逐步推导的中间步骤,从而提升多步推理表现。
与此同时,另一项重要的发展趋势是专门的推理模型的兴起。OpenAI 的 o 系列模型就是最具代表性的例子。这类模型通过测试阶段计算(Test-time Compute)以及强化学习训练,使模型能够在输出答案之前进行更长时间的内部推理。目前,其他领先模型,例如 Claude 和 Gemini,也已经提供了可配置的推理模式,允许模型进入类似的思考阶段。不过,各家模型在训练方式和底层架构上仍然存在明显差异。
这一差异在实际应用中具有重要意义。具有显式推理能力的模型(例如 OpenAI o 系列、开启 Extended Thinking 的 Claude,以及开启 Reasoning Mode 的 Gemini)能够投入更多计算资源用于思考,因此通常能够获得更好的推理效果,但也会增加 Token 消耗和响应时间。相比之下,没有推理模式的通用模型只能依靠 CoT 等 Prompt 技巧来展示中间推理步骤。这种方式成本更低、速度更快,但最终能力仍然受到模型一次生成能力的限制。
图 5.1 对比了没有推理能力基础设施的普通 LLM(上方)和具有扩展推理能力的模型,在回答复杂问题时所采用的不同策略。
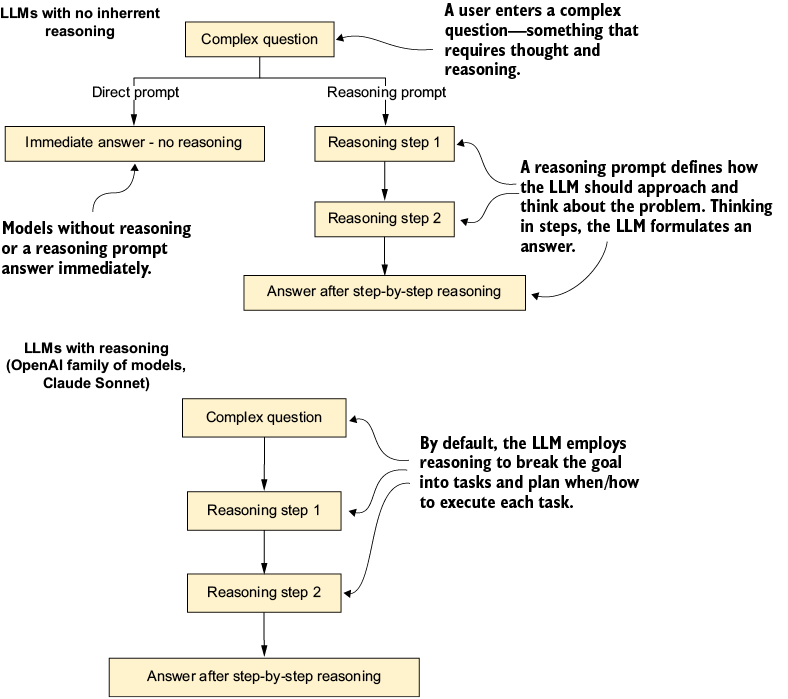
图 5.1 不同 Prompt 策略下推理模型与非推理模型的工作方式
从图中可以看到,对于普通模型而言,需要在 Prompt 中明确提供目标,并结合推理和规划策略,模型才能生成结构化的中间推理步骤。而推理模型则无需这种额外的框架,就能够依靠训练过程中学习到的推理机制,自然地产生完整的思考过程。不过,这种行为依然具有概率性,并且仍然受到 Prompt 的影响。因此,即使是同一个推理模型,在不同请求下,也可能一次进行细致推理,而另一次则快速给出答案。
因此,评估模型是否具有推理能力,不应简单地回答"会"或"不会"。真正值得关注的是:
- 它是否能够稳定地完成你关心的推理任务?
- 每次推理需要付出多少 Token 和延迟成本?
- 相比普通模型结合 CoT Prompt,其性能提升是否足以抵消额外成本?
这些问题才是真正影响生产环境中模型选择的关键因素,而不是关于"模型是否真正会思考"这样的哲学讨论。
如今,推理模型正逐渐成为主流,但模型本身的升级并不能替代 Agent 推理结构的设计。实践中最常用的两种推理模式分别是 Chain-of-Thought(CoT) 和 Reasoning-Acting-Observing(ReAct)。它们解决的是不同的问题,同时也能够很好地适配推理模型和普通模型,因此都值得深入理解。
CoT 将整个推理过程组织成一次线性的推导。模型会先输出若干中间推理步骤,再给出最终答案。这种方式非常适合那些无需访问外部信息、仅依靠已有知识即可完成推导的问题。现代推理模型本身就是利用大量 CoT 推理轨迹进行训练的,因此在推理模型上继续使用 CoT Prompt,更像是在强化模型已经学会的推理模式,而不是教给模型新的能力。
ReAct 则进一步引入了反馈循环。Agent 会在推理、调用工具以及观察工具返回结果之间不断交替进行,从而能够利用新的外部信息持续修正自己的推理过程。正因为如此,ReAct 已经成为绝大多数生产级 Agent 系统以及多 Agent 系统的基础架构。它真正实现了从内部推理到外部行动之间的连接,使 Agent 不仅能够思考,还能够采取行动并根据反馈不断调整策略。
最后,需要明确一点:无论是 CoT 还是 ReAct,它们本质上都是对模型推理过程的引导和偏置,而不是严格控制模型如何思考。即使采用了结构化 Prompt,大语言模型依然属于概率模型。因此,同一个 Agent、同一套 CoT 或 ReAct Prompt,在不同运行过程中仍然可能产生不同的推理路径。
此外,新一代模型相比旧模型的能力提升,也不仅仅来自于显式推理机制。模型规模、更大的训练算力、更高质量的数据以及后训练优化等多个因素,共同造就了今天推理模型的性能提升,没有任何单一因素能够完全解释这种差距。因此,在设计 Agent 时,应把推理模式视为众多优化手段中的一种,而不是一种能够弥补模型所有不足的万能技术。
5.1.1 链式思维(Chain-of-Thought,CoT)推理
COT 是一种 Prompt 技术,它引导大语言模型按照逐步推理的方式解决问题,而不是直接跳到最终答案。在 CoT 方法中,模型会先生成一系列中间推理步骤(即"思维链"),然后再给出最终答案。这种过程相当于帮助 LLM 将复杂问题拆解为多个较小的步骤,因此能够显著提升 Agent 在复杂任务上的表现。
使用 CoT Prompt 时,我们实际上是在向 LLM 演示"应该如何思考"。你可以很容易地亲自验证这一点:打开 ChatGPT,分别选择普通模型和推理模型,然后输入下面的示例 Prompt。
清单 5.1 01_demonstrating_CoT_reasoning.md
# 时间旅行问题
在一部科幻电影中,Alex 是一名时间旅行者。他决定回到过去,
亲眼见证一场发生在 100 年前、持续 10 天的著名历史事件。
他提前 3 天到达事件发生地。
然而,在过去待了 6 天之后,他又向未来跳跃了 50 年,
在那里停留了 20 天。
随后,他再次回到过去,亲眼见证了这场历史事件的最后一天。
请问,在看到事件结束之前,Alex 一共在过去度过了多少天?
这个问题包含了一些容易混淆的时间参考,因此对于普通模型来说往往比较困难,即使是推理模型,有时也可能答错。
正确答案应该是 26 天,但根据所使用模型的不同,你也可能得到 6 天、13 天或 27 天等错误答案。有些模型甚至第一次回答正确,下一次又给出了不同的结果。
正确答案解析
为了得到 26 天这一正确答案,可以将时间旅行过程拆解计算。为了更容易理解,我们假设当前时间为 2026 年。
- 第一次跳跃:回到 1926 年,也就是事件开始前三天,在 1926 年停留了 6 天。
- 第二次跳跃:向未来前进 50 年,到达 1976 年。虽然时间向前推进,但对于 Alex 来说,这仍然属于过去,因此他又在这里停留了 20 天。
- 第三次跳跃:再回到 1926 年,来到事件最后一天,亲眼见证事件结束,并假设当天没有继续停留。
- 第四次跳跃:返回 2026 年,也就是当前时间。
因此,Alex 在过去真正停留的时间只有:
- 1926 年:6 天
- 1976 年:20 天
合计:6 + 20 = 26 天。
LLM 容易在这个问题上出错,主要原因在于它很难不断切换不同时间参考系和观察视角。为了帮助模型正确推理,我们可以在 Prompt 中加入 CoT 推理策略,明确告诉模型应该按照怎样的思考过程解决这类问题。下面是在原始 Prompt 后追加的 CoT 推理模板。
清单 5.2 01_demonstrating_CoT_reasoning.md(续)
# 在 Prompt 后追加
CoT 推理策略
步骤1:将当前时间定义为 Year 0,过去定义为负年份。
步骤2:绘制旅行者整个时间旅行路线,包括每一次到达的位置以及停留时间。
步骤3:判断哪些时间段对于旅行者而言属于"过去"。
步骤4:统计旅行者每次停留在过去所经历的天数。
步骤5:累计在看到事件结束之前,所有属于过去的停留时间。
步骤6:再次检查计算结果,确保所有过去时间都已统计,同时排除现在和未来的时间。
把这一套可以重复使用的 CoT 推理流程加入 Prompt 后,相当于直接告诉 LLM 应该按照哪些步骤思考问题。当输入完整 Prompt(先输入问题,再追加 CoT 推理策略)之后,模型通常会依次完成每一个推理步骤,然后给出最终答案。绝大多数情况下,加入 CoT 后模型更容易得到正确答案。不过,不同模型之间仍然存在差异,有些模型依然可能无法完全正确地完成推理。
如果某个模型仍然表现不好,不要急于认为 CoT 方法失效了。更多时候,是因为 CoT 的步骤设计还没有充分适配该模型的表达习惯或推理方式,需要不断调整 Prompt,使其更符合模型擅长理解的语言风格。
图 5.2 对比了 LLM 在没有任何推理提示和使用 CoT Prompt 两种情况下的推理过程。
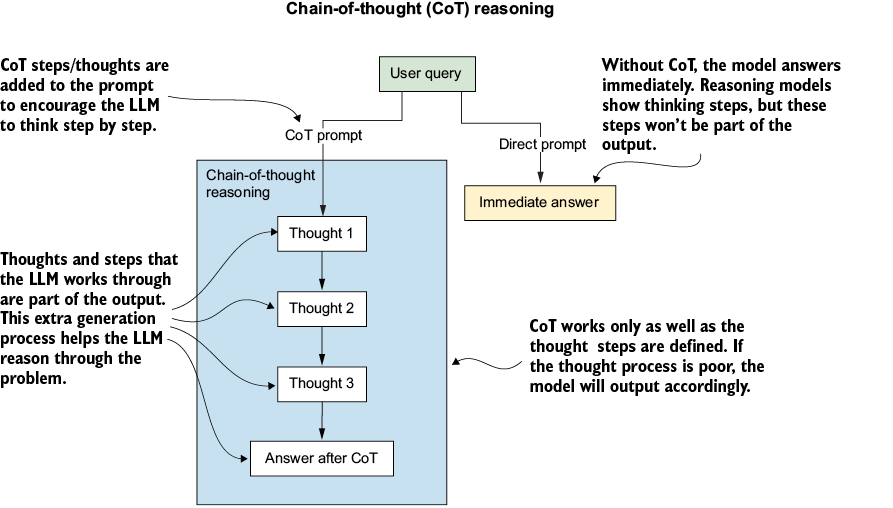
图 5.2 使用 CoT Prompt(左)与未使用任何推理提示(右)时,LLM 思考过程对比
从图中可以看到,当采用 CoT Prompt 时,LLM 会将整个推理过程中的每一步都输出出来。这一特点带来了一个非常重要的优势:开发者可以检查模型每一步的思考过程,从而快速定位推理究竟是在什么地方出现了偏差。当然,也必须认识到,CoT 并不是一种"万能技巧"。很多时候,为了让 LLM 按照预期的方式进行思考,需要不断调整 Prompt,并经过大量实验才能达到理想效果。
采用 CoT Prompt 的主要优势包括:
- 可以观察模型完整的推理过程;
- 更容易验证模型是否按照预期进行推理和规划;
- 能够将复杂推理组织成结构化的思考流程,提高多步骤任务的成功率。
与此同时,它也存在一些明显的代价:
- Token 消耗更多;
- 推理延迟更高;
- 输出内容更长。
此外,CoT 对最终输出的控制能力仍然有限。它能够帮助模型"更好地思考",却无法完全保证最终答案一定正确。正如下一节将介绍的,还有一些比 CoT 更有效的方法,可以进一步管理和约束 Agent 的推理过程。
5.1.2 推理、行动、观察:ReAct 范式
与 CoT 将整个推理过程完全保留在内部不同,ReAct 范式采用的是一种交替循环的方式:不断在推理和行动之间切换。模型会先通过自然语言分析当前情况,决定下一步应该做什么,然后执行相应的动作,例如调用外部工具或访问 API。每完成一次行动,模型都会观察执行结果,并根据反馈调整自己的推理,再进入下一轮循环。
ReAct 与 CoT 真正的区别,并不在于是否调用了工具,而在于是否存在持续的反馈闭环。如果只是一次 CoT 推理过程中插入一次工具调用,本质上仍然属于一次性的推理流程。而 ReAct 是一个完整的闭环:每一次观察结果都会影响下一轮推理,使 Agent 能够纠正错误、吸收新的信息,并在任务执行过程中动态调整计划。
这种“思考—执行—观察(Think–Act–Observe)”的节奏,使 Agent 能够在每一步获取新的信息,并据此决定下一步该如何行动。ReAct 更偏向一种响应式的工作方式,而不是先制定完整计划再严格执行。模型每次只推理当前的一步,根据最新获得的观察结果决定下一步动作,而不是一开始就生成整个任务的全局计划。真正负责驱动这一循环的,其实是 Agent 框架本身,而不是模型:框架负责调用模型、执行工具、返回观察结果,再继续调用模型,如此不断循环。
图 5.3 展示了 ReAct 模式的顺序图,包括推理(Reason)、**执行(Act)和观察(Observe)**三个阶段。该图将外部编排过程清晰地展示出来,因为真正决定 Agent 实际行为的,并不是模型本身,而是围绕模型构建的这一套循环机制。
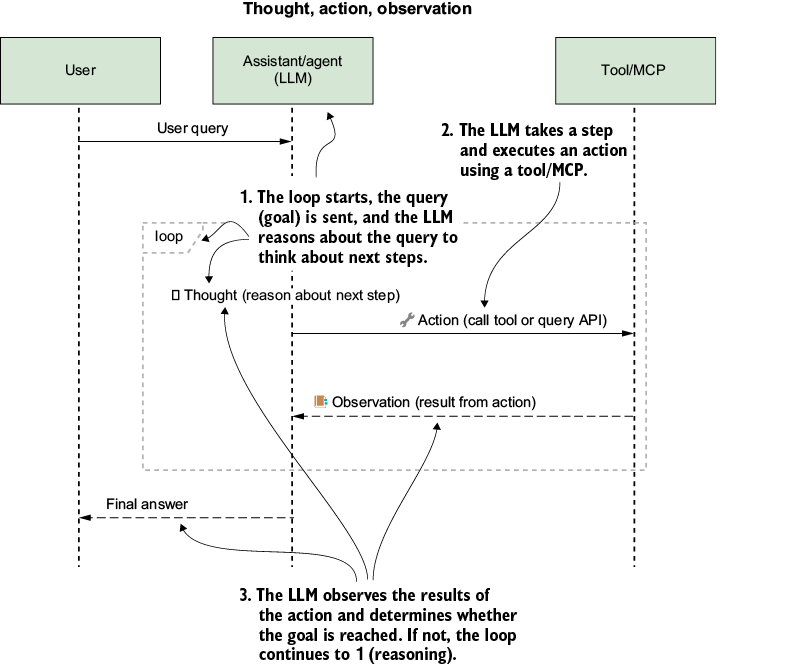
**图 5.3 ReAct 推理范式的顺序图。**Agent 的思考过程发生在循环之中:LLM 首先进行推理和规划,然后执行计划。当每一次任务(工具)执行结束后,LLM 会观察执行结果,再判断是否继续循环,还是认为任务已经完成并输出最终结果。
从图中可以看到,用户首先向 Agent(或 Assistant)发出请求,随后 Agent 开始进入循环。第一步,Assistant 会分析完成任务所需要的步骤,并形成当前的思考或执行计划。接着,它调用工具(或 MCP 服务)执行当前步骤,并获取执行结果。如果 Assistant 判断目标已经完成,则退出循环并输出最终答案;如果目标尚未完成,则会结合最新观察结果重新分析当前计划,决定继续执行原计划,还是生成新的步骤计划,然后进入下一轮循环。
事实上,这正是许多推理型 LLM 在解决复杂任务时采用的工作机制。如果模型开放了相应能力,我们通常可以直接观察到它的思考(Thought)、**行动(Action)以及观察(Observation)过程。除此之外,我们还可以在 CoT 和 ReAct 的基础上进一步加入规划(Planning)**能力,对整个推理流程进行更高层次的协调。
5.1.3 使用 LLM 进行规划
除了回答单个问题或执行一次工具调用之外,LLM 还能够进行更高层次的战略规划,以解决复杂的多步骤任务。所谓规划,就是模型会在执行具体步骤之前,或者执行过程中,先制定一个整体行动方案。此时,LLM 或 Agent 不再只关注单次 CoT 或 ReAct 循环,而是能够面向更长时间跨度,对多个推理执行循环进行统一协调。
规划模式与 CoT、ReAct 最大的区别,在于Agent 对整个任务的全局认知存放在哪里。CoT 在一次前向推理中,通过线性的思维链解决一个问题;ReAct 则根据最近一次观察结果逐步决定下一步动作,并没有维护完整的长期计划。
而 Planning 会生成一份显式的执行计划,这份计划通常存储在外部,例如内存(Memory)、Scratchpad(草稿区)或者对话上下文中。Agent 在每一步执行之前都会重新读取这份计划,以确保所有步骤始终围绕最终目标展开。由于 LLM 本身并没有跨调用持续保存状态的能力,也不存在真正意义上的内部世界模型,因此这种全局视角实际上来自系统架构,而不是模型本身。在设计规划型 Agent 时,这一点尤其重要——所有需要持续跟踪的信息,例如子任务、任务依赖、中间结果以及执行进度,都必须显式保存到模型下一次能够重新读取的位置。
对于给定的目标或问题,LLM 非常擅长生成执行计划。随后,它还可以借助工具执行这些计划,并观察执行结果,这一点与前面介绍的 ReAct 非常相似。下面的示例展示了如何通过一个简单的 Prompt,让 ChatGPT、Claude 或 Gemini 为一个目标生成行动计划。
列表 5.3 01_planning_san_fran_trip.md
User: #1
I have 3 days in San Francisco and love AI Agents. Can you plan my itinerary?
Provide three concise (10 words or less) summary bullet points, one for each day.
LLM: #2
Day 1: Explore OpenAI HQ and AI exhibits at Exploratorium
Day 2: Visit Stanford AI Lab and Palo Alto innovation hubs
Day 3: Attend tech meetups, tour AI startups in SoMa
注释
- 1 用户提出需要生成旅行计划。
- 2 LLM 返回一个典型的三天行程规划。
你可以将这个提示输入任何基础大模型。通常,模型会在后台自动完成一些辅助操作,例如执行网络搜索或查询相关信息,以便生成更准确的回答。不过,需要注意的是,模型并不是像人一样先思考如何规划,而是根据训练过程中学到的大量模式,直接生成构成这份计划的一系列 Token。
例如,我们最初得到了一份旧金山三日行程,但后来发现第一天计划中的 Exploratorium(探索博物馆) 当天并未开放,而且原计划中的 AI 创业公司也无法参观。于是,我们将新的观察结果反馈给基础模型,并要求它重新调整整个行程安排。下面展示了这一过程及模型可能给出的回答。
列表 5.4 01_planning_san_fran_trip_updated.md
User: #1
You planned this itinerary for me:
Day 1: Explore OpenAI HQ and AI exhibits at Exploratorium
Day 2: Visit Stanford AI Lab and Palo Alto innovation hubs
Day 3: Attend tech meetups, tour AI startups in SoMa
However, the Exploratorium is closed the first and we there is no startups to tour.
Update my itinerary.
Assistant/LLM: #2
Day 1: Visit OpenAI HQ (exterior photo op only)
Day 2: Explore Gray Area Foundation for the Arts – AI + interactive art exhibits
Day 3: Stroll through Yerba Buena Gardens and nearby Contemporary Jewish Museum with tech-inspired art installations
注释
- 1 将之前生成的计划以及最新观察结果一起提供给模型,并要求重新制定计划。
- 2 LLM 根据新的条件生成了一份更新后的行程安排。
如果你亲自运行上述提示,大概率会得到类似的结果。模型会结合我们提供的新观察信息,对原来的旅行计划进行调整。之后,我们完全可以继续按照新的计划执行;如果执行过程中又出现新的变化,再把新的观察结果反馈给模型,请它再次修改计划。
整个过程实际上就是**规划(Planning)→ 执行(Execution)→ 观察(Observation)→ 再规划(Replanning)**的循环,这与前面介绍的 ReAct 流程非常相似,只不过这里真正执行每一步的是我们自己。
如果把执行者从人类换成 Agent,就可以发现,Agent 同样能够利用这一套机制:制定计划、执行计划、观察结果,并根据新的情况不断调整计划。下一节将进一步介绍 Agent 是如何实现这一过程的。
5.2 指导 Agent 进行推理与规划
理解推理与规划的下一步,是将这些推理方法真正应用到 Agent 中。Agent 本质上是一个围绕 LLM 构建的系统,它不仅包含语言模型,还结合了工具(Tools)、记忆(Memory)、编排逻辑(Orchestration)以及与外部环境交互的能力。其中,LLM 负责推理,而其他组件则负责把推理结果转化为真正能够影响现实世界的行动。
5.2.1 将 CoT 应用于 Agent
首先,我们来看如何让 Agent 具备 CoT(Chain-of-Thought,思维链)推理能力。列表 5.5 展示了一个使用 CoT 的简单 Agent。在这个示例中,我们为 Agent 指定了角色,并通过简洁的逐步思考指令,引导它按照步骤分析问题,而不是直接给出答案。
列表 5.5 02_CoT_agent.py
cot_agent = Agent(
name="TimeTravelerCoT",
instructions=( #1
"You are a time travel problem solver. "
"Work out the solution step by step, then give the final answer."
),
)
question = ( #2
"Starting in 2025, you travel 10 years to the past, then 5 years to the future. "
"What year do you end up in?"
)
result = asyncio.run( #3
Runner.run( #4
cot_agent,
input=question))
print(result.final_output)
OUTPUT
Let's solve this step by step:
1. **Starting Year**: 2025
2. **Travel 10 Years to the Past**:
- 2025 - 10 = 2015
3. **Travel 5 Years to the Future**:
- 2015 + 5 = 2020
注释
- 1 创建 CoT Agent,并为其设置推理指令。
- 2 提出需要 Agent 求解的问题。
- 3 使用异步方式运行 Agent。
- 4 调用
Runner.run()执行 Agent,并返回结果。
从代码和输出结果可以看到,仅仅在 Agent 的系统提示中加入“逐步思考(step by step)”这样的描述,就成功让 Agent 按照 CoT 的方式进行推理。同时,这种推理过程也会完整地体现在 Agent 的输出中,因此我们不仅能获得最终答案,还能够看到模型的思考步骤。接下来,我们将在这个简单示例的基础上,进一步引入 ReAct 推理模式。
5.2.2 在 Agent 中实现 ReAct
ReAct 模式由三个阶段不断循环组成:推理(Reason)→ 行动(Act)→ 观察(Observe)。因此,Agent 必须拥有可以调用的工具(Tools),这样“行动”阶段才有实际执行的对象,而“观察”阶段也才能根据工具返回的结果继续推理。列表 5.6 展示了一个采用 ReAct 模式的简单 Agent,相比前面的 CoT 示例,它新增了两个工具函数。
列表 5.6 02_ReAct_agent.py
@function_tool #1
def travel_back(year: int, years: int) -> int:
"""Travel back in time by a given number of years from the start year."""
return year - years
@function_tool #1
def travel_forward(year: int, years: int) -> int:
"""Travel forward in time by a given number of years from the start year."""
return year + years
react_agent = Agent(
name="TimeTravelerReAct",
instructions=( #2
"You are a time travel assistant. You have tools 'travel_back' and 'travel_forward' to perform time jumps. "
"First, think step-by-step about the problem. If needed, use the tools to calculate dates. "
"After using a tool, reflect on the result and continue reasoning. "
"After gathering information, provide the final answer."
),
tools=[travel_back, travel_forward],
)
problem = (
"I am in the year 2050. I travel 25 years back in time, then travel 10 years forward, "
"and finally go 5 years back again. What year is it now?"
) #3
result = asyncio.run(
Runner.run(
react_agent,
input=problem))
print(result.final_output)
OUTPUT
You are now in the year 2030. #4
注释:
- 1 为 Agent 添加两个可调用的工具,用于执行时间旅行。
- 2 修改系统提示,引导 Agent 按照 ReAct 模式进行推理。
- 3 构造一个需要借助工具才能正确求解的复杂时间旅行问题。
- 4 默认输出仅包含最终答案,不展示中间的推理过程。
从这个示例可以看出,Agent 的系统提示明确要求它按照 ReAct 的思维模式工作:先分析问题,再根据需要调用工具执行操作(Act),随后观察工具返回的结果,最后继续推理,并决定是否需要再次调用工具。
不过,这个示例也有一个不足之处:**虽然 Agent 内部完成了 ReAct 的推理循环,但默认情况下,我们只能看到最终答案,而无法看到它每一步的思考过程。**当然,这并不是 ReAct 本身的限制。后续章节将介绍如何借助日志和工具调用追踪等机制,完整记录 Agent 的整个推理、行动和观察过程,从而更方便地调试和分析 Agent 的行为。
CoT 与 ReAct 都是非常实用的推理模式,它们能够帮助 Agent 更好地处理日常任务或相对简单的问题。不过,对于更加复杂的推理任务,我们还可以采用更高级的规划模式,而这正是下一节将要介绍的内容。
5.3 使用 Agent 的高级推理模式
并非所有 Agent 都需要显式的推理结构。对于那些职责单一、流程明确、只需一步即可完成的任务(例如查询一个数值、调用一次工具或生成固定格式的回复),通常没有必要使用 CoT 或 ReAct,因为这些任务本身并不存在需要组织的多步决策过程。只有当任务需要经历多个决策阶段、依赖中间执行结果,或者复杂到单次推理无法稳定完成时,引入推理模式才真正物有所值。
在绝大多数情况下,CoT 或 ReAct 已经能够满足需求。不过,当你开始构建更加复杂的 Agent 系统,希望它们完成更困难、更开放的问题时,就需要考虑使用更高级的推理模式,例如 Tree-of-Thought(ToT) 和 Reflexion。
5.3.1 Tree-of-Thought(思维树)
Tree-of-Thought(ToT) 本质上是一种针对多个候选推理路径进行搜索的策略,而不是像 CoT 那样单纯的推理框架。CoT 会生成一条线性的思维链,一步一步推导出最终答案;而 ToT 则会同时探索多条不同的推理路径,对每条路径进行评估,剪除前景不佳的分支,并在某条推理失败时回退到其他分支继续搜索。ToT 提出于专门的推理模型尚未出现之前,主要是为了解决传统单次推理模型在需要前瞻性搜索和多路径探索时表现不足的问题。
ToT 特别适合那些战略性探索比单一路径深入推理更重要的问题,例如复杂规划、逻辑谜题以及需要连续决策的棋类或游戏等。这些问题通常存在多个可能的发展方向,仅沿着一条思路推理往往难以找到最优解。如今的新一代推理模型已经能够借助更长时间的内部思考,在一定程度上覆盖 ToT 的部分能力,因此需要专门使用 ToT 的场景比以前少了许多。不过,对于那些拥有明确分支结构、并且能够客观评价不同方案优劣的问题,ToT 仍然具有明显优势。
有一个实践中的问题值得特别说明:**ToT 无法像 CoT 一样,仅靠一个 Prompt 就完整实现。虽然可以通过 Prompt 要求模型生成多个候选方案,再让模型对这些方案进行评分,从而模拟部分 ToT 的流程,但真正定义 ToT 的分支管理、剪枝(Pruning)和回溯(Backtracking)**等过程,都必须依赖外部代码完成。因此,在生产环境中,人们通常会借助 LangGraph 等框架,或者自行编写编排逻辑来实现完整的 ToT。
图 5.4 展示了 ToT 的基本工作流程。从图中可以看到,整个推理过程比 CoT 更加复杂。如果把图中的内容拆解成具体步骤,就更容易理解其工作机制。
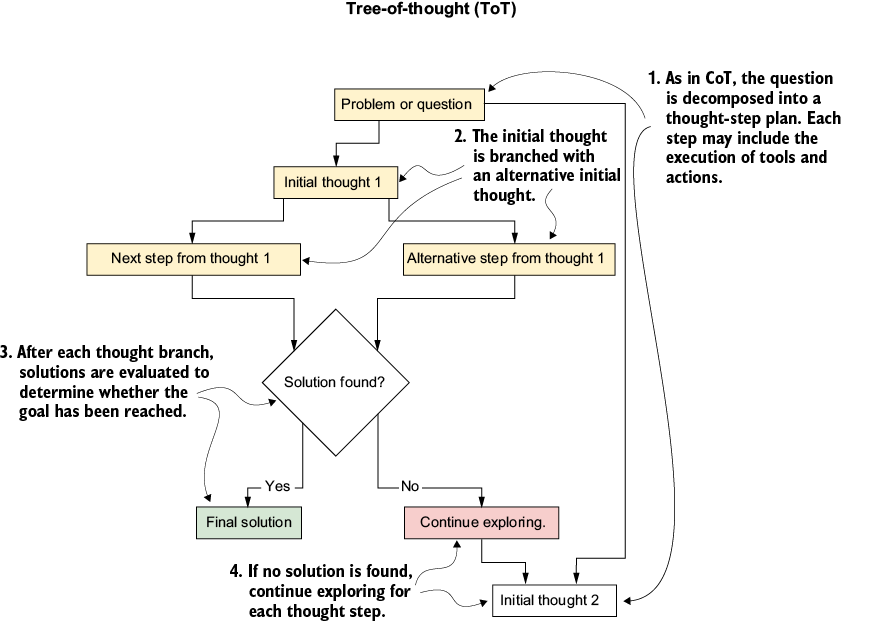
**图 5.4 Tree-of-Thought 工作流程(部分)。**模型生成多个思维分支,每个分支不断扩展为新的节点,并通过持续评估选择最有希望继续发展的路径。
整个流程可以概括为以下五个步骤:
- Agent 首先围绕当前问题生成多个不同的初始思路或解决方案,这些思路共同构成思维树(Thought Tree)的第一层节点。
- 对于每一个候选思路,Agent 都会继续思考下一步应该如何推进,从而使每条思维路径不断向下扩展,形成多个并行发展的推理分支。
- 当每条路径扩展到一定深度后,Agent(或其他评估机制)会对每个叶子节点进行评价,估计该路径最终成功解决问题的可能性。例如,可以要求模型将每条路径评为“Promising(有希望)”或“Unlikely(希望较小)”。
- 根据评估结果,算法会剪除潜力较低的分支,只保留最有希望继续发展的路径,然后再次重复“扩展 → 评估 → 剪枝”的过程。
- 当某条路径已经找到满意的解决方案,或者达到预设的最大搜索深度时,整个搜索过程结束。最终系统会从所有已探索的路径中,选择评分最高的一条作为最终答案。
我们同样可以把这一思想实现为一个 Agent 系统,如列表 5.7 所示。不过,这里的示例只是 ToT 的一个简化版本,它仅对第一层思维节点进行了分支评估。若要实现完整的 ToT,则需要对每一层新的思维节点重复执行相同的扩展与评估过程。
列表 5.7 03_ToT_agents.py
# agents and problem
generator = Agent(
name="ToT-Generator", #1
instructions="Given the current situation, brainstorm a possible next step or action to reach the goal.",
)
# Agent for evaluating partial solutions
evaluator = Agent(
name="ToT-Evaluator", #2
instructions="Assess how likely the proposed plan will solve the problem. Respond with 'promising' or 'unlikely'.",
)
problem = """
You need to reach the year 1800 from 2025 using a time machine
that can jump either -100 or -30 years.
"""
# running agents
initial_thoughts = []
for i in range(3):
resp = await Runner.run( #3
generator,
input=f"Problem: {problem}\nThink of a first step."
)
initial_thoughts.append(resp.final_output.strip())
promising_branches = []
for thought in initial_thoughts:
eval_resp = await Runner.run( #4
evaluator,
input=f"Plan: {thought}\nIs this promising?"
)
if "promising" in eval_resp.final_output.lower():
next_step = await Runner.run( #5
generator,
input=f"Current idea: {thought}\nNext step?"
)
promising_branches.append(
f"{thought} -> {next_step.final_output.strip()}"
)
print("Initial thought candidates:", initial_thoughts)
print(
"Expanded promising branch:",
promising_branches[0] if promising_branches else "None",
)
注释:
- 1 创建 ToT 生成 Agent,负责生成候选思路。
- 2 创建 ToT 评估 Agent,负责判断每条思路是否值得继续扩展。
- 3 首先生成多个第一步候选方案。
- 4 对每一个候选方案进行评估。
- 5 如果方案具有潜力,则继续扩展第二步推理。
从这个示例可以看出,代码实现的只是 ToT 推理模式的一部分,但已经能够体现出它相比 CoT 更高的复杂度。对于每一个思维节点,都需要额外进行评估;而每一次扩展,又可能继续产生新的分支,随后再次进入评估流程。随着思维树不断生长,整个搜索空间会迅速扩大。因此,即使面对一个相对简单的问题,ToT 也可能需要消耗大量 Token,对多条路径进行反复推理和评估,执行时间也会明显增加。这也是为什么 ToT 更适用于那些确实需要复杂搜索和多方案比较的问题,而不是日常的一般性推理任务。
5.3.2 Reflexion(反思推理)
Reflexion(反思)是一种自我批判(Self-Critique)推理模式。在这种模式下,智能体会先评估自己的输出,分析哪里出了问题,然后生成反馈,并结合这些反馈再次尝试解决问题(见图 5.5)。反馈内容可以是一个提示、错误分析,或者针对下一次尝试的具体建议。多次尝试之后之所以能够得到更好的结果,并不是因为模型真正学会了什么,而是因为模型在新的上下文中加入了这些反馈信息,从而能够生成更好的回答,而不是因为模型参数发生了更新。
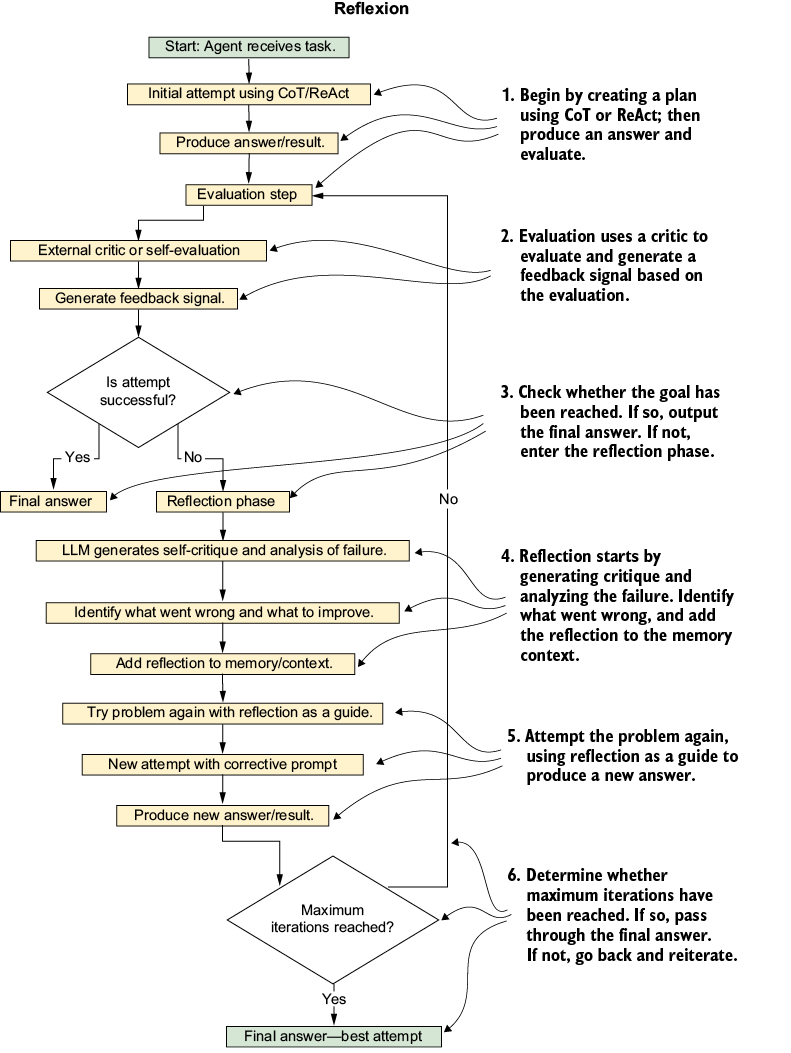
图 5.5 Reflexion 推理策略流程图。流程中的每一步都展示了 LLM 或确定性代码可能执行的任务、判断和输出。
很多早期关于 Reflexion 的论文和教程都会使用“学习”这个说法,但这种描述其实容易产生误解。整个过程中并不存在模型训练、策略优化,模型也不会自动记住之前会话中的经验,除非我们显式地把这些信息保存下来。所谓“学会了”,实际上只是因为模型在第二次推理时,输入中包含了第一次输出的批判意见,因此能够基于更丰富的上下文生成更好的答案,而不是模型本身真正获得了新的能力。
相比 Tree-of-Thought(ToT),Reflexion 的成本通常更低,因为它一次只探索一条推理路径,并不断迭代改进,而不是同时维护多条推理分支。它尤其适用于那些第一次尝试大概率会失败,但失败原因能够提供有效反馈的问题。对于这类任务,一次高质量的批判往往足以指导第二次尝试得到更好的结果。Reflexion 与 ToT 的核心区别可以概括为深度与广度的区别。Reflexion 会不断沿着同一条路径深入修正;而 ToT 则会同时探索多条不同路径,再从中选择最佳方案。
图中的流程展示的是 Reflexion 的一种抽象实现。在实际系统中,其中的大部分步骤通常会分别由**求解智能体(Solver Agent)和批判智能体(Critic Agent)**完成,同时配合一些确定性代码,用于控制重试次数、验证最终结果等硬性规则。
正如前面介绍的其他推理策略一样,Reflexion 通常也是建立在已有推理策略基础上的。例如,它通常会先使用 Chain-of-Thought(CoT)生成初始解答,然后再进入反思、批判和修正流程。下面的代码示例正是采用这种方式,尝试解决前面 Listing 5.1 中提出的复杂时间旅行问题。
Listing 5.8 03_reflexion_agents.py
def get_reflexion_solver_instructions( #1
run_context: RunContextWrapper[str], agent: Agent[str]
) -> str:
"""Generate instructions for the reflexion solver agent."""
instructions = (
"You are a time-travel expert. Solve the problem step by step "
"and be careful to avoid mistakes."
)
return instructions + "\nHINT:\n" + run_context.context
solver = Agent(
name="TimeTravelerReflexion",
instructions=get_reflexion_solver_instructions #1
)
critic = Agent( #2
name="TimeTravelCritic",
instructions=(
"You are an expert tutor. If the solution is wrong, explain the error "
"and give a concise hint for improvement."
),
)
# solver loop
feedback_hint = ""
for attempt_no in range(1, MAX_ATTEMPTS + 1): #3
result = await Runner.run(
solver,
input=problem,
context=feedback_hint) #4
answer = result.final_output.strip()
print(f"\nAttempt {attempt_no}:\n{answer}")
has_correct_days = TARGET_DAYS in answer
says_claim_correct = (
"yes" in answer.lower()
or "correct" in answer.lower()
)
solved = has_correct_days and says_claim_correct
if solved:
print("✅ Solution accepted.")
break
feedback_prompt = (
f"Solution given:\n{answer}\n\n"
f"Expected final days: {TARGET_DAYS}\n"
"Explain the error briefly and give a helpful hint."
)
feedback_resp = await Runner.run(
critic,
input=feedback_prompt
)
hint = feedback_resp.final_output.strip() #4
print(f"Feedback:\n{hint}")
feedback_hint = hint #4
else:
print("\n❌ Max attempts reached without a correct solution.")
代码说明:
- #1 Agent 的 Instructions 在运行时动态生成,因此可以把上下文动态注入到提示词中。
- #2 创建一个 Critic Agent,用来评估 Solver 的答案,并生成反馈意见。
- #3 按照设定的最大次数不断尝试寻找正确答案。
- #4 Critic 生成的反馈会作为 Context 注入到下一轮 Solver 中,实现反思式迭代。
在这个示例中,我们可以看到一个典型的 Solver–Critic 智能体流程。首先,Solver Agent 尝试解决问题;随后,Critic Agent(它已经知道正确答案)会检查 Solver 的输出,对错误进行分析,并生成改进建议。之后,这些反馈会通过 Context 注入到 Solver 的动态 Instructions 中。由于 Agent 的 Instructions 每次运行都会重新生成,因此每一轮都能够携带最新的反馈信息。
理想情况下,通过这种推理 → 反馈 → 修正 → 再推理的循环,基础 Solver Agent 的表现会逐步改善,并越来越接近正确答案。不过,这种模式也存在一个明显缺点:**Critic 必须知道什么才是正确答案,才能提供有效反馈。**这意味着 Reflexion 更适合那些已有标准答案、能够进行自动评测的问题,而不适用于所有开放式任务。不过,如果你拥有大量同类型问题的数据集,可以先利用 Reflexion 求解其中的一部分问题,把 Critic 生成的反馈经验保存到内存或数据库中,之后再利用这些经验去解决整个数据集中的其他类似问题,从而提高整体求解效果。
5.3.3 为智能体选择合适的推理模式
推理策略功能强大,但并不是所有场景都适合使用。究竟应该在什么情况下采用哪一种推理模式,往往需要随着构建推理型智能体的经验不断积累。不过,对于日常开发中的常见场景,目前已经形成了一些较为成熟的最佳实践,如表 5.1 所示。
表 5.1 常见智能体推理策略的最佳实践
| 推理策略 | 最适用场景 | 计算成本 | 不适用场景 | 典型示例 |
|---|---|---|---|---|
| Chain-of-Thought(CoT) | 逻辑推理、数学问题 | 低 | 简单事实查询 | 数独类谜题 |
| ReAct | 知识密集型任务 | 中 | 不需要调用外部工具的任务 | 检索增强问答(Retrieval-Augmented QA) |
| Tree-of-Thought(ToT) | 复杂规划、博弈问题 | 高 | 对时延要求较高的应用 | 策略游戏搜索 |
| Reflexion | 需要不断迭代优化的任务 | 中高 | 一次性问答 | 带反馈循环的代码调试 |
可以看到,这四种推理策略已经能够覆盖绝大多数实际问题。不过,它们本质上仍然建立在普通 LLM、Chain-of-Thought(CoT)或 ReAct 的规划能力之上,因此整体能力最终仍会受到基础推理模式的限制。
幸运的是,Anthropic 提供了一套基于 MCP 的Sequential Thinking(顺序思考)服务器参考实现,为更复杂、更长流程的规划提供了新的解决方案。
5.4 使用 Sequential Thinking MCP Server
虽然目前已经出现了多个 Sequential Thinking(简称 ST)MCP Server 的实现版本,但本书将主要介绍 Anthropic 提供的官方参考实现。智能体可以把这个服务器当作自己的工作记忆(Working Memory)或思维草稿区(Scratchpad)来使用,将推理过程中的中间结果保存下来,供后续步骤继续读取、引用和扩展。实际上,“Sequential Thinking(顺序思考)”这个名字多少有些容易让人误解,因为这个服务器本身并不会进行思考。它真正的职责只是提供一个外部存储空间,用来保存智能体思考过程中产生的中间结果。智能体会在每一步执行时重新读取这些内容,从而在多次模型调用之间保持推理过程的连续性。
允许智能体把自己的思考过程记录下来,可以显著提升它的战略规划能力。当智能体面对复杂任务时,可以先制定一份高层次的整体计划,并把这份计划保存到 ST Server 中。随后,在执行每一个子任务、完成每一个目标的过程中,它都可以不断回顾这份全局规划,根据新的信息进行修改、补充和调整,使整个推理过程更加连贯,也更具策略性。
5.4.1 揭开 Sequential Thinking Server 的工作原理
Sequential Thinking Server 对外只暴露了一个工具,供智能体用于推理和规划。不过,在正式利用这个工具开发智能体之前(其他 MCP 工具也是如此),先理解它的工作方式会更有帮助。
Listing 5.9 展示了一个最基本的示例,它创建了一个 Sequential Thinking Server,并将其挂载到 Agent 上。程序随后会输出 MCP Server 提供的工具列表,以及 Agent 实际能够看到和调用的工具。
Listing 5.9 04_sequential_thinking_agent.py
thinking_srv = MCPServerStdio( #1
name="sequential-thinking",
params={
"command": "npx",
"args": [
"-y",
"@modelcontextprotocol/server-sequential-thinking"
],
},
)
instructions = """
You are helpful planning assistant.
"""
agent = Agent(
name="Assistant",
instructions=instructions,
mcp_servers=[thinking_srv], #2
)
async with thinking_srv:
tools = await thinking_srv.list_tools()
print("Available tools:", tools) #3
goal = """
Discover and output the tool and functions you have available.
"""
print("Running...", goal)
result = await Runner.run(agent, goal)
print(result.final_output)
代码说明:
- #1 创建 Sequential Thinking MCP Server。
- #2 将 ST Server 挂载到 Agent,使智能体可以调用其中的工具。
- #3 输出 MCP Server 提供的全部工具列表。
智能体本身还内置了一个名为 multi_tool_use.parallel 的工具,它允许 Agent 同时并行调用多个工具,因此这个工具也会出现在输出中。除此之外,我们还能看到另一个工具——SequentialThinking。
Listing 5.10 展示了这个工具源码中的描述信息,也就是LLM 真正看到的 Tool Description。
需要注意的是,ST Server 虽然只有一个工具,但这个工具接收的是一个 JSON 对象,其中包含了多种不同的操作参数,因此能够完成复杂的推理流程。
Listing 5.10 SequentialThinking 工具描述
A detailed tool for dynamic and reflective problem-solving through thoughts.
This tool helps analyze problems through a flexible thinking process that can adapt and evolve.
Each thought can build on, question, or revise previous insights as understanding deepens.
When to use this tool:
- Breaking down complex problems into steps
- Planning and design with room for revision
- Analysis that might need course correction
- Problems where the full scope might not be clear initially
- Problems that require a multi-step solution
- Tasks that need to maintain context over multiple steps
- Situations where irrelevant information needs to be filtered out
Key features:
- You can adjust total_thoughts up or down as you progress
- You can question or revise previous thoughts
- You can add more thoughts even after reaching what seemed like the end
- You can express uncertainty and explore alternative approaches
- Not every thought needs to build linearly - you can branch or backtrack
- Generates a solution hypothesis
- Verifies the hypothesis based on the Chain of Thought steps
- Repeats the process until satisfied
- Provides a correct answer
Parameters explained:
- thought: Your current thinking step, which can include:
* Regular analytical steps
* Revisions of previous thoughts
* Questions about previous decisions
* Realizations about needing more analysis
* Changes in approach
* Hypothesis generation
* Hypothesis verification
- next_thought_needed: True if you need more thinking, even if at what seemed like the end
- thought_number: Current number in sequence (can go beyond initial total if needed)
- total_thoughts: Current estimate of thoughts needed (can be adjusted up/down)
- is_revision: A boolean indicating if this thought revises previous thinking
- revises_thought: If is_revision is true, which thought number is being reconsidered
- branch_from_thought: If branching, which thought number is the branching point
- branch_id: Identifier for the current branch (if any)
- needs_more_thoughts: If reaching end but realizing more thoughts needed
You should:
1. Start with an initial estimate of needed thoughts, but be ready to adjust
2. Feel free to question or revise previous thoughts
3. Don't hesitate to add more thoughts if needed, even at the "end"
4. Express uncertainty when present
5. Mark thoughts that revise previous thinking or branch into new paths
6. Ignore information that is irrelevant to the current step
7. Generate a solution hypothesis when appropriate
8. Verify the hypothesis based on the Chain of Thought steps
9. Repeat the process until satisfied with the solution
10. Provide a single, ideally correct answer as the final output
11. Only set next_thought_needed to false when truly done and a satisfactory answer is reached
需要牢记一点:Tool Description 就是 Agent 看到的全部信息,也是它理解和使用工具的依据。从上面的描述也可以看出,SequentialThinking 工具本身并不会进行思考或推理。它更准确地说只是一个思维草稿本(Scratchpad)和思考过程记录器(Thought Tracker)。真正负责推理的仍然是底层的大语言模型,而 ST Server 只是帮助模型记录每一步思考,并在后续步骤中重新读取这些内容,以保持推理过程的连续性。事实上,也存在其他版本的 Sequential Thinking Server,它们会结合 LLM 或多个 Agent 一起工作,由模型真正负责推理和规划,而不仅仅提供思维记录功能。
另外,你可能也已经注意到,ST Server 完全支持 ReAct 和 Tree-of-Thought(ToT) 等推理与规划策略。要让 Agent 使用这些高级推理模式,并不需要修改 ST Server 本身,只需要在 Prompt 中编写相应的 Instructions,引导 Agent 按照对应的推理流程进行思考即可。
5.4.2 使用 Sequential Thinking 再次解决时间旅行问题
为了演示 Sequential Thinking Server 的工作方式,我们再次回到 Listing 5.1 中那个较为复杂的时间旅行问题。Listing 5.11 展示了更新后的代码,其中包括之前那个复杂的时间旅行题目、重新设计后的 Agent Instructions,以及新增的 travel_back 和 travel_forward 两个工具。
这段代码将 MCP Server 及其提供的工具一起挂载到 Agent 上,然后要求 Agent 去解决这个时间旅行问题。整个推理过程都是由 Agent 在内部完成的,它既可以调用代码中定义的工具,也可以调用 Sequential Thinking MCP Server 提供的工具进行规划和推理。
Listing 5.11 04_time_travel_agent.py
@function_tool #1
def travel_back(year: int, years: int) -> str:
"""
Travel back in time by a given number of years from the start year.
"""
print(f"Time travel back by {years} years")
return f"Current year in time: {year - years}"
@function_tool #1
def travel_forward(year: int, years: int) -> str:
"""
Travel forward in time by a given number of years from the start year.
"""
print(f"Time travel forward by {years} years")
return f"Current year in time: {year + years}"
async def main():
thinking_srv = MCPServerStdio(
name="sequential-thinking",
params={
"command": "npx",
"args": [
"-y",
"@modelcontextprotocol/server-sequential-thinking"
],
},
)
instructions = """ #2
You are a time travel assistant.
You have tools 'travel_back' and 'travel_forward' to perform time jumps.
First, think step-by-step about the problem.
You must use the tools to calculate dates.
After using a tool, reflect on the result and continue reasoning.
After gathering information, provide the final answer.
"""
agent = Agent(
model="gpt-4o", #3
name="Time Travel Agent",
instructions=instructions,
tools=[travel_back, travel_forward],
mcp_servers=[thinking_srv],
)
async with thinking_srv:
time_travel_problem = """ #4
In a sci-fi film, Alex is a time traveler who decides to go back in time
to witness a famous historical event that took place 125 years ago,
which lasted for 10 days. He arrives three days before the event starts.
However, after spending six days in the past, he jumps forward in time
by 50 years and stays there for 20 days. Then, he travels back to
witness the end of the end. Alex current year is 2050.
How many days does Alex spend in the past before he sees the end of the event?
"""
print("Running...")
result = await Runner.run(
agent,
time_travel_problem,
max_turns=25, #5
)
print(result.final_output)
代码说明:
- #1 定义两个时间旅行工具,分别负责向过去和向未来跳跃时间。
- #2 更新 Agent 的 Instructions,引导 Agent 按照 ReAct 思维模式进行推理。
- #3 指定本示例使用的模型。不同模型的推理能力不同,因此最终结果可能存在差异。
- #4 要求 Agent 解决复杂的时间旅行问题。
- #5 提高
max_turns,允许 Agent 拥有更多轮次进行思考、推理以及调用工具。
运行这段代码之后,可以观察 Agent 最终给出的答案,无论它是正确还是错误。实际上,在代码运行过程中,Agent 内部已经完成了大量工作,而我们通过 print() 语句能够看到的,仅仅只是整个执行过程中的极少一部分信息。幸运的是,我们可以借助 OpenAI Traces 来深入查看 Agent 的完整执行过程,如图 5.6 所示。
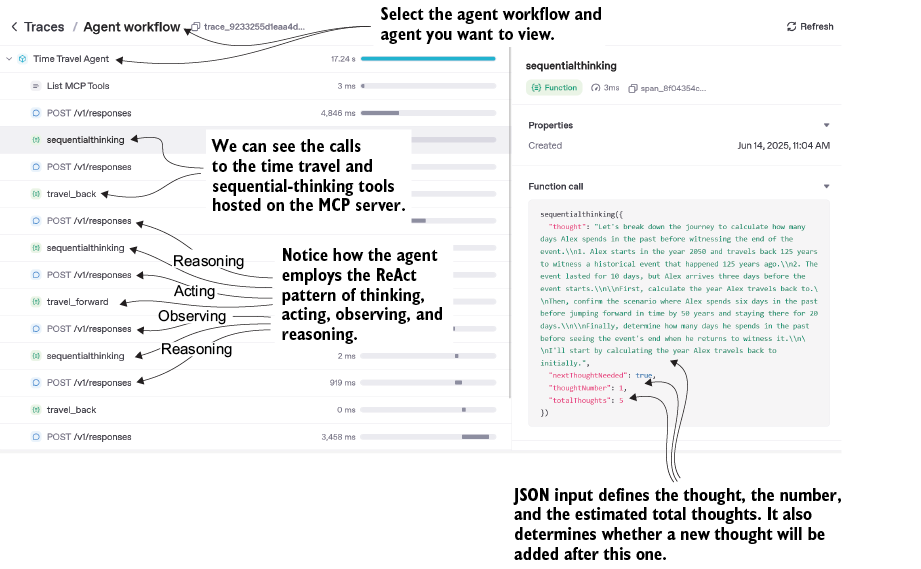
图 5.6 Time Travel Agent 的 Traces 页面。从这里可以看到,Agent 是如何按照 ReAct 模式不断经历“推理(Reason)→ 行动(Act)→ 观察(Observe)→ 再次推理(Reason)”这一循环的。
在 Traces 页面中,我们能够看到 Agent 与时间旅行工具以及 sequential-thinking 工具之间发生的所有交互。从这些调用记录中可以推断出,每一次调用 sequential-thinking 工具,都对应着一次推理过程。随后,Agent 会进入行动(Act)阶段,调用时间旅行工具完成具体计算;接着根据工具返回的结果进行内部观察(Observe);最后再次调用 Sequential Thinking 工具,判断当前目标是否已经完成,还是需要继续下一轮推理。这种不断循环的**推理(Reason)→ 行动(Act)→ 观察(Observe)**流程,正是本章前面介绍过的 ReAct 推理模式。
不过,需要注意的是,根据所使用模型能力的不同,Agent 最终仍然有可能给出错误答案。这并不意味着 Sequential Thinking 没有发挥作用。真正的问题在于,我们还需要进一步学习如何正确地利用这一强大的工具,帮助 Agent 更好地完成复杂任务和复杂推理,这也是接下来将要介绍的内容。
5.4.3 使用 Sequential Thinking 实现高级推理
Sequential Thinking(ST)服务器允许你将多种推理模式组合使用,并帮助你记录每种推理方式在 Agent 中的执行过程。在本章最后一个推理示例中,我们会把前面介绍的所有推理模式整合到一起:使用 CoT(Chain of Thought) 进行规划,使用 ReAct 与 ToT(Tree of Thought) 执行和评估计划,再借助 Reflexion 提供反馈,让 Agent 最终推导出正确的解决方案,如代码清单 5.12 所示。需要注意的是,这种多种推理模式叠加、再结合 ST 服务器的方案,更适用于复杂、模糊、开放性的问题,而不适合那些要求低延迟、快速响应的简单任务。
运行这个示例时,请做好等待较长时间的准备,同时也要预留较高的 Token 消耗。这是因为我们加入了 ToT 和 Reflexion 两种计算开销较大的推理策略,它们都会显著增加模型的推理成本。最终效果还会受到所选底层模型能力的影响:推理能力更强的大模型通常能够取得不错的结果,而能力较弱的模型则可能无法很好地完成任务。
代码清单 5.12 04_time_travel_agent_reasoning.py(仅展示关键代码)
@function_tool #1
def how_correct_is_answer(days_in_the_past: int) -> str:
"""
Returns how many days away from the correct answer the provided answer is.
If the answer is correct, returns a confirmation message.
"""
correct_days = 26 #2
diff = days_in_the_past - correct_days
if diff == 0:
answer = "Correct answer!"
else:
answer = f"{diff:+d} days away from the correct answer."
print(f"Answer is {answer}")
return answer
instructions = """ #3
You are a time travel assistant.
You have tools 'travel_back' and 'travel_forward' to perform time jumps.
First, think step-by-step about the problem to devise a plan.
You must use the tools to calculate dates.
After using a tool, reflect on the result and continue reasoning.
Consider braching out your reasoning into multiple branches if necessary.
Execute and consider each branch step-by-step. #4
Check the answer is correct using 'how_correct_is_answer' tool. #5
If the answer is correct (0 days) provide the final answer and plan. #5
If the answer is not correct, continue reasoning and try to find the correct #5
answer. #5
"""
代码说明:
- 新增一个工具函数,用于检查 Agent 给出的答案是否正确。
- 正确答案预先设定为 26 天。
- 更新 Agent 的提示词,引入更多高级推理策略。
- 引导 Agent 在必要时采用 Tree of Thought(ToT),将推理扩展为多个分支进行探索。
- 要求 Agent 使用
how_correct_is_answer工具验证结果;如果答案错误,则继续推理并尝试修正,这实际上就是 Reflexion 的实现方式。
- 要求 Agent 使用
需要指出的是,这种多种推理策略组合并不适用于所有场景。其中一个明显的限制在于,Reflexion 往往要求系统事先知道正确答案,以便对 Agent 的输出进行评估和反馈,而现实任务中并不一定具备这样的条件。
不过,如果 Agent 最终能够给出正确答案,并同时生成完整的推理计划,我们就可以把这一过程保存下来,作为高质量示例注入到后续 Prompt 中。代码清单 5.13 展示了这样一种做法:将通过 Reflexion 得到的优秀推理过程直接写入 Agent 的系统提示词,使其今后解决同类时间旅行问题时能够参考这一范例。
代码清单 5.13 在 Agent 提示词中加入示例问题及推理计划
You are a time travel assistant.
You have tools 'travel_back' and 'travel_forward' to perform time jumps.
First, think step-by-step about the problem to devise a plan.
You must use the tools to calculate dates.
After using a tool, reflect on the result and continue reasoning.
Example Problem:
In a sci-fi film…
Plan & Calculation:
1. Start year: 2050.
2. Jump back 125 years ⟹ 1925 (arrive 3 days before the event).
3. Spend 6 days in 1925 (3 days before the event + first 3 days of the event).
4. Jump forward 50 years ⟹ 1975.
5. Spend 20 days in 1975.
6. Jump back 50 years to 1925, arriving exactly at the final moment of the event and witnessing its end.
Total days Alex actually experiences in the past before seeing the end of the event:
• First stay: 6 days
• Second stay: 20 days
Total = 26 days.
Answer: Alex spends 26 days in the past before he sees the end of the event.
最终采用哪一种推理策略,应当根据具体应用场景进行选择。不同策略在不同模型上的效果也可能存在明显差异,同一种 Prompt 在不同模型上的表现往往并不一致。可以确定的是,Sequential Thinking 服务器为 Agent 提供了一个高效的外部推理草稿板(Reasoning Scratchpad)。借助这一能力,Agent 能够持续记录、回顾和修正自己的思考过程,从而在复杂任务中展现出更强的推理与规划能力。
推理和规划构成了构建高质量 Agent 的第二大核心支柱。在此前的章节中,我们已经介绍了第一项核心能力——行动与自主性。下一章将继续介绍第三项关键能力:记忆与知识,进一步完善 Agent 的整体能力体系。
5.5 练习
练习 1:添加 Chain-of-Thought(CoT)推理
目标: 为一个简单 Agent 添加显式的逐步推理能力。
任务:
- 打开本章示例中的
02_CoT_agent.py。 - 将其另存为
exercise1_cot_reasoning.py。 - 修改 Agent 的
instructions,要求模型在最终答案之前,将每一步推理按编号输出(1、2、3……)。 - 连续运行脚本两次,确认输出中能够看到清晰编号的推理过程,并在最后给出最终答案。
预计耗时: 8 分钟
练习 2:将 CoT 扩展为带工具调用的 ReAct
目标: 让 CoT Agent 能够调用工具执行操作,并根据结果继续推理。
任务:
将
exercise1_cot_reasoning.py复制为exercise2_react_agent.py。添加代码清单 5.6 中的两个时间旅行工具:
travel_back和travel_forward。修改 Agent 提示词,使其遵循 ReAct 循环:
思考→(如有需要)调用工具→观察结果→继续思考。
输出完整的执行轨迹(
result.trace),以便在控制台中查看工具调用(TOOL)。验证 Agent 至少调用了一次工具,并最终返回正确的年份。
预计耗时: 12 分钟
练习 3:集成 Sequential Thinking MCP Server
目标: 为 Agent 增加一个支持多步推理的外部思维草稿板(Scratchpad)。
任务:
将
04_sequential_thinking_agent.py复制为exercise3_st_server.py。保留
travel_back与travel_forward两个工具,但删除其中所有print语句。修改 Agent 的提示词,要求:
在选择任何时间旅行工具之前,每一步推理都必须先使用
SequentialThinking工具。使用代码清单 5.11 中的复杂时间旅行谜题运行 Agent,并设置
max_turns = 25。打开 OpenAI → Dashboard → Traces 查看执行过程,并在脚本末尾以注释形式记录以下工具分别调用了多少次:
SequentialThinkingtravel_backtravel_forward
预计耗时: 15 分钟
练习 4:使用 Tree-of-Thought 分支搜索并进行剪枝
目标: 探索多个推理分支,仅保留最有希望的方案。
任务:
将
03_ToT_agents.py复制为exercise4_tot_branch.py。将生成初始思路(
initial-thought)的循环由 3 个候选减少为 2 个,但要求每个候选继续扩展两层推理后再进行评估。修改评估 Agent 的提示词,使其输出:
score = <0~10之间的分数>,而不是简单返回"promising"或"unlikely"。推理完成后,仅保留评分 ≥ 7 的分支,并打印这些分支。
运行脚本,并在控制台注释中记录:
- 总共进行了多少次 LLM 调用;
- 最终保留下来了多少条推理分支。
预计耗时: 18 分钟
练习 5:使用 Reflexion 实现自动重试
目标: 添加一个 Critic Agent,通过不断反馈来改进 Solver,直到通过验证工具的测试。
任务:
从
03_relexion_agents.py开始,将其保存为exercise5_reflexion_retry.py。将硬编码的
TARGET_DAYS替换为一个新的工具:check_answer(days: int) -> bool当
days == 26时返回True。修改 Critic Agent,使其调用
check_answer:- 如果返回
False,则输出一句以"Hint:"开头的提示信息; - 如果正确,则无需提供提示。
- 如果返回
将整个 Reflexion 循环限制为最多 4 次尝试。
如果四次仍未成功,则输出:
FAILED_AFTER_4_TRIES分别演示两种情况:
- 成功路径:确保 Agent 在第 4 次以内得到答案 26;
- 失败路径:临时修改
check_answer工具,使正确答案变为 42,验证最终输出FAILED_AFTER_4_TRIES。
预计耗时: 15 分钟
本章总结
- 大语言模型默认并不会真正“思考”,它本质上只是 Token 预测器。因此,要让 Agent 能够完成多步骤任务,必须为其引入结构化的推理与规划机制。
- Chain-of-Thought(CoT)提示能够把模型原本隐式的推理过程显式地逐步展开,方便调试和分析,但也会增加 Token 消耗和响应延迟。
- ReAct 在 CoT 的基础上加入了工具调用机制,形成 思考 → 行动 → 观察 → 再思考(Reason → Act → Observe → Repeat) 的循环,使 Agent 能够动态获取外部信息,并不断调整自己的计划。
- 高层规划不仅仅是完成一次推理链,而是让 Agent 先制定整体战略,再根据真实世界的反馈不断修正和更新计划。
- Tree-of-Thought(ToT)通过同时探索多个推理分支,对效果较差的分支进行剪枝,并继续扩展最有潜力的方案,非常适合复杂搜索问题,但 Token 消耗极高。
- Reflexion 在任何推理策略外部增加了一层 Solver–Critic 循环:Critic 给出反馈,Solver 根据反馈重新尝试,直到结果通过预设的验证标准。
- 推理策略应根据具体任务选择:CoT 适合逻辑推理,ReAct 适合大量工具调用,ToT 适合复杂规划,而 Reflexion 适合需要持续优化答案的场景。在实际项目中,这些策略往往可以组合使用。
- Sequential Thinking MCP Server 可以作为一种通用的“思维草稿板(Scratchpad)”。Agent 可以在其中记录、修改、分支自己的推理过程,同时继续配合 ReAct 或 ToT 等策略完成任务。
- 多种推理策略组合后,可以进一步提升复杂问题的解决能力。例如,可以先用 CoT 制定计划,再通过 ReAct 与 ToT 执行和扩展方案,最后利用 Reflexion 进行自我评估与重试。这种方式虽然延迟较高,但通常也拥有更高的可靠性。
- 无论采用何种推理策略,都应配合 Guardrails、防护规则、Schema 约束以及类型化输出,对推理结果进行验证,避免错误在 Agent 流程中不断传播。
- 模型的能力依然至关重要。更新一代、具备原生推理能力的模型(例如 GPT-4o 系列)通常只需较少的 Prompt 就能完成复杂推理;而基础模型则需要更多提示和引导才能达到类似效果。
- 保持工具数量精简十分重要。每增加一个工具,都会增加 ReAct 循环以及 Sequential Thinking 调用时的上下文开销,因此建议每个 Agent 的工具数量控制在 10 个以内,并确保每个工具都与其职责密切相关。
- 一个真正适用于生产环境的推理 Agent,通常需要同时具备:结构化 Prompt、合适的推理策略、Sequential Thinking 作为思维记录机制,以及 Guardrails 负责结果验证。只有这样,Agent 才能持续制定计划、根据反馈调整方案、自动重试,并稳定完成复杂任务。