本章内容
- 介绍智能体评估与反馈
- 实现测试驱动的智能体开发
- 使用落地验证(grounding)、批评者(critic)和评估智能体
- 使用 Phoenix 进行评估与反馈
评估与反馈为智能体的健壮性提供了可衡量、可改进的方法。它们本身并不会产生健壮性;一个架构设计不合理的智能体,即使拥有完善的评估体系,也仍然会以各种方式失败。评估与反馈真正提供的是对系统实际行为的可见性,以及随着时间推移不断迭代和改进系统行为的机制。
智能体评估有多种形式,包括基准测试、红队测试、落地验证,以及由一个智能体评估另一个智能体的评估机制。针对智能体设计的反馈系统同样来源广泛,包括人工审核者、评估智能体、测试结果以及自我评估机制。每一种方式都在回答关于智能体的不同问题,并且在开发生命周期中承担着不同角色。
虽然在生产环境中的智能体系统里,实现评估和反馈通常是一项必要工作,但这并不意味着你应该等到开发最后阶段才考虑如何增强智能体系统的可靠性。实际上,你几乎总是应该将这一最终层(也就是图 3.7 中展示的第五层——评估与反馈层)纳入智能体架构中。本章将深入探索这一层。
7.1 介绍智能体评估与反馈
在本节中,我们将从更高层次观察智能体周围的各种评估机制和反馈闭环,包括测试、人类反馈以及自动化评估器。智能体依赖内部评估和反馈机制,这些机制会在感知-规划-执行-学习(sense-plan-act-learn)流程中的 Learn(学习)阶段被激活。此外,我们还可以为智能体提供外部评估机制,这些机制能够向智能体本身或者开发者提供反馈。
图 7.1 展示了围绕单个面向用户智能体可能存在的各种评估和反馈步骤与系统,包括红队测试、基准测试、落地验证智能体、批评智能体以及人工评估。
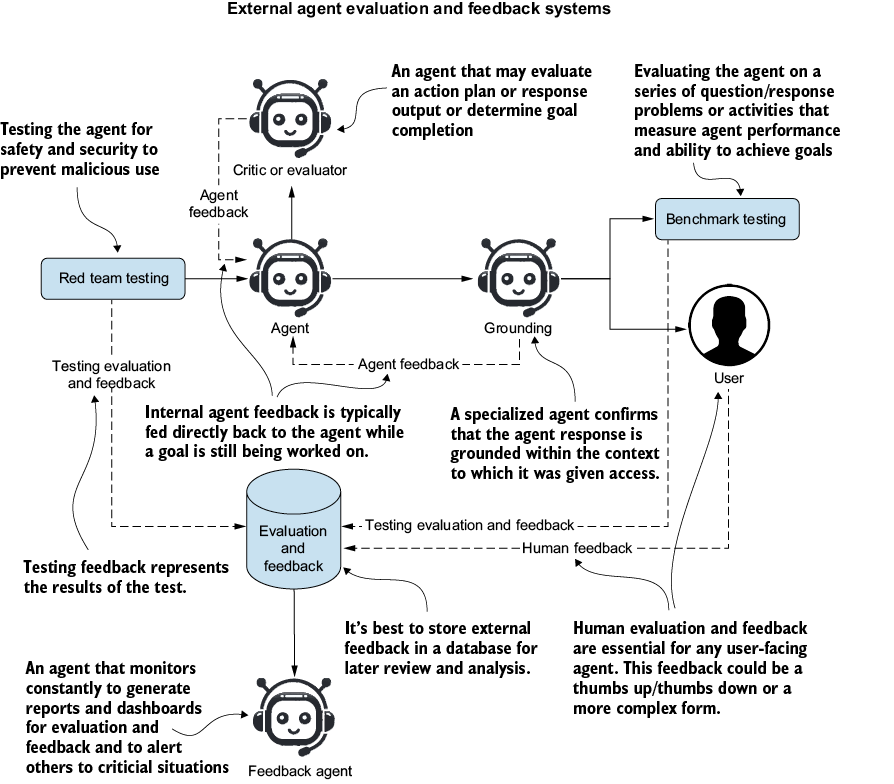
**图 7.1 面向单个用户智能体的外部评估与反馈系统。**在图中,一个生成式智能体可能会接受不同类型的评估。批评智能体(critic agent)可以针对输出质量提供通用反馈,而落地验证智能体(grounding agent)则可以针对具体上下文提供验证和评估。
每一种评估方式产生的反馈,都可以通过两条路径传递。第一种方式是直接返回智能体内部,例如通过批评智能体、落地检查机制或者其他循环中的评估器影响智能体下一步行动。第二种方式是将反馈写入评估数据库,用于保存测试结果和人工反馈,以便后续进行分析、回归问题检测以及生成训练信号。
评估本身主要有三种形式,每一种形式适用于不同类型的正确性判断。确定性测试(deterministic test)适用于结构化输出,其中正确性可以被精确验证,例如智能体是否返回了预期的数据结构、是否调用了正确的工具,或者输出是否匹配已知正确答案。LLM 和智能体评估器则用于更加模糊的自然语言判断场景,在这些场景中,正确性并不是简单的匹配关系,而是一个程度问题,例如按照评价标准进行评分、执行分类任务,或者比较两个输出的相对质量。人工评估则用于处理前两种方式无法覆盖的情况,例如边界场景、策略合规问题、语气问题以及需要现实世界判断的问题。
基于这个评估数据库,我们可以连接一个专门的反馈智能体,其职责是持续分析评估结果和反馈信息。该智能体可以生成报告、创建监控面板,或者在检测到关键问题时发送告警。虽然并非所有系统都需要采用所有形式的评估与反馈机制,但在适合的场景下,通常应该考虑以下方法。
红队测试: 红队测试用于评估特定术语、表达方式或者输入模式是否会导致系统失效。任何面向用户的智能体或者智能体系统,都应该接受某种形式的红队测试。
基准测试: 基准测试用于衡量智能体解决已知问题或者实现特定目标的能力。这类综合测试通常用于评估完整的智能体系统,但同样可以用于评估单个智能体。
人类反馈: 任何面向用户的智能体系统,都应该提供用户反馈机制,例如点赞/点踩评价、文本评论或者其他形式的反馈。人类反馈是生产环境中评估和改进真实智能体系统的基础,而不是一种额外的辅助输入。不过,原始用户反馈通常包含大量噪声,因此需要经过处理后才能用于驱动系统决策。实际应用中常见的方法包括统计聚合、异常检测(用于发现协同操作或者异常模式)、分层采样(对专家用户和普通用户反馈赋予不同权重),以及对被标记的问题输出进行后续人工审核。这些方法能够帮助系统从大量反馈中提取真正有价值的信息。
落地验证智能体: 该智能体通过落地验证机制评估 RAG 系统中的回答是否基于检索到的上下文。落地验证本身是一种通用技术,用于确认模型输出是否与可信来源保持一致,它不仅适用于 RAG,也可以用于工具调用验证、记忆验证以及引用审计。落地验证智能体只是实现这种技术的一种方式。其核心流程是:获取来源信息,获取模型输出,然后检查输出中的声明是否能够被来源信息支持。只要智能体拥有一个权威来源,就可以应用这种验证方式。
评估/批评智能体: 评估智能体或批评智能体用于为智能体内部推理过程提供额外的评价和反馈。这种智能体可以帮助完成规划阶段评估、目标完成判断以及行动结果分析。虽然这种模式可以加入任何智能体工作流,但它最常见于流程编排和多智能体协作模式中。
你可能还会遇到其他从这些方法演化而来的评估与反馈模式。不要等到智能体开发的后期才加入评估和反馈机制。正如测试推动测试驱动开发(TDD)一样,类似的方法同样应该贯穿智能体构建过程。
多智能体系统治理(Governance for multi-agent systems)
多智能体系统会引入一些单智能体系统不存在的故障模式。其中最值得关注的问题之一是智能体共谋(agent collusion):多个智能体由于共享相同假设、偏见或者训练数据,而相互强化错误答案,并且没有外部机制能够打破这种错误循环。例如,一个使用与被评估智能体相同模型的落地验证智能体,很可能会验证并认可原智能体产生的幻觉,因为两个模型共享相同的训练数据和潜在偏差。
降低智能体共谋风险的一种方法,是让评估智能体使用不同模型。被评估智能体和评估智能体最好来自不同模型提供方,因为不同模型通常具有不同的失败模式。不同训练数据和架构偏差可以帮助评估器发现原智能体无法发现的问题。如果无法使用不同模型,也可以通过不同提示词和角色设定创造差异。例如,一个被要求“寻找错误”的评估器,其行为会不同于一个被要求“确认正确性”的评估器,即使两者运行在同一个模型上。此外,还应该定期引入人工审核机制,包括审核被标记的问题输出,以及随机抽查未被标记的输出。因为一个从未通过真实结果校准的自动评估系统,可能会逐渐产生偏移,而这种偏移很难被及时发现。
除了防止共谋,多智能体治理还包含一些标准实践。首先,需要定义清晰的权限层级,明确当不同智能体或者评估器之间产生冲突时,哪个智能体拥有最终决策权。其次,需要记录所有智能体之间的通信,使系统中的争议、决策过程和最终结果能够被事后审计。最后,需要设置升级规则,当评估器无法达成一致,或者系统置信度低于阈值时,将问题交由人工处理。同时,应限制每个智能体拥有的权限范围,使其只能够执行完成自身职责所需的操作。这样可以避免单个智能体出现故障或者被攻击后,对整个系统产生连锁影响。
这些实践并不是评估智能体独有的设计原则,但它们在评估系统中尤其重要,因为评估层决定了整个系统如何判断自身是否正确。如果评估层与被评估智能体发生共谋,那么它实际上比没有评估层更加危险,因为它会创造一种虚假的安全感。因此,更可靠的设计理念是:将治理机制作为评估设计的一部分,而不是在系统完成之后再额外添加。
7.2 实现测试驱动的智能体开发
测试驱动开发(Test-Driven Development,TDD)是一种成熟的软件工程实践,其核心是在编写满足需求的实现代码之前,先编写用于表达需求的测试。严格来说,TDD 更多时候是一种理想化的方法,而不是所有团队都会完全遵循的普遍实践:许多团队会在 MVP(最小可行产品)完成之后才补充测试,尤其是在时间压力较大的情况下。因此,TDD 作为一种开发习惯,比作为一条必须遵守的规则更加有价值。但有一点始终成立:在构建系统之前先明确“什么才算正确”,通常会比先构建系统、再期望评估机制发现问题,产生更加清晰的系统。
同样的原则也适用于智能体。先定义一个优秀智能体响应应该具备什么特征,然后围绕这个定义构建智能体,比先构建智能体、再希望评估过程能够在之后发现问题更加严谨。如图 7.2 所示,这种方法被称为测试驱动智能体开发(Test-Driven Agent Development,TDAD)。
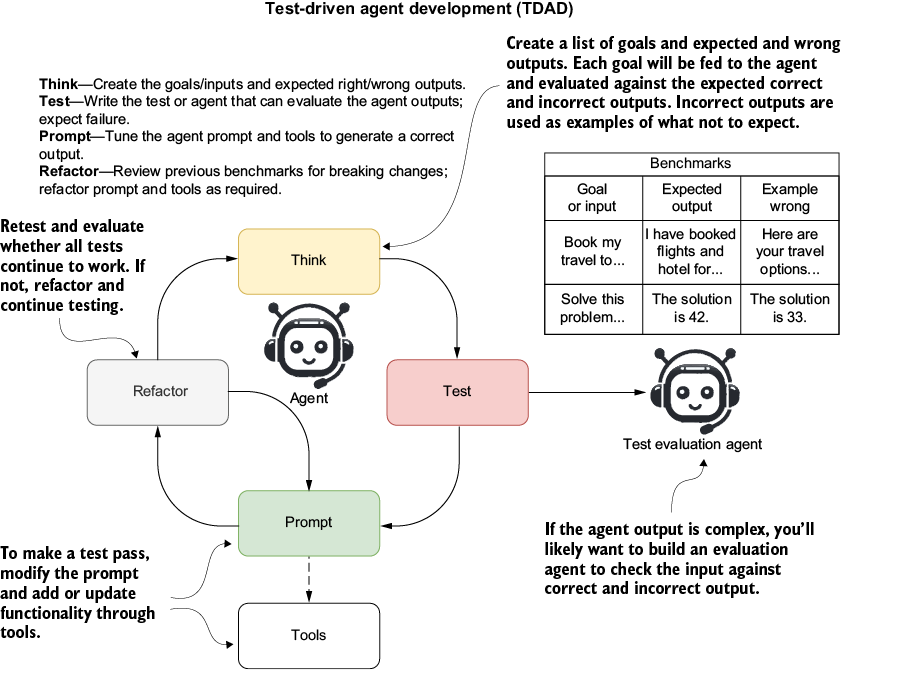
图 7.2 使用 TDAD 开发智能体的人类流程:首先确定目标和基准测试,然后进行测试、开发提示词、重构,并重复这一过程。
智能体版本中的“什么才算优秀”,通常通过评估标准而不是单元测试来表达。评估标准规定了一次响应应该满足的条件,例如事实准确性、是否基于检索到的上下文、语气是否合适以及结构是否正确,而评估流程则会根据这些标准检查智能体的输出。我们将在本章后续部分再次讨论评估标准,到那时 TDAD 与基于评估标准的评估之间的联系会变得更加具体。
该图展示了人类按照 TDAD 流程构建智能体(包括提示词和工具)的过程。这一过程从思考目标、测试、设计提示词以及重构开始。在 TDAD 中,我们首先需要建立一组目标或者输入基准,用于测试智能体表现,并为每个基准确定预期响应和已知错误响应。
智能体测试并不只是简单地比较输入和输出。完整的测试需要从整体角度观察智能体的行为,包括它选择了哪些工具、执行了哪些推理步骤、是否始终基于检索到的上下文、用了多少步骤得到答案、整个运行过程积累了多少延迟和成本,以及当某些环节失败时它表现如何。这些都属于可以测试的属性,而且即使最终输出看起来正确,其中任何一个环节仍然可能存在错误。
错误输出以及错误的中间行为示例,可以帮助评估智能体区分正确运行和错误运行。同一个智能体通过五次错误工具调用最终得到正确答案,与通过两次正确工具调用得到相同答案,这两种情况并不相同,而完整的测试应该能够发现这种差异。
接下来,我们进行测试。在测试开始阶段,我们应该预期智能体会失败。由于驱动智能体的大语言模型具有一定随机性,因此每个测试应该运行多次,以确认失败是稳定存在的问题,而不是一次偶然采样造成的结果。根据失败结果,我们需要识别能够让基准测试通过的最小更新,包括对智能体提示词和工具的调整。
“最小”这个概念值得进一步说明,因为这是许多实践者最容易犯错的地方。在实际开发中,从小到大的修改顺序通常应该是:修改一个词来调整语气或提高精确度;在已有句子中增加一个子句;在现有提示词部分增加一句话;在提示词中增加新的部分;添加或修改工具;更换模型或者调整模型参数。应该优先尝试较小的修改,只有当这些修改无法解决问题时,才逐步扩大调整范围。
采用最小修改原则可以保持提示词简洁,从而保持模型性能,并降低每次调用的延迟。臃肿的提示词通常来自这样的团队:每当出现问题时就增加一段提示词,却从不删除任何内容,最终形成数页长的系统提示词,而其中不同部分甚至可能互相矛盾。因此,这种纪律不仅意味着进行最小修改,也意味着删除那些已经不再发挥作用的内容。
接下来,我们重新测试并进行重构。我们需要重新运行所有之前已经通过的基准测试,以确认智能体仍然按照预期工作。当之前通过的基准测试因为新的修改而失败时,我们需要返回并重构提示词,通过最小化调整使所有基准测试重新通过。持续进行重构和测试,直到确认智能体能够通过所有基准测试。
通常情况下,我们希望智能体在继续开发之前通过所有基准测试。但实际上,由于为了支持其他基准测试而进行修改,导致之前测试失败的情况并不少见。这种情况很可能发生,因为不同基准测试之间可能存在冲突。例如,一个基准测试可能要求智能体进行逐步思考,而另一个基准测试可能要求智能体快速回答问题而不进行额外思考。当基准测试开始出现冲突时,可以考虑以下问题和选择:
是否所有基准测试都应该通过? 如果答案是否定的,可以将失败的基准测试作为错误输出示例使用。另一种情况是,你可能只期望智能体在已有测试中达到 90% 的通过率。例如,你可能随着时间积累了几十甚至几百个基准测试,而达到 100% 的通过率并不总是现实。
是否应该增加一个智能体? 如果当前智能体能够通过大部分基准测试,只是在少数情况下失败,那么一种选择是增加一个专门处理这些情况的智能体。但这会引入路由问题,即判断某个输入应该由哪个智能体处理,而路由器自身也可能产生错误,从而在专业化收益产生之前提高整体错误率。路由准确率本身也是一个需要评估的问题。
是否应该重构整个智能体? 增加智能体会带来更多工作,因此很多时候重新拆解并构建智能体可能更加合理。幸运的是,重建智能体通常只需要重新创建智能体的指令提示词。这一次,在重新构建智能体时,新的指令应该重点关注那些导致最多问题或者最复杂的基准测试。
注意:
LLM 内部的“混合专家”(Mixture of Experts,MoE)指的是模型内部的一种结构,它会在一次前向计算过程中将 token 路由到不同子网络中,这与多个智能体通过独立调用进行协作并不相同。多智能体版本更接近于专业化路由或者集成式系统,因此区分这些概念非常重要。专业化会增加系统复杂度、评估开销以及成本。在采用专业化之前,应首先考虑是否可以通过重构单个智能体来解决问题,例如优化提示词、改进工具或者加强落地验证。当失败任务集合真正具有明显区别时,专业化才是正确选择,而不是因为单个智能体只差一次简单修改即可通过测试。
通常情况下,你应该将 TDAD 应用于整个智能体系统,并重点关注那些承担主要工作的独立专业智能体。这样做需要具备能够在不同粒度层级应用和测试的智能体以及智能体系统基准。如果不这样做,就可能导致功能缺陷直到生产环境运行时才暴露出来。
7.2.1 在实践中探索 TDAD
下面我们通过一个实际过程了解如何使用 TDAD 创建智能体。这个过程展示了如何利用 TDAD 构建单智能体系统或者多智能体系统。图 7.3 展示了一个单智能体系统以及我们期望该智能体达到的一些初始基准。在这个例子中,我们的基准由一组针对某些虚构资料的问题组成。
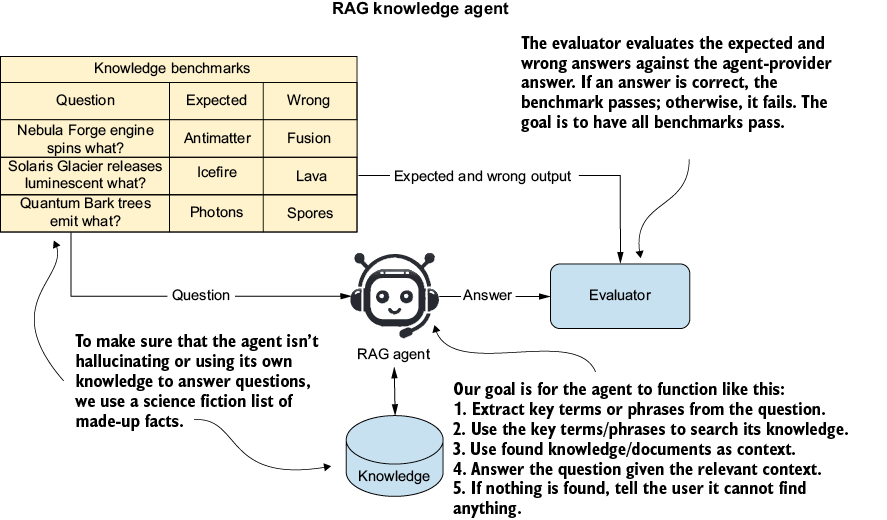
图 7.3 一个简单 RAG 知识智能体的架构。该智能体的目标是通过搜索知识库回答基准测试中的问题并返回答案。一个简单的评估 LLM 会根据基准测试中的预期答案和错误答案,对回答进行评估。RAG 智能体的准确率可以通过其正确回答基准问题的比例确定。
在图中,RAG 智能体依赖一种简单的检索架构模式。在这种模式下,智能体接收到一个关于外部知识的问题,而这些知识是它可以访问的。随后,它会将问题拆解为可搜索的关键词和短语,并使用这些词语搜索知识库。如果找到相关知识,它会将这些内容作为上下文,用于回答用户问题;如果没有找到相关知识,则说明没有找到任何内容。之后,这个答案会与基准测试对应的预期答案和错误答案候选一起传递给评估器。评估器利用这些信息判断该基准测试是否通过。
7.2.2 编写和测试 RAG Agent
现在我们已经了解了基准测试的概念,接下来应该在构建 Agent 最小可运行代码的同时,对 Agent 进行评估。在这个阶段,我们的重点是完成足够的功能,使我们能够向 Agent 提出问题。Agent 会生成回答,然后我们对这个回答进行评估。如何构建这部分代码取决于你自己。对于常规的软件组件,例如数据库连接、其他工具等部分,你可能希望采用 TDD(测试驱动开发)的方式进行开发。
代码清单 7.1 展示了如何运行 Agent,并通过基准测试表中的测试项来评估它。在当前阶段,评估方式非常简单,只是通过字符串匹配来判断答案是否符合预期。对于 Agent 本身,我们目前只定义了角色和指令,没有添加任何其他能力。记住,TDAD 的目标是:通过最少的指令和最少的工具,让 Agent 达到所有基准测试目标。
代码清单 7.1 01_RAG_agent.py
_special_knowledge_db = [ #1
"Nebula Forge engine spins antimatter rings for gravity control.",
"Solaris Glacier absorbs heat, releasing luminescent icefire at dusk.",
"Quantum Bark trees emit entangled photons guiding nocturnal insect migrations.",
"Aether Silk fabric self-weaves repairs within fourteen-millisecond microtears.",
"Chrono Coral reefs rewind water currents three minutes every solstice.",
]
# benchmarks for special knowledge
_benchmarks = [ #2
{"q": "Nebula Forge engine spins what?", "a": "antimatter", "wrong": "fusion"},
{
"q": "Solaris Glacier releases luminescent what?",
"a": "icefire",
"wrong": "lava",
},
{"q": "Quantum Bark trees emit what?", "a": "photons", "wrong": "spores"},
{"q": "Aether Silk fabric repairs what?", "a": "microtears", "wrong": "threads"},
{"q": "Chrono Coral reefs rewind what?", "a": "currents", "wrong": "tides"},
]
@function_tool #3
def search_knowledge(query: str) -> dict:
"""Search the knowledge database for relevant facts."""
matches = [doc for doc in _special_knowledge_db if query.lower() in doc.lower()]
print(f"Found {len(matches)} matches for '{query}'")
return {"status": "ok", "context": "\n".join(matches)}
agent = Agent( #4
name="RAG Agent",
instructions="""
You are a retrieval-augmented knowledge agent.
""",
tools=[search_knowledge],
)
for benchmark in _benchmarks: #5
question = benchmark["q"]
answer = benchmark["a"]
wrong_answer = benchmark["wrong"]
result = asyncio.run(Runner.run(agent, input=question)).final_output.strip()
print("" + "=" * 40)
print(f"Question: {question}")
print(f"Answer: {result}")
if result.lower() == answer.lower():
print(f"Correct -> {answer}")
else:
print(f"Incorrect -> Expected: {answer}")
if wrong_answer:
print(f"Wrong answer was: {wrong_answer}")
代码说明:
#1 这是一个虚构的知识数据库,其中存储了 Agent 可以访问的事实信息。
#2 这些是我们希望 Agent 能够通过的基准测试项目。
#3 这是提供给 Agent 的知识搜索工具,用于从知识库中检索相关信息。
#4 这是 Agent 的定义代码,包括角色设定以及提供给它的搜索工具。
#5 遍历每一个基准测试项,向 Agent 提出问题,并评估它返回的答案。
运行这段代码,你会发现 Agent 会按照预期一样,在所有测试中失败。如果 Agent 偶然通过了某个测试,不要马上认为它已经成功。在继续开发之前,需要运行更多测试,以确认答案是否具有一致性。通常情况下,对于 Agent 已经通过的测试,建议至少运行三次,以确保它的行为稳定。
注意:需要多次运行基准测试这一点,与 TDD(测试驱动开发)的方式有所不同。
在 TDD 中,一个测试通过通常就足够了。但由于 LLM 天生具有随机性,它们的输出可能存在变化,因此 Agent 开发过程中需要多次运行基准测试。
至少运行三次是一个常见建议,而在很多情况下可能需要更多次。
判断需要运行多少次的一个关键指标,是 Agent 输出结果的变化程度。如果输出波动较大,就需要增加测试迭代次数。
当然,整个评估流程都可以自动化,包括将每次运行的评估结果离线保存,以便后续分析。
7.2.3 重构 Agent
现在,我们已经拥有了一个完整运行的 Agent 系统,虽然它目前无法通过所有基准测试,但这正是我们开始重构并构建 Agent Prompt 指令的起点。我们应该首先关注一些容易修复的问题,例如修正输出格式,或者提供更明确的数据处理指导。下面这段代码就是针对这些问题进行的调整。
代码清单 7.2 02_RAG_agent.py(仅 Agent 部分)
agent = Agent(
name="RAG Agent",
instructions="""
You are a retrieval-augmented knowledge agent.
Break down the user's query into smaller parts if needed #1
to fetch relevant context for the user's query.
Always answer with a single word. #2
""",
tools=[search_knowledge],
)
代码说明:
- #1 我们提供了更清晰的指令,告诉 Agent 如果需要,可以将用户的问题拆分成更小的部分,以便获取相关上下文。
- #2 告诉 Agent 始终只使用一个单词回答。
在这个代码清单中,我们做的修改是确保 Agent 始终输出单词级别的答案,以匹配当前基准测试的格式要求。接下来,我们增加了一些关于如何拆解问题的指导,但暂时避免直接告诉 Agent 应该如何调用工具。作为一个基本原则,我们应该避免在 Prompt 中加入格式要求和工具使用细节。
Agent Prompt 设计规则
早期的 Agent 开发通常依赖显式的 Prompt,它会在提示词中列出每一个工具,并详细规定输出格式。而现代实践更多是通过 SDK 注册工具元数据,包括工具名称、描述以及参数结构。模型会利用这些元数据自行判断何时调用工具,而不需要 Prompt 再重复说明工具已经提供的信息。这种变化意味着,Prompt 不再需要重复描述工具元数据中已经包含的内容。
不过,这并不代表工具使用说明已经消失。例如,AGENTS.md 文件、系统 Prompt 中的特定章节,以及内联指导信息,仍然广泛存在,尤其是在某些工具需要特殊处理规则时,例如只有法律相关问题才能使用该工具,优先使用本地工具,而不是远程工具。变化的重点在于职责划分,而不是工具说明是否还需要存在。
输出格式遵循同样的原则。结构化输出工具允许开发者声明响应的数据结构,例如 Pydantic 模型或者 JSON Schema,然后 SDK 会根据这些声明生成对应的 Prompt 约束,并负责输出验证。动态发现机制并不是魔法。最终,这些格式要求仍然会进入 Prompt,只不过由 SDK 自动生成,而不是开发者手动编写。
因此,格式要求和工具使用说明应该尽量放在 Prompt 之外。对于格式控制,这意味着应该在 Agent 中设置输出类型,然后基于这种强类型结构构造最终结果。对于工具,则应该通过 工具描述 和 函数定义顶部的注释 提供 Agent 使用工具所需的信息。
将格式信息和工具细节从 Prompt 中分离,可以让 Agent 更容易适应新的工具或者输出格式,而无需重新修改大量提示词内容。需要注意的是,这并不是禁止使用长 Prompt。生产环境中的 Agent 经常需要复杂且详细的系统 Prompt,尤其是在需要限制行为、执行策略或者满足监管要求的场景下。事实上,大型 LLM 提供商提供的系统 Prompt 本身通常也包含数千个 Token。
任何时候修改 Agent 的指令,都可能导致 Agent 行为发生变化。变化带来的风险取决于修改内容:
- 收紧某个约束通常会产生比较容易预测的影响;
- 增加新的章节或者修改整体语气,则可能与 Prompt 中其他部分产生交互,而这些影响往往只有在评估过程中才能发现。
正确的方法并不是避免修改 Prompt,而是在将新的 Prompt 作为基准版本之前,通过基准测试验证每一次修改带来的影响。
运行重构后的 Agent,并使用基准测试进行评估,你会发现准确率大约提升到了 40%,五个问题中有两个回答正确。代码清单 7.3 展示了 Trace 输出,可以帮助我们定位失败原因。Agent 首先直接将问题发送给检索工具,而当检索返回较弱结果或者没有结果时,Agent 接受了这种情况,并将“不知道”作为答案,而没有尝试生成新的查询。
这个诊断非常重要,因为它准确告诉我们需要修复什么。检索系统本身没有问题:当查询格式正确时,它能够返回结果。但 Agent 缺少处理“当前检索结果无法回答问题”这种情况的策略。Agent 需要增加一个查询优化步骤:当检索结果不足时,应该重新组织查询,例如:
- 尝试同义词;
- 使用更宽泛的关键词;
- 将问题拆分成多个子问题。
只有在多次尝试后仍然无法找到相关信息时,才能判断知识不存在。这个修复应该放在 Agent 指令中,而不是检索系统中。增加一条规则,要求 Agent 在检索结果不足时优化查询并重新尝试,就可以补充它缺失的恢复能力。
代码清单 7.3 02_RAG_agent.py(输出)
Found 0 matches for 'Nebula Forge engine uses' #1
========================================
Question: Nebula Forge engine spins what? #2
Answer: Unknown. #3
Incorrect -> Expected: antimatter #4
Wrong answer was: fusion #5
注释:
- #1 这是用于查找文档的查询,但返回结果数量为 0。
- #2 基准测试中的问题。
- #3 Agent 返回的答案。
- #4 如果答案错误,则输出预期答案。
- #5 错误答案,后续测试会继续使用。
现在,我们有两种实现方式。第一种方式是修改工具说明,告诉 Agent 该工具只适合使用简单查询,例如 1~2 个关键词。第二种方式是修改 Agent 的 Prompt。正如前面提到的,我们应该优先修正工具使用描述,而不是直接告诉 Agent 如何调用工具。如果 Agent 在使用某个工具时遇到问题,首先应该检查工具自身的描述是否足够清晰。
代码清单 7.4 展示了更新后的函数工具定义。我们明确说明该工具适用于关键词搜索,同时重新命名工具,使它的用途更加明显。在某些情况下,例如工具来自 MCP Server,无法修改工具名称或描述,那么只能通过 Agent Prompt 提供额外的工具使用指导。
代码清单 7.4 03_RAG_agent.py(更新后的工具)
@function_tool
def search_knowledge_by_keyword(query: str) -> dict: #1
"""
Search the knowledge database for relevant facts.
param query: The single keyword query string to search for. #2
"""
… omitted
agent = Agent(
name="RAG Agent",
instructions="""
You are a retrieval-augmented knowledge agent.
Break down the user's query into smaller parts if needed
to fetch relevant context for the user's query.
Always answer with a single word.
""",
tools=[search_knowledge_by_keyword], #3
model="gpt-4o", #4
)
注释:
- #1 更新函数工具名称,使其更准确地反映工具用途。
- #2 更新工具描述,帮助 Agent 理解如何使用该工具。
- #3 将新的工具加入 Agent 的工具集合。
- #4 也可以显式指定模型,以确保行为更加稳定一致。
运行代码后,你会发现基准测试准确率提升到了大约 60%,五个问题中有三个被判定为正确。不过,在认为 Agent 失败之前,需要仔细查看评估器标记错误的问题,以及 Agent 实际返回的内容。这次运行中的两个失败实际上并不是检索问题:
- Agent 返回
"Photons.",而预期答案是"photons"; - Agent 返回
"Water currents",而预期答案是"currents"。
这两个回答实际上都是正确的,只是因为评估器采用严格相等比较,导致它们被判定为错误。
这是 Agent 开发过程中非常常见的一类评估问题。直接使用:expected == actual这种严格字符串匹配方式,对于自然语言输出通常过于脆弱。模型输出中出现以下变化是非常正常的:
- 大小写不同;
- 标点符号不同;
- 多了一些描述性文字;
- 空格格式不同。
如果评估器没有进行标准化处理,就会把正确答案错误地标记为失败。
这个问题应该通过修改评估器解决,而不是修改 Agent。例如,将判断逻辑修改为:expected.lower() == actual.lower(),就可以接受 Agent 的输出,并让基准测试恢复到 5/5 全部通过。对于生产环境中的基准测试,至少应该进行以下标准化处理:
- 转换为小写;
- 删除结尾标点;
- 去除多余空格。
而对于更加复杂的情况,例如多个不同表达方式都可能代表正确答案,则应该使用 LLM-as-Judge(让 LLM 作为评估器) 来判断答案是否合理。
如果修复评估器后得到 100% 的测试通过率,仍然应该重新运行测试,以确认 Agent 的行为具有一致性。之后,根据测试结果,你可以继续进行下一轮重构,或者认为这一轮优化已经完成。
7.2.4 使用 Agent Evaluator 扩展评估能力
上一节中的基准评估器非常简单,它只通过单词匹配来验证答案是否正确。但在真实应用场景中,我们很少会要求 Agent 只返回一个单词,Agent 的响应通常会更加复杂。为了处理更复杂的输出,我们将引入一个 Agent 来负责评估和打分基准测试结果。
代码清单 7.5 展示了如何添加一个 Agent Evaluator。这个评估 Agent 会输出强类型的通过/失败结果,并包含执行评估任务所需的指令。同时,我们也修改了原始的 RAG Agent。在原来的 Agent 中,我们移除了“只能输出一个单词”的限制,因为我们希望 Agent 能够使用更加自然的语言进行回答。对于评估 Agent,我们则要求它根据答案中是否包含关键术语来判断通过或失败。这样,我们就可以继续使用之前的基准测试,而不需要重新编写测试逻辑。
代码清单 7.5 04_RAG_agent.py(仅 Agent 部分)
agent = Agent(
name="RAG Agent",
instructions="""
You are a retrieval-augmented knowledge agent.
Break down the user's query into smaller parts if needed
to fetch relevant context for the user's query. #1
""",
tools=[search_knowledge_by_keyword],
model="gpt-4o", # Specify the model to use
)
class EvaluationOutput(BaseModel): #2
"""Output model for evaluation agent."""
is_correct: bool
feedback: str
evaluation_agent = Agent( #3
name="Evaluation Agent",
instructions="""
You are an evaluation agent.
Your task is to evaluate the answers provided by the RAG Agent.
You will compare the answer against
the expected answers key term to validate correctness.
""",
output_type=EvaluationOutput,
)
注释:
- #1 删除了之前要求 Agent 只能返回单词的指令。
- #2 添加强类型输出,用于验证测试是否通过,并提供反馈信息。
- #3 新增评估 Agent,它拥有强类型输出以及专门用于评估的指令。
接下来,我们需要修改 Agent 的评估循环,将评估 Agent 加入其中,如代码清单 7.6 所示。当 RAG Agent 回答问题后,我们会将以下信息封装到一个字典中:
- 用户提出的问题;
- Agent 返回的答案;
- 预期答案中的关键术语;
- 一个错误答案示例。
这个字典会转换成字符串,并作为输入传递给评估 Agent,用于指导它完成判断。这里使用字典而不是 JSON 等格式,是因为对于 LLM 来说,字典形式能够提供更加清晰和结构化的输入。
代码清单 7.6 04_RAG_agent.py(评估循环)
for benchmark in _benchmarks:
question = benchmark["q"]
answer = benchmark["a"]
wrong_answer = benchmark["wrong"]
result = asyncio.run(
Runner.run(agent, input=question)).final_output.strip()
evaluation_input = dict( #1
question=question,
answer=result,
expected_key_term=answer,
wrong_answer=wrong_answer,
)
print("" + "=" * 40)
evaluation = asyncio.run( #2
Runner.run(evaluation_agent, input=str(evaluation_input))
).final_output
print(f"Evaluation: {evaluation.is_correct}") #3
print(f"Feedback: {evaluation.feedback}")
print(f"Question: {question}")
print(f"Answer: {result}")
if evaluation.is_correct: #4
print(f"Correct -> {answer}")
else:
print(f"Incorrect -> Expected: {answer}")
if wrong_answer:
print(f"Wrong answer was: {wrong_answer}")
注释:
- #1 构造输入字典,并将其传递给评估 Agent。
- #2 将字典转换为字符串,作为输入运行评估 Agent。
- #3 输出评估 Agent 判断测试是否通过。
- #4 根据评估结果判断答案正确或错误,并输出对应信息。
运行代码后,你会看到 RAG Agent 不再局限于返回单词,而是可以生成完整的自然语言回答,同时由评估 Agent 对结果进行判断。这一次,你应该可以看到基准测试得分达到 80%~100%。同时,查看评估 Agent 提供的反馈信息也非常有帮助,因为它能够帮助我们理解 Agent 为什么被判定为正确或错误。不过,你可能会注意到一个问题:Agent 有时虽然回答了正确的问题,但同时会加入一些数据库中不存在的额外信息。例如,Agent 可能根据自己的语言模型知识补充一些看似合理但实际上并未从知识库中检索到的内容。为了修复这个问题,我们需要引入一个 Grounding Agent(事实依据校验 Agent),确保 Agent 的回答始终基于检索到的信息,避免生成虚构内容。
7.3 使用 Grounding、Critic 和 Evaluation Agent
在评估 Agent 输出时,我们有几种不同的选择和常见模式,包括 Grounding Agent(事实依据校验 Agent)、Critic Agent(批评 Agent) 和 Evaluation Agent(评估 Agent)。这三种模式帮助我们建立一套评估 Agent 输出的方法,并将其应用于特定的应用场景,例如知识型 RAG 系统。图 7.4 对比了这三种模式,同时展示了它们最适合的使用场景以及应该在什么时候采用。
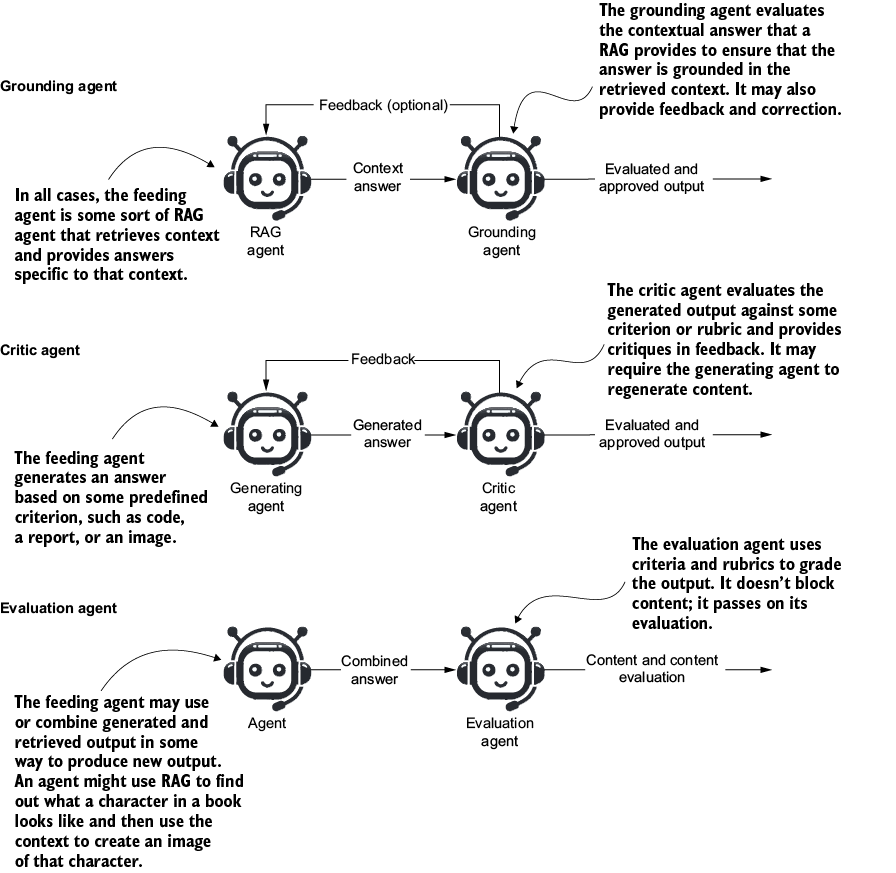
图 7.4 三种用于评估 Agent 输出的模式:Grounding、Critic 和 Evaluation。Grounding Agent 专门用于评估 RAG Agent 的输出;Critic Agent 用于审查生成内容;Evaluation Agent 用于处理更复杂的输出。
Grounding Agent 专门用于 RAG 或检索型 Agent,它的作用是确保 Agent 的输出基于生成答案时使用的上下文信息。Grounding Agent 可以提供反馈,并要求检索 Agent 重新生成答案,也可以直接阻止输出。当答案必须严格基于源材料上下文时,Grounding Agent 是非常重要的一环。
Critic Agent 则用于评估生成内容,并在内容不符合指定标准或评价规则时提供反馈。它会阻止未通过评估的内容,并要求 Agent 重新生成,同时设置重试上限,以避免无限循环。
重试上限(retry ceiling)并不是一个随意设置的经验值,而是一个真正的架构设计决策。第四次尝试失败后系统如何处理,决定了系统是能够安全失败,还是会成为隐藏错误输出的来源。常见处理方式包括:
- 返回固定的兜底响应,并向用户说明无法完成请求;
- 当输出风险超过一定阈值时,将任务升级给人工审核;
- 返回多个失败尝试中相对最好的一次结果,并附带置信度标识;
- 向调用方系统明确返回“无法生成满足要求的输出”的错误。
正确选择取决于具体场景。面向用户的系统通常需要优雅降级,因为一个安全但普通的回复通常比直接返回错误更好。内部处理流程则可以选择明确失败,因为下游系统需要知道 Agent 已经耗尽重试次数。对于高风险任务,如果 Agent 连续三次生成失败,那么继续自动返回任何结果通常都是错误的选择,此时应该升级到人工处理。
对于那些同时包含检索内容和新生成内容的复杂输出,我们通常会使用评价规则(rubrics)来帮助 Agent 在生成过程中保持一致性。通过在生成过程中提供评估反馈,可以帮助 Agent 调整输出方向。由于定位失败原因的成本可能较高,因此有时会将反馈和最终输出结合起来,让用户能够理解和评估结果,并根据实际情况进行调整。
7.3.1 了解 Grounding Agent
作为回顾,Grounding 的核心过程是确保答案能够被上下文和引用信息支持。虽然 Grounding 通常用于 RAG 知识型 Agent,但这个概念并不局限于 RAG,也可以应用于其他模式,例如 Critic Agent。图 7.5 重新展示了 RAG 知识 Agent 的架构,这一次加入了一个 Grounding Guardrail Agent(事实校验防护 Agent)。添加 Grounding Agent 后,检索得到的知识上下文需要同时传递给两个 Agent:
- RAG Agent 使用上下文生成答案;
- Grounding Agent 使用相同上下文验证答案是否有依据。
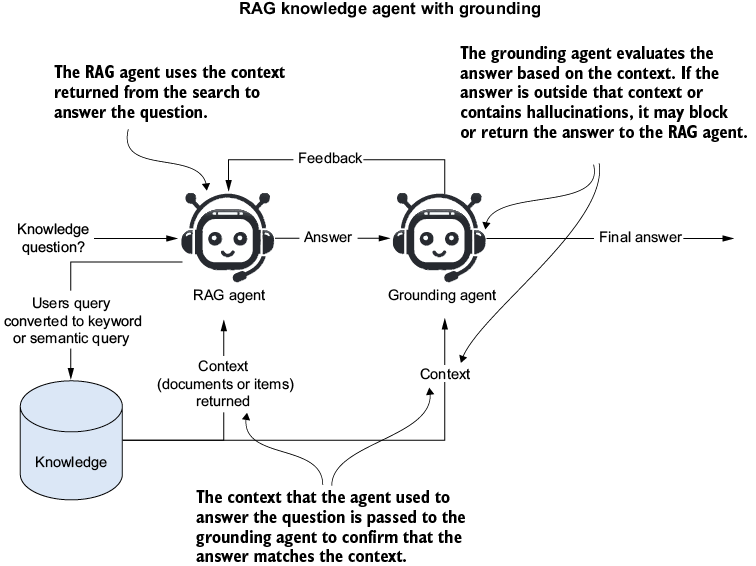
图 7.5 RAG 知识 Agent 与 Grounding Agent 结合。两个 Agent 获取相同上下文,RAG Agent 根据上下文生成答案,Grounding Agent 通过检查相同上下文验证答案是否有依据。
当答案经过 Grounding Agent 检查后,有几种处理方式:
第一种方式是将答案返回给原 Agent,并附带反馈,让 Agent 判断是否需要重新生成。这种方式本质上类似 Critic Agent。
第二种方式是直接批准或阻止答案:
如果通过验证,则输出答案;
如果失败,则返回固定回复。
第三种方式是将 Grounding 结果作为最终答案的一部分返回。
如何处理 Grounding 输出取决于具体业务场景,也可以组合多种方式。例如,可以让 Grounding Agent 连续拒绝某个答案三次,之后直接阻止输出,并返回固定提示信息。
7.3.2 为 RAG Agent 添加 Grounding 能力
代码清单 7.7 展示了我们使用的 Grounding Agent,它负责反馈答案是否基于上下文。在代码顶部,我们新增了一个工具,该工具可以让 Agent 获取最近一次回答问题时使用的上下文。随后定义了强类型的 Grounded Answer(事实依据验证结果),最后是 Grounding Agent 的定义。在设计 Grounding Agent 时,最好保持它的通用性,使其能够复用于其他知识型 Agent。
代码清单 7.7 05_RAG_grounding_agent.py(Grounding Agent)
@function_tool
def get_last_context() -> str: #1
"""
Retrieve the last context used by the grounding agent.
"""
global _last_context
if not _last_context:
return "No context available."
return _last_context
class GroundedAnswer(BaseModel): #2
"""Output model for grounding agent."""
is_answer_grounded: bool
feedback: str
grounding_agent = Agent(
name="Grounding Agent",
instructions=""" #3
You are a grounding agent.
Your task is to evaluate the correctness of the answers
based on the provided question, the context used,
and output answer.
""",
model="gpt-4o",
output_type=GroundedAnswer, #4
tools=[get_last_context], #5
)
注释:
- #1 一个工具,用于提供最近一次检索使用的上下文。
- #2 用于输出 Grounding 结果的强类型数据结构。
- #3 Grounding Agent 的指令,用于评估答案是否有充分依据。
- #4 使用强类型输出定义验证结果格式。
- #5 提供获取最近检索上下文的工具。
接下来,我们来看更新后的基准测试循环,如代码清单 7.8 所示。在这个阶段,我们仍然继续使用 Agent 基准测试作为指导,用于评估 Grounding Agent 的效果。在这个示例中,我们暂时不考虑 Agent Evaluator,但同样可以使用 TDAD 方法持续优化和改进 Grounding Agent。
代码清单 7.8 05_RAG_grounding_agent.py(基准测试循环)
for benchmark in _benchmarks: #1
question = benchmark["q"]
answer = benchmark["a"]
wrong_answer = benchmark["wrong"]
result = asyncio.run(
Runner.run(agent, input=question)
).final_output.strip()
grounding_input = dict( #2
question=question,
answer=result, #3
)
print("" + "=" * 40)
grounding = asyncio.run(
Runner.run(grounding_agent, input=str(grounding_input))
).final_output
print(f"Grounded: {grounding.is_answer_grounded}") #4
print(f"Feedback: {grounding.feedback}")
print(f"Question: {question}")
print(f"Answer: {result}")
注释:
- #1 遍历基准测试,用于快速测试 Grounding Agent。
- #2 创建字典,将问题和答案传递给 Grounding Agent。
- #3 这里没有直接传递上下文,但不要忘记,我们已经为 Grounding Agent 提供了获取最近上下文的工具。
- #4 输出 Grounding Agent 的评估结果。
对于这个简单示例,我们会将 Grounding 输出与最终结果结合,用于判断 Grounding 的有效性。运行代码后,你可以观察 Grounding Agent 如何确保 RAG Agent 仅基于提供的上下文回答问题。逐个检查每个基准测试问题的输出,可以确认 Grounding Agent 是否正常工作,以及它在防止 Agent 编造信息方面的效果。
7.3.3 将 Grounding Agent 实现为 Guardrail(防护机制)
通常情况下,当使用 Grounding Agent 时,我们希望阻止那些缺乏事实依据的输出。之后,我们可以选择让生成答案的 Agent 重新生成回答,或者直接使用固定回复阻止该答案。通过 OpenAI Agents SDK,我们可以很容易地添加一个 Grounding Agent,让它作为 Guardrail(防护机制)来实现这两种模式。
代码清单 7.9 展示了输出 Grounding Guardrail 以及更新后的 RAG Agent。在这段代码中,Grounding Agent 被嵌入到了 Guardrail 函数中。如果 Grounding 检查失败,则会将 tripwire_triggered 属性设置为 true,从而触发异常。
代码清单 7.9 06_RAG_grounding_guardrail_agent.py(Guardrail)
@output_guardrail #1
async def ground_answer(
context: RunContextWrapper, agent: Agent, output: AnswerResult
) -> GuardrailFunctionOutput:
grounding_input = dict(
question=output.question,
answer=output.answer,
)
result = await Runner.run( #2
grounding_agent, input=str(grounding_input))
result = result.final_output
return GuardrailFunctionOutput( #3
output_info={
"answer_is_grounded": result.is_answer_grounded,
"feedback": result.feedback,
},
tripwire_triggered=result.is_answer_grounded is False, #4
)
agent = Agent(
name="RAG Agent",
instructions="""
You are a retrieval-augmented knowledge agent.
Break down the user's query into smaller parts if needed
to fetch relevant context for the user's query.
""",
output_type=AnswerResult,
tools=[search_knowledge_by_keyword],
model="gpt-4o", # Specify the model to use
output_guardrails=[ground_answer], #5
)
注释:
- #1 使用 Guardrail 装饰器,将一个函数转换为 Guardrail。
- #2 在 Guardrail 内部运行 Grounding Agent。
- #3 输出 Grounding 检查结果。
- #4 如果 Grounding 失败,则触发 Guardrail 的 tripwire。
- #5 将 Guardrail 添加到 Agent 中,用于监控输出结果。
接下来,代码清单 7.10 展示了运行 Agent 并监听 Guardrail 异常的主函数。我们在 try/except 代码块中调用 RAG Agent 来回答问题。由于 Agent 配置了输出 Guardrail,因此我们需要检查是否触发异常,因为异常表示 Guardrail 检查失败。在这个示例中,当答案没有基于上下文生成时,Guardrail 就会被触发。
代码清单 7.10 06_RAG_grounding_with_guardrails.py(主函数循环)
async def main():
for benchmark in _benchmarks:
question = benchmark["q"]
try:
result = await Runner.run(agent, input=question)
result = result.final_output
answer = result.answer.strip() #1
except OutputGuardrailTripwireTriggered as e:
print(
f"Guardrail tripped. Info: {e.guardrail_result.output.output_info}"
)
answer = "No grounded answer available." #2
print("" + "=" * 40)
print(f"Question: {question}")
print(f"Answer: {answer}")
注释:
- #1 从答案结果对象中获取最终答案。
- #2 如果 Grounding 检查失败,则返回固定回复。
当 Guardrail 被触发时,我们返回一个固定响应。不过,我们也可以让 RAG Agent 根据 Grounding Agent 提供的反馈重新尝试生成答案。无论采用哪种方式,现在我们已经拥有了一个 RAG Agent,它会持续检查自己的回答,确保输出始终基于 Agent 可以访问的知识上下文。如果你的应用场景要求绝对避免提供无效、错误或者潜在危险的信息,这种机制会非常关键。
7.3.4 理解 Rubric 在评估中的作用
评估策略取决于智能体生成的内容类型。对于生成结构化输出且存在明确目标的智能体(例如分类标签、字段提取结果或优化决策),可以使用传统指标进行评估,例如准确率(accuracy)、精确率(precision)、召回率(recall)和 F1 分数。在这些场景下,“对还是错”有着明确的答案,因此标准的机器学习评估工具可以直接应用。
对于生成开放式自然语言输出的智能体(例如摘要、解释、计划或创意内容),则需要采用不同的方法。当多种表达方式都可能是正确答案,且质量又是多维度时,“准确率”往往很难定义。这也是为什么评估会更多依赖评分量表(rubrics)、LLM-as-judge(由 LLM 担任评审)以及人工审核,而不是单纯依赖数值指标。大多数生产级智能体实际上同时包含这两类输出:结构化部分使用数值指标评估,自然语言部分则通过评分量表或评审机制进行评价。
为智能体输出的每个组成部分选择合适的评估方法,本身就是设计工作的一部分。如果在准确率已经足够的情况下默认使用评分量表,会引入不必要的评估复杂度;反之,如果在需要评分量表的场景下仍然使用准确率,则会得到脆弱且片面的指标,无法反映真正重要的内容。
在教育领域,评分量表(rubric)用于定义学生获得某个成绩所需满足的结构化标准和评价维度。同样的理念也适用于智能体输出的评估,但有一个重要的补充:评分量表本身必须经过人工判断的验证,否则它虽然能够始终如一地打分,却可能始终如一地给出错误的评分。
我们可以按照以下步骤来定义一个用于评估输出表现的评分量表:
1. 明确目的和目标:确定希望输出达到什么目标。例如:
- 是否希望评估针对特定用户群体的推荐质量?
- 是否希望评估某个主题、格式或者输入条件下的整体质量?
2. 定义评价标准:建立一组用于评估输出的标准或维度。这些标准应该与目标保持一致,并提供清晰的评价依据。每个标准都应该具体且可衡量。例如,对于一个推荐结果,可以评估:
- 是否符合目标领域;
- 是否符合主题要求;
- 是否符合指定格式。
3. 创建评分等级:为每个评价标准建立评分体系。常见方式包括:
- 数值评分,例如 1~5 分;
- 描述性等级,例如优秀、良好、一般、较差。
4. 提供等级描述:为每个评分等级提供清晰、简洁的说明。说明什么样的表现属于优秀,以及什么情况下属于较弱表现。
5. 应用 Rubric:评估 Prompt 或 Agent Persona 时,根据已经定义好的标准进行评分。根据每个等级的描述,为每个评价维度分配分数。
6. 计算总分: 根据 Rubric 设计方式,可以:
- 将所有评分直接相加;
- 对不同维度进行加权平均。
如果某些标准更加重要,则应该给予更高权重。
7. 确保评估一致性:如果多个评估者参与评分,需要确保他们使用一致的标准。
8. 回顾、修改并迭代:定期检查和优化 Rubric,确保它持续符合评估目标。根据实际效果不断调整,提高评估有效性。
Rubric 评估是一种可以应用于内容批评和输出评价的方法。它定义了一个回答如何满足特定标准和要求。你也可以将它理解为输出结果应该达到的最低质量基线。
在使用 Grounding 和评估系统时,还需要考虑几个重要因素:
Rubric(评价标准)
Rubric 的设计和评估过程需要让响应与标准、目标以及上下文保持一致。这通常是一个复杂过程,可能需要多轮迭代,才能找到适合具体场景的最佳评价标准。Evaluation(评估)
评估过程需要判断响应是否满足 Rubric 标准、是否围绕主题展开,以及是否遵守相关指令。评估 LLM 的方式很多,包括让 LLM 充当评审者、使用确定性代码,或者引入人工审核。Scoring(评分)
评估器需要根据 Rubric 衡量准确性、相关性以及是否符合标准。在构建 Rubric 评估系统时,应记录并跟踪评分结果,以便后续分析和改进。Logging(日志记录)
日志系统需要记录 Agent 以及评估器产生的所有输入、输出和中间步骤,从而形成可以后续查询、分析和重放的完整链路。如果没有日志,Agent 失败最终只会表现为用户投诉,而无法还原问题发生的过程。有了日志,同样的问题就会变成一个可以调试的 Trace。同时,日志不仅需要覆盖生成最终回答的 Agent,也需要覆盖评估 Agent。因为一个错误通过坏输出,或者错误拒绝好输出的评估器,本身也是一种隐藏错误来源,而日志是发现这种问题的重要手段。
一个经过良好评估的回答,应该在给定上下文和目标下满足所有 Rubric 标准。而失败的回答,则无法满足关键标准,或者完全偏离了上下文和目标。
7.3.5 构建基于 Rubric 的 Critic Agent
由于 Rubric(评价标准)的概念可能仍然比较抽象,我们来看一个如何将其应用到图像生成场景中的例子。在这个示例中,我们希望确保生成图像时遵循指定的风格规范。代码清单 7.11 展示了基础的图像生成 Agent,之后我们会通过添加 Critic Agent(批评 Agent)来增强它。
这段代码创建了一个 Agent,它使用 Agents SDK 中的 ImageGenerationTool,根据指定的一组风格规范生成图像。Agent 接收一个图像描述,然后内部调用图像生成工具完成图片生成。为了获取生成的图片,我们需要遍历响应中的各个项目,查找工具调用(tool call),然后从工具调用结果中提取图片数据。
代码清单 7.11 07_image_generation_agent.py(图像生成 Agent)
agent = Agent(
name="Image generator",
instructions="""
--- image style guidelines --- #1
""",
model="gpt-5-mini",
tools=[
ImageGenerationTool( #2
tool_config={
"type": "image_generation",
"quality": "high",
"model": "gpt-image-1",
"size": "1536x1024",
}
)
],
)
image_description = "an agent generating an image"
image_name = "agent_image_generation"
with trace("Image generation"):
result = await Runner.run(agent, image_description) #3
print(result.final_output)
for item in result.new_items: #4
if (
item.type == "tool_call_item"
and item.raw_item.type == "image_generation_call"
and (img_result := item.raw_item.result)
):
os.makedirs("gen_images", exist_ok=True)
image_path = os.path.join("gen_images", f"{image_name}.png")
with open(image_path, "wb") as img_file:
img_file.write(base64.b64decode(img_result))
open_file(image_path) #5
注释:
- #1 生成图片所需遵循的风格规范(此处省略具体内容)。
- #2 使用 Agents SDK 提供的工具生成图片。
- #3 运行 Agent,并传入图片描述。
- #4 遍历输出结果,查找工具调用并提取生成图片。
- #5 保存生成图片,并进行展示。
Critic Agent 是一种专门的评估 Agent,它会根据完整的 Rubric(包括评价标准和评分等级)对输出结果进行评分。我们可以基于这个例子构建一个 Critic Agent,让它根据风格规范 Rubric 对生成的图片进行评估。Critic Agent 会判断图片对于指定风格的符合程度,然后根据评价规则和设定的分数标准决定图片是否通过。
为什么 Rubric 很重要
如果只让 LLM 评估器返回一个简单的通过/失败结果,我们几乎无法知道为什么某个输出通过或者失败。而 Rubric 中定义的评价标准,可以提供更加详细的反馈,让我们知道哪些地方做得好,哪些地方需要改进。这也是我们能够修正问题,同时保留优秀部分的关键。当然,Rubric 的能力取决于其中包含的评价标准。
针对 Agent 输出,有价值的评价标准不应该只关注表面质量,还应该关注 Agent 的行为:
- 幻觉率(hallucination rate):生成的信息是否有来源支持;
- 推理质量(reasoning quality):中间推理步骤是否符合逻辑;
- 工具使用正确性(tool usage correctness):是否选择了正确工具,是否使用正确参数,是否正确理解工具返回结果;
- 错误处理能力(error handling):Agent 是否能够从失败中恢复,还是会进一步放大错误。
这些行为层面的评价标准,需要与之前提到的表面质量指标结合:
- 准确性;
- 基于事实依据;
- 结构正确性;
- 语气;
- 完整性。
Rubric 的质量,取决于你选择包含哪些评价标准。
在查看代码之前,我们再次回顾一下如何构建一个用于评估输出的 Rubric。下面是针对图像生成示例定义 Rubric 的八个步骤:
1. 明确目的和目标:确定希望评估的目标。例如,我们的图像生成 Agent 的目标,是根据严格的风格规范生成图片。
2. 定义评价标准:建立用于评估输出的标准。为了简单起见,我们评估生成图片是否符合以下之前用于生成图片的风格规范:
所有图片的风格规范:
- 一致性(Consistency):每张图片都应该保持相同的摄影质量,并且 3D 渲染元素能够自然融合。
- 颜色方案(Color Palette):使用统一的蓝色、紫色、暖金色和绿色配色,并加入明亮的点缀色。
- 光照(Lighting):采用专业摄影级光照效果,具有戏剧性但温暖的色调。
- 信息图元素(Infographics):使用半透明全息投影,但不能喧宾夺主影响主体。
- 角色(Characters):AI 机器人应该可爱、容易接近,并且彼此具有明显差异,同时保持家族化特征。
- 图标(Icons):使用普遍认可的符号,例如灯泡代表想法、齿轮代表处理、爱心代表协调等。
- 氛围(Mood):整体应该积极、具有教育意义,并带有轻微未来感,而不是冰冷或令人畏惧。
3. 创建评分标准:为了保持简单,我们使用 1~5 分评分: 1 分表示较差,5 分表示优秀。
4. 提供评分描述:评分标准如下,对图片按照 1~5 分进行评分:
- 差(Poor):图片完全不符合风格规范。
- 一般(Fair):图片符合部分风格规范,但存在明显问题。
- 良好(Good):图片满足大部分风格规范,仅存在少量问题。
- 非常好(Very Good):图片满足全部风格规范,仅存在少数轻微问题。
- 优秀(Excellent):图片完全符合所有风格规范。
如果图片评分达到 2 分或以上,则通过;否则失败。
5. 应用 Rubric:定义好 Rubric 后,可以先人工使用它评估生成图片,这是一个非常好的实践。
6. 计算总分:对于当前 Rubric,我们直接计算所有标准的综合评分。当然,也可以分别评估每个维度,然后计算综合得分或平均分。
7. 确保评估一致性:让 LLM 先评分,再根据评分结果判断通过或失败,比直接让 LLM 输出通过/失败更加稳定。
8. 回顾、修改并迭代:持续检查、比较并优化Agent、Rubric和评估过程。
现在,这个基础 Rubric 可以用于评估我们的图像生成 Agent。我们会创建一个 Critic Agent,让它根据 Rubric 对图片进行评分,然后根据评分结果判断图片是否通过。按照前面的规则,评分达到 2 分(满分 5 分)即可通过。
代码清单 7.12 08_image_vision_critic_agents.py(Critic Agent)
class CritqueImage(BaseModel): #1
"""Result of critiquing image."""
image_pass: bool
feedback: str
critic = Agent(
name="Image Critic",
instructions=f"""
You are an image critic.
Your task is to evaluate the quality of generated images
based on the provided specific criteria and style guidelines.
{style_guidelines} #2
{rubric} #3
""",
model="gpt-5-mini",
tools=[describe_image], #4
output_type=CritqueImage, #5
)
# critic loop
while failing := True: #6
input = dict(
description=image_description,
feedback=feedback, #7
)
result = await Runner.run(agent, str(input))
# code to save the image omitted
critique_result = await Runner.run(
critic,
f"Please critique the image at {image_path} with the prompt: {image_description}",
)
critique = critique_result.final_output
failing = critique.image_pass is False #6
feedback = critique.feedback #7
注释:
- #1 创建强类型输出,用于返回反馈信息以及通过/失败结果。
- #2 添加生成图片时使用的相同风格规范。
- #3 添加 Rubric 评分规则和标准。
- #4 使用一个工具(此处省略),通过视觉模型提取图片描述。
- #5 创建强类型输出,用于返回反馈和通过/失败结果。
- #6 只要输出失败,就持续循环。Critic 的结果决定通过或失败。
- #7 获取 Critic 的反馈,并将其传回生成 Agent。
根据我们之前定义的评分量表(rubric),我们要求得分达到 5 分中的 2 分及以上才算通过。这里故意设置了一个较低的门槛,用于演示目的:批判智能体(critic)能够较容易地通过大多数图像评估,从而使循环能够在合理时间内完成。如果将阈值提高到 3 分或 4 分,批判智能体会拒绝大多数图像,导致循环可能无限执行,或者触发其最大重试次数限制。
在生产环境中,这个阈值是一个具有实际影响的关键设计决策。阈值设置得过低,会让不符合质量标准的输出直接交付给用户;阈值设置得过高,则会导致大部分输出无法通过评估,进而消耗重试预算、将大量任务升级给人工处理,或者让系统长期无法生成可接受的结果。正确的阈值取决于具体应用场景中“假阳性”(错误地通过低质量输出)与“假阴性”(错误地拒绝可接受输出)的成本权衡。
校准阈值是前面所讨论的评分量表验证工作的重要组成部分。具体做法是:根据评分量表对一批样本输出进行评分,同时让人工标注哪些结果应该通过、哪些应该失败,然后选择一个使评分结果与人工判断一致性最高的分数作为阈值。当评分量表、智能体或底层模型发生变化时,都应重新验证这一阈值。
我们在这里构建批判智能体所采用的相同原则,也可以应用于其他输出形式丰富且变化较大的场景。即便输出存在高度多样性,我们依然可以设计评分量表,让批判智能体能够评估图像、报告、图表以及其他复杂类型的输出。
7.4 使用 Phoenix 进行评估和反馈
默认的 OpenAI Dashboard Traces 页面虽然很有帮助,但随着 Agent 开发和系统逐渐成熟,你会需要更多功能。Arize Phoenix 是一个非常优秀的开源平台,可以通过云端访问,也可以使用 Docker 容器在本地运行。你还可以自行托管 Phoenix 服务,为其他用户提供访问能力,管理项目,并跟踪:
- Token 使用量和成本;
- 工具调用情况;
- 延迟;
- 用户会话;
- 各类指标;
- Agent 运行情况。
当然,它也可以帮助你诊断 Agent 流程中的复杂问题。如果没有基于 Trace 级别的可观测性,在大规模场景下几乎不可能调试或者改进复杂的 Agent 工作流。
除此之外,Phoenix 还提供了跟踪和评估 Agent Prompt、模型以及其他影响因素的机制。它同时支持快速连接大多数 Agent 平台,包括 OpenAI Agents SDK。图 7.6 展示了 Arize Phoenix 的整体功能,包括它可以执行的:
- Trace(追踪);
- Tracking(跟踪);
- Evaluation(评估)。
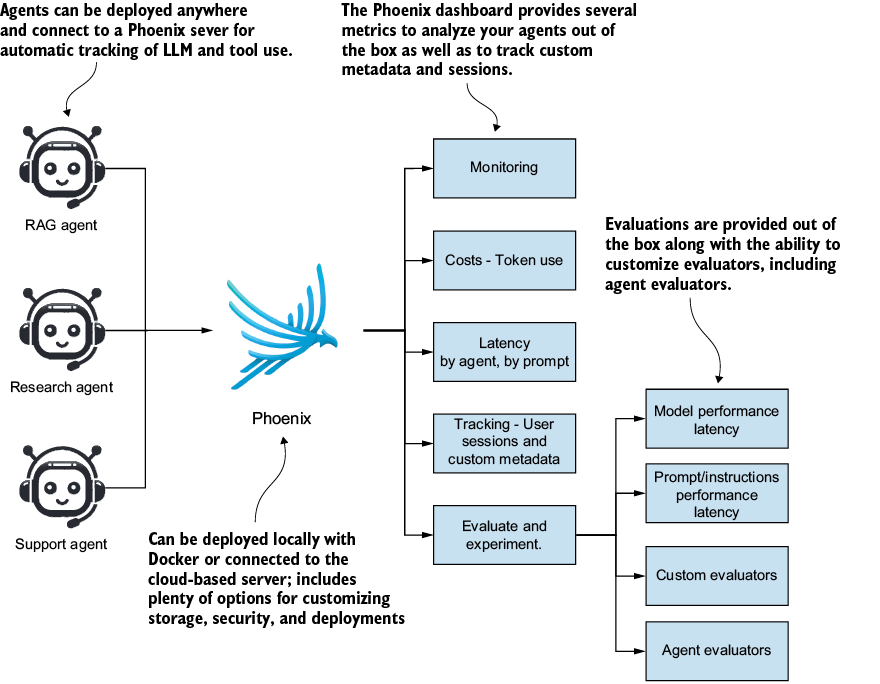
图 7.6 Arize Phoenix 的部署模式,以及用于 Agent 追踪、跟踪和评估的应用场景
Phoenix 可以追踪和记录所有 Agent 的使用情况,同时捕获 Agent 的运行活动。在捕获运行数据之后,你可以快速创建实验和评估器:基于元数据、基于标注或根据具体业务需求进行定制。如果你是一名认真进行 Agent 工程开发的工程师,非常推荐将 Phoenix 纳入你的Trace 工具链、评估工具链和开发工具链。
可观测性替代方案
Phoenix 是生产环境 Agent 可观测性的众多方案之一,在选择方案之前,了解整个生态非常重要。Langfuse 是最接近的直接替代方案:开源、功能类似、支持自托管。LangSmith 是目前较成熟的商业化方案,尤其适合使用 LangChain 或 LangGraph 的团队。Weights and Biases Weave 则是在更广泛的 W&B 机器学习平台基础上提供 Trace 能力。对于更轻量的方案,可以使用:
- OpenTelemetry;
- 支持 OTLP 的后端,例如:
- Honeycomb;
- Datadog;
- Grafana Tempo。
本章选择 Phoenix,是因为它开源、支持自托管、对本章介绍的 Agent 模式提供完整支持。不过,本章介绍的这些模式同样适用于其他替代方案。
7.4.1 连接 Phoenix
Phoenix 使用底层的 OpenTelemetry Trace 机制,而 OpenAI Agents 和其他 Agent 平台默认也使用这一机制。因此,连接 Phoenix 通常比较快速,不过并不总是一帆风顺。实际过程中,你可能会遇到:
- 文档说明不完善;
- Python 包冲突;
- 版本兼容问题。
幸运的是,GPT-5 或其他顶级模型通常可以帮助解决这些问题。
代码清单 7.13 展示了连接 Phoenix 并开始 Trace 的基础代码。在这段代码中,我们首先通过设置 set_trace_processors 为空列表,清除 OpenAI 默认的 Trace Processor。然后添加 Phoenix Trace Provider,并通过 Agent 的 Trace 函数追踪 Agent。同时,我们设置需要跟踪的 Agent 或 Agent 工作流名称。
代码清单 7.13 09_arize_phoenix_tracing.py(基础配置)
# docker run -it --rm -p 6006:6006 -p 4317:4317 arizephoenix/phoenix:latest
os.environ["PHOENIX_COLLECTOR_ENDPOINT"] = "http://localhost:6006" #1
set_trace_processors([]) #2
tracer_provider = register(
project_name="agents", #3
auto_instrument=True, #4
)
agent = Agent(
name="Assistant",
instructions="You are a helpful assistant"
)
async def main():
with trace("Haiku Generator"): #5
result = await Runner.run(
agent,
"Write a haiku about recursion in programming."
)
print(result.final_output)
注释:
- #1 设置接收 Trace 数据的 Collector 地址。
- #2 清除默认 Trace Processor,并替换为 Phoenix Trace Processor。
- #3 设置项目名称,Trace 数据会发送到 Phoenix 对应项目中。
- #4 根据已经安装的依赖自动插桩应用。
- #5 使用 OpenAI Trace 标记需要跟踪的 Agent 或 Agent 集合。
你可以在 trace 函数内部放置一个或多个 Agent。这样就可以追踪单个 Agent 或多 Agent 工作流。代码顶部被注释掉的命令,是启动 Phoenix 本地 Docker 容器的方法。
要运行它,你首先需要安装 Docker Desktop。下载并按照 Docker 官方安装说明完成 Desktop 安装即可。当 Phoenix 已经通过 Docker 启动,并且代码清单 7.13 已经完成后,打开浏览器访问:http://localhost:6006,然后点击 Agents 项目。你应该可以看到图 7.7 所示的 Dashboard 页面。如果 Agents 项目没有立即显示,刷新浏览器,页面应该就会正常出现了。
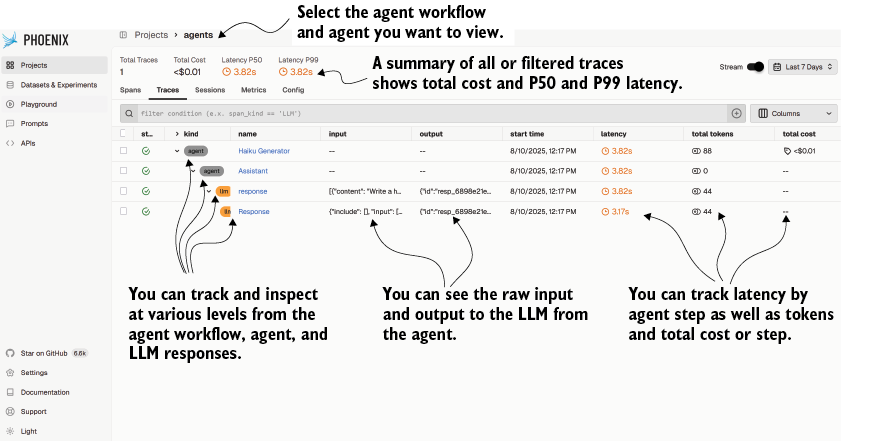
图 7.7 Arize Phoenix 项目 Dashboard,展示 Agent 工作流、Agent 和 LLM 活动
在 Projects 页面中,你可以选择查看 Traces(追踪)、Sessions(会话)、Metrics(指标)以及 Config(配置)。在 Traces 页面中,你可以深入查看智能体工作流、具体智能体以及 LLM 的响应,从而了解延迟(latency)、Token 使用情况,以及发送给 LLM 的原始请求和响应内容。在下一节中,我们将看到如何通过添加元数据(metadata)和会话追踪(session tracking)进一步增强这一视图。
7.4.2 添加元数据和会话跟踪
代码清单 7.14 展示了如何向 Agent 或 Agent 工作流中添加元数据(metadata)和会话跟踪(session tracking)。在这里,我们会向 Agent 和 LLM Trace 中添加元数据,同时跟踪一个 Session。我们通过 with 代码块添加 using_session 和 using_metadata,这样它们会自动附加到所有内部 Trace 上。需要注意的是,Agent Trace 代码块应该始终放置在其他 Trace 上下文内部。
代码清单 7.14 10_arize_phoenix_metadata.py(相关代码)
model = "gpt-5-mini" #1
agent = Agent(
name="Assistant",
instructions="Always answer in a Haiku",
model=model
)
async def main():
agent_input = dict(
question="why is the sky blue?"
) #2
metadata = dict( #3
run_id="abc123",
env="dev",
customer_tier="pro",
model=model
)
with (
using_session("sess-42"), #4
using_metadata(metadata), #4
):
with trace("Haiku Generator"): #5
result = await Runner.run(
agent,
str(agent_input)
)
print(result.final_output)
注释:
- #1 定义 Agent 使用的模型。
- #2 将输入封装为字典,以获得更好的输入格式。
- #3 定义一个字典,用于保存元数据的键值对。
- #4 使用 Session 和 Metadata Trace 上下文包装代码。
- #5 Agent 工作流 Trace 始终应该放在其他 Trace 对象内部。
运行代码清单 7.14,然后打开 Phoenix 中的 Agents 项目,你应该会看到类似图 7.8 的界面。如果想查看 Metadata 列:
- 打开右上角的 Columns(列)选择器;
- 选择 Metadata 列;
- 根据需要开启或关闭其他列。
当 Metadata 列显示后,你可以点击它展开筛选器,从而快速过滤 Trace。
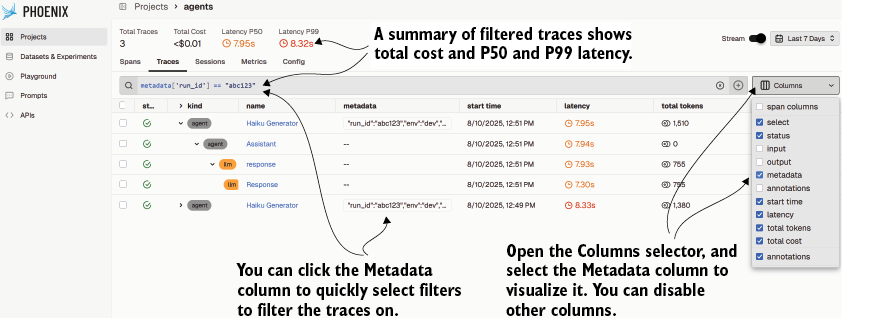
图 7.8 查看 Metadata 列,并根据属性过滤 Trace
选择 Metadata 列后,会打开一个筛选器。你可以根据字段值或者表达式,对任意字段进行过滤。这对于评估特定 Agent 行为非常有用。不过,它也要求你根据 Agent 的具体使用场景,合理配置 Metadata。
7.4.3 使用评估器进行实验
实验和评估是 Phoenix 中非常强大的功能,并且可以直接从 Dashboard 快速创建和运行。这实际上对应了 TDAD(Test-Driven Agent Development,测试驱动 Agent 开发)的“外循环”。在这个过程中,我们:
- 将真实运行产生的 Trace 转换为数据集;
- 对这些数据运行评估器;
- 根据评估结果反馈调整:
- Prompt;
- 工具;
- 策略。
在开始评估之前,我们需要创建一个由 Span(LLM 响应)组成的数据集。
图 7.9 展示了如何选择并添加 Span 到数据集中。
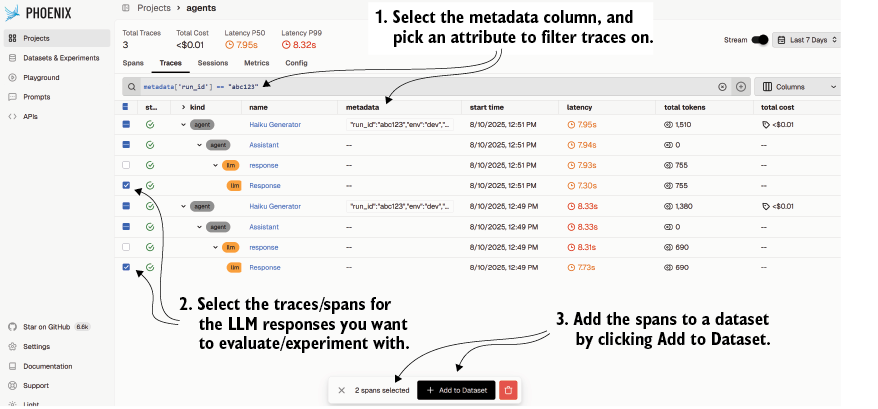
图 7.9 将 Span 添加到数据集中,用于后续实验和评估的流程
选择 Span,然后点击 Add to Dataset 后,系统会提示你创建一个新的 Dataset。使用默认名称,然后点击 Create Dataset。数据集创建完成后,右下角会出现绿色提示窗口。点击 View Dataset,你会看到类似图 7.10 所示的页面。
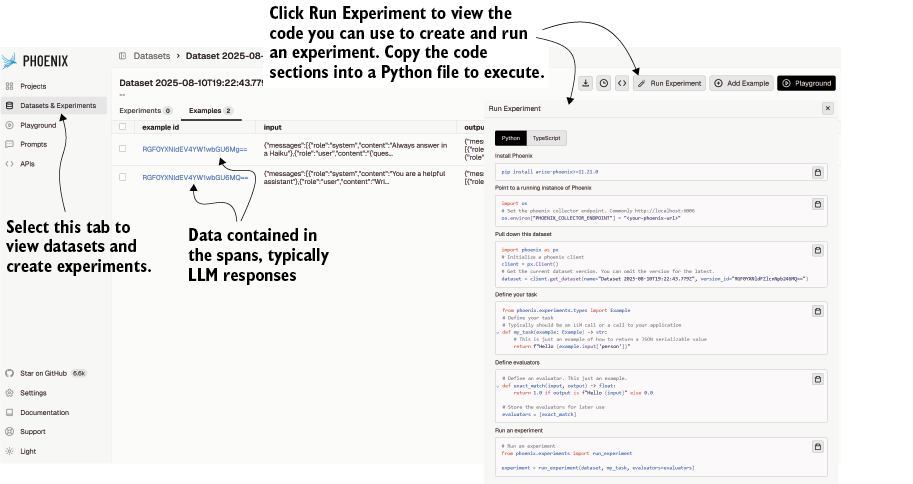
图 7.10 查看数据集,并点击 Run Experiment 查看生成代码。你可以复制代码到 Python 文件中,用于创建实验或执行评估。
点击右上角的 Run Experiment 按钮,会显示需要复制到 Python 文件中的代码。然后执行这些代码即可运行实验。这些代码提供了一个简单示例:
- 定义一个基础任务;
- 定义一个评估器;
- 对数据集中所有 Span 执行评估。
通常情况下,你会主要评估 LLM 响应。不过,你也可以评估:
- 工具调用(tool calls);
- Agent handoff;
- 其他自定义 Span。
7.4.4 使用 Annotation 提供反馈
Phoenix 还提供了一种强大的机制,用于通过 Annotation(标注)跟踪反馈。这些反馈可以后续通过代码添加,或直接通过 Phoenix Dashboard 进行记录。不过,在使用这个功能之前,我们需要先创建一组 Annotation,如图 7.11 所示。
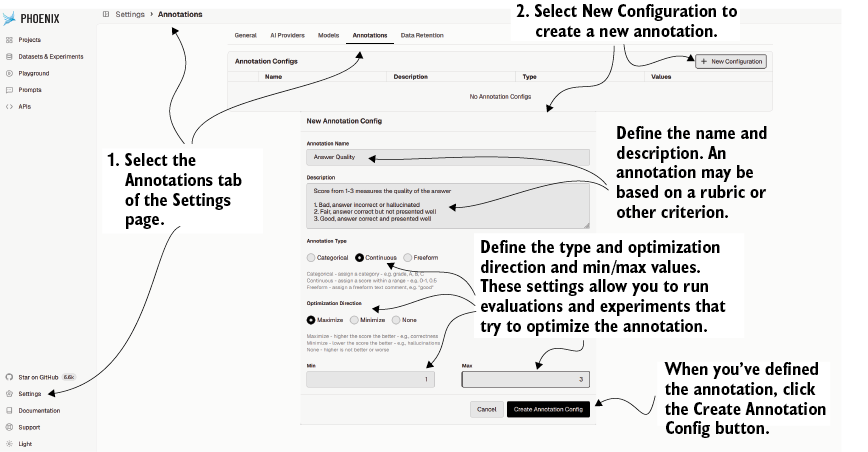
图 7.11 在 Phoenix 中创建新的 Annotation
创建 Annotation 后,我们可以返回 Traces 页面,然后选择需要标记的 Span。大多数情况下,你会希望将 Annotation 添加到记录 LLM 响应的 Span 上。图 7.12 展示了如何给包含 LLM 响应的 Span 添加 Annotation。
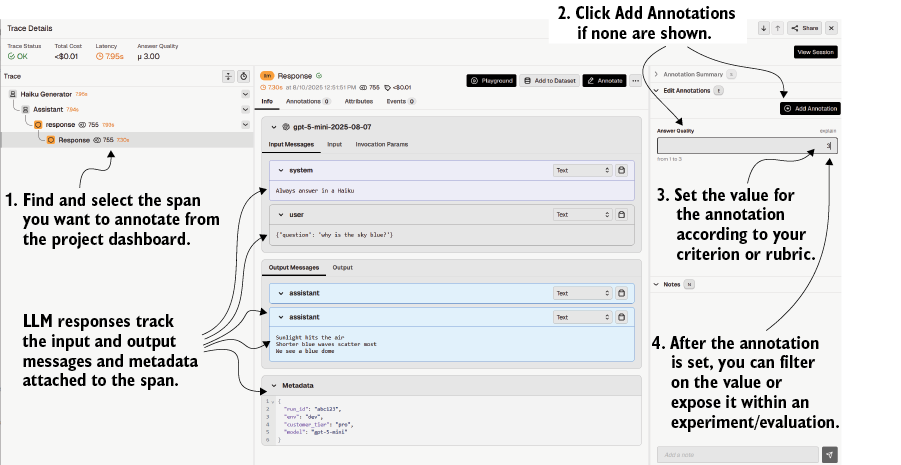
图 7.12 在 Agent 工作流中的 LLM 响应 Span 上添加 Annotation 的步骤
Annotation 允许内部审核人员:
- 开发人员;
- QA 工程师;
- 领域专家;
为特定 Span 或 Trace 添加结构化标签。例如:
- “错误选择工具”
- “优秀回答”
- “需要人工审核”
- 或任何符合评估需求的自定义标签。
这些 Annotation 会与 Trace 数据一起保存,并且之后可以作为可查询信号使用。
Annotation 的价值在于,它可以将临时性的人工判断转化为结构化数据。例如开发人员发现 Agent 选择了错误工具,可以标记对应 Span。之后,你可以:
- 查询所有带有该标签的 Span;
- 与未标记 Span 进行比较;
- 分析其中的规律。
例如:
- 是否发生在较长 Prompt 中?
- 是否只发生在某些工具上?
- 是否与某类用户请求相关?
通过 Annotation 过滤 Trace Dashboard,你还可以将质量标签与运行指标关联起来,例如延迟、成本或Token 使用量。这样可以分析错误回答是否与某些成本或性能模式相关。
这也是让非正式评审逐渐转变为数据集的方法。例如,多个 Session 中被标记为 “incorrect(错误)” 的 Span,可以逐渐形成一个回归测试集。之后:
- 修改 Prompt;
- 重新运行 Agent;
- 使用这些历史失败案例测试新版本。
这样可以判断新版本是否真正解决了问题。如果没有 Annotation,这些观察通常只会存在于Slack 聊天记录和会议笔记中,最终无法转化为可复用的评估材料。
将评估和反馈机制融入 Agent 的开发流程和生产周期,不仅可以提升 Agent 的质量,也可以增强其稳定性。一个重要原则是:永远不要将 Agent 推入生产系统,除非你已经建立了评估和反馈机制。
7.5 练习
使用下面的练习来加深你对本章内容的理解:
练习 1:运行基础 TDAD RAG 基准测试
目标:运行初始版本的 RAG Agent,并观察它最开始的基准测试表现(预期会失败)。
任务:
- 打开代码清单 7.1,并保存副本为
exercise1_tdad_baseline.py。 - 运行脚本一次。记录每个 benchmark 的回答结果以及通过/失败状态。
- 再运行两次,检查结果是否存在变化。
- 在文件底部添加一段简短注释,总结三次运行的通过率。
例如:# Run1: 0/5, Run2: 1/5, Run3: 0/5
**预计耗时:**10 分钟
练习 2:重构以提高通过率(工具和 Prompt 调整)
目标:通过优化指令和明确工具使用方式,提高 Agent 的正确率。
任务:
将之前的文件复制为:
exercise2_refactor_rag.py根据代码清单 7.2 更新 Agent 指令。例如添加拆分查询(breaking down the query)的说明,可选地限制回答只能输出单词。
按照代码清单 7.4,重命名并实现 keyword 工具:
search_knowledge_by_keyword,将该工具注册到 Agent 中。固定模型:
model="gpt-5"运行 benchmark 三次,记录每次通过率,在注释中保留表现最好的一次输出样例。目标至少有一次运行达到:
≥ 80%
**预计耗时:**12 分钟
练习 3:添加类型化评估 Agent
目标:使用第二个 Agent 对答案进行评估,并返回类型化的通过/失败结果以及反馈信息。
任务:
将当前文件复制为:
exercise3_evaluation_agent.py按照代码清单 7.5 添加:
EvaluationOutput- evaluation agent
- 按照代码清单 7.6 修改循环逻辑:
调用 evaluator,并打印:
is_correct
feedback
运行一次,然后再次运行,对比两次结果的一致性。
添加注释,总结:
- (a)最终正确数量;
- (b)评估器提供的一条有价值反馈。
**预计耗时:**12 分钟
练习 4:使用输出 Guardrail 强制 Grounding
目标:通过 Grounding Agent 和 Guardrail 阻止没有依据的回答。
任务:
将文件复制为:
exercise4_grounding_guardrail.py按照代码清单 7.7 实现:
get_last_contextGroundedAnswergrounding_agent
添加代码清单 7.9 中的输出 Guardrail 函数,并将其注册到 RAG Agent。
按照代码清单 7.10,包装运行循环,捕获:
OutputGuardrailTripwireTriggered异常。触发 Guardrail 时打印 Guardrail 信息并返回No grounded answer available.运行一次。确认至少一个问题输出:
Guardrail tripped或者确认所有回答都通过 Grounding 检查。
**预计耗时:**15 分钟
练习 5:使用 Phoenix 进行 Trace 和问题分析
目标:使用 Phoenix 捕获 Trace,添加 Metadata,并标记一个 Span。
任务:
将最新文件复制为:
exercise5_phoenix_tracing.py添加代码清单 7.13 中的 Phoenix 配置,设置:
PHOENIX_COLLECTOR_ENDPOINT,清除 Trace Processor:set_trace_processors([]),注册项目project_name="agents",并使用:trace("RAG Benchmarks")包装运行流程。根据代码清单 7.14 添加 Session 和 Metadata,使用:
using_session("sess-07")以及:
using_metadata({
"run_id": "ch7-ex5",
"env": "dev",
"model": "gpt-5"
})
(可选)使用提供的 Docker 命令在本地启动 Phoenix。运行脚本一次。
在 Phoenix 中,进入
Agents project > Traces,根据run_id = ch7-ex5进行过滤。选择任意 LLM Span,并添加 Annotation,例如correctness=pass或者correctness=fail
**预计耗时:**15 分钟
总结
健壮的 Agent 需要从一开始就内置评估和反馈机制。
应将sense-plan-act-learn(感知-规划-行动-学习)循环中的 Learn(学习) 步骤连接到外部评估器、反馈存储系统,以及(可选的)监控/告警反馈 Agent。采用多种评估方法组合,而不是依赖单一评估方式。
红队测试(Red Team Testing)用于发现安全漏洞和失效场景,基准测试(Benchmark Testing)用于衡量任务目标达成情况,人工反馈(Human Feedback,例如点赞和评论)需要结合验证机制以降低偏差,而自动化评估器(Automated Evaluators),例如 Grounding Agent、Critic Agent 和 Evaluation Agent,则可以在适合的场景中自动完成质量评估。测试驱动 Agent 开发(Test-Driven Agent Development,TDAD)会改变传统开发流程。
首先定义基准测试,包括预期失败的案例,然后接受 Agent 初始版本可能无法通过测试这一事实。之后重复运行测试以验证稳定性,再进行最小范围的修改,例如调整 Prompt、工具或模型配置,重新测试,并持续进行迭代和重构。当多个基准测试之间出现冲突时,需要明确做出设计决策。
可以接受部分通过的目标,也可以将能力拆分为多个专用 Agent,并增加任务分流(triage)机制,或者从第一性原理重新设计 Agent 的指令和行为模式。工具相关的指导信息应该优先放在工具名称和文档字符串(docstring)中,而不是堆积在 Prompt 中。
应该使用清晰准确的工具名称,编写明确的工具说明,保持 Prompt 简洁,并让 Prompt 聚焦于 Agent 的角色和职责。为复杂的自然语言输出增加评估 Agent。
评估 Agent 应输出结构化结果,例如通过/失败状态以及具体反馈信息,避免依赖脆弱的字符串匹配方式,从而支持程序化控制流程。Grounding Agent(事实依据验证 Agent)对于 RAG 系统非常重要。
它负责验证 Agent 生成的回答是否真正由提供的上下文信息或引用来源支持。当验证失败时,系统可以选择重新生成回答,使用固定回复进行阻断,或者将验证反馈传递给后续流程。Guardrails(防护机制)是 Grounding 能力的工程化实现方式。
通过输出 Guardrails 包装 Agent,可以检测缺少依据的回答,并生成反馈和标记,然后根据策略执行重试、阻断或添加说明等操作。Rubric(评分量表)能够将主观质量转化为明确的评估标准和等级。
对于图片生成、报告生成、图表生成等高随机性的任务,可以结合 Critic Agent 使用 Rubric,对生成结果进行评价,并循环执行“生成 → 评价 → 改进”的流程,直到达到通过标准或者达到最大尝试次数。由于 LLM 具有随机性,基准测试不仅需要关注准确率,也需要关注稳定性。
测试过程中应该多次运行任务,并观察输出变化、延迟以及 Token 消耗情况。可观测性(Observability)是 Agent 系统不可缺少的能力。
OpenAI Traces 可以记录每一次工具调用和每一轮 LLM 交互过程,而 Arize Phoenix 基于 OpenTelemetry 提供项目管理、Session 管理、指标分析、成本统计、实验管理以及评估能力。需要正确配置 Phoenix 监控体系。
配置过程包括设置 Collector Endpoint,替换默认 Processor,注册 Tracer,并使用具名 Trace 包装 Agent 的运行过程。同时应该附加 Session 信息和 Metadata,以支持后续的数据过滤和用户群体分析。利用运行数据构建数据集,并持续优化 Agent。
可以基于 Span 数据构建数据集,运行实验和评估流程,并通过 Annotation 收集结构化人工反馈,最终将这些反馈信号用于优化 Prompt、工具设计以及系统策略。生产环境原则:永远不要在没有完整评估和反馈闭环的情况下上线 Agent。
一个生产级 Agent 系统需要同时具备评估反馈循环、基准测试体系、Grounding 与 Guardrails 机制、基于 Rubric 的 Critic Agent、完整 Trace 追踪能力,以及持续监控的关键指标,包括延迟、成本和质量。这些能力需要协同工作,才能保证 Agent 在真实生产环境中的可靠运行。